Astra dla ecommerce: eksperyment z katalogiem
Updated 2026-09-05
Oceń, czy Astra może tworzyć użyteczne wielojęzyczne treści produktów, zachowując fakty. Ten szkic definiuje eksperyment; wyniki przypadku czekają na dowody.
Testuj pracę wymagającą oceny
Użyj Astry do pytań, których trudność wynika z kontekstu: terminu produktu o wielu znaczeniach, opisu, który musi zachować zastrzeżenie, lub głosu marki wymagającego naturalnego lokalnego sformułowania. Kopiowanie SKU i formatowanie plików importu pozostaw deterministycznemu kodowi.
OpenAI dokumentuje GPT-6 Astra jako model do złożonego rozumowania i profesjonalnych procesów. Praktyczny eksperyment ecommerce powinien sprawdzić tę możliwość względem własnych reguł akceptacji. Zapytaj, czy wynikowa treść jest akceptowalna i ile korekt wymaga, zamiast zakładać, że ogólna zdolność modelu dowodzi dokładności katalogu.
Zdefiniuj próbkę przed uruchomieniem
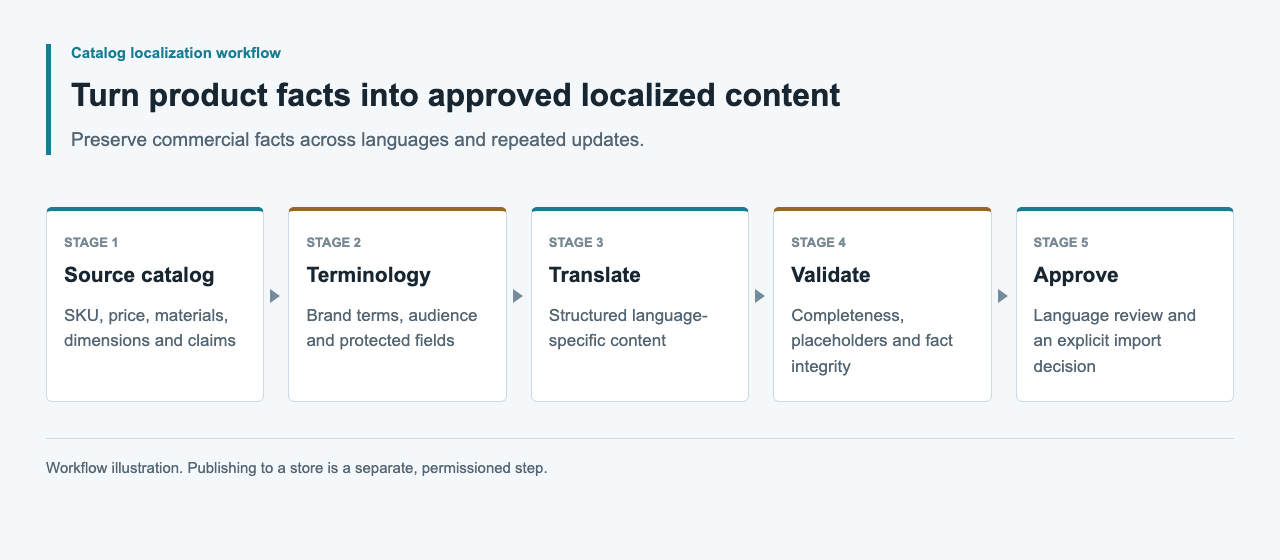
Proponowana próbka zawiera 20 należących do właściciela lub syntetycznych SKU z wersjami docelowymi po angielsku, japońsku i niemiecku. To projekt testu, a nie przetworzony katalog. Uwzględnij różne relacje wariantów, brakujące fakty, chronione terminy marki, miary oraz co najmniej jedno niejednoznaczne stwierdzenie źródłowe.
Dla każdego kandydata użyj tej samej migawki źródła i glosariusza. Zdecyduj, które pola są wymagane i co liczy się jako akceptowalny opis, zanim zobaczysz wynik. Zapisz prawa do źródła i nie wprowadzaj do eksperymentu prawdziwych danych klientów. Próbka ma ujawnić błędy, a nie reprezentować każdą kategorię produktu ani rynek.
Zamroź kontrakt zadania i akceptacji
Poproś o tekst lokalizowany i osobną listę problemów. Zabroń zmian SKU, ceny, waluty, jednostek i tożsamości wariantu. Nieobsługiwane twierdzenia wyklucz ze szkicu i wymagaj zgłoszenia problemu, gdy brakuje specyfikacji. Zachowaj odwołania do źródeł, aby recenzent mógł sprawdzić produkt, a nie pewność modelu.
Poniższy szablon jest przykładowym kontraktem zadania. Można go użyć do przygotowania przyszłego kontrolowanego uruchomienia, zapisując osobno ustawienia modelu i rzeczywisty dostęp. Wszelkie instrukcje dalszej pracy człowieka zachowaj w historii eksperymentu, zamiast niewidocznie dodawać je do początkowego żądania.
Inputs: fixed source catalog, glossary revision, locale brief.
For each product-locale pair, propose title and description.
Use only supported facts; retain qualifications and care warnings.
Return review issues separately from public copy.
Do not edit SKU, price, currency, measurement units or variant IDs.
Do not write to a store or publish any page.
Keep every candidate associated with its source revision.
Uczciwie porównaj role tworzenia szkicu i przeglądu
Jeśli dostęp na to pozwala, oceń Astrę jako autora szkicu i recenzenta w osobnych ramionach eksperymentu. Utrzymuj źródło, glosariusz i reguły akceptacji bez zmian. Silniejszy etap przeglądu jest użyteczny tylko wtedy, gdy wychwytuje istotne wady i nie tworzy nowych, niepopartych zmian.
Dla modelu porównawczego zapisz dokładny dostępny identyfikator i użyj tej samej próbki. W miarę możliwości ukryj tożsamość modelu przed recenzentami redakcyjnymi. Policz zaakceptowane rewizje produkt-locale i kategorie poprawek, a następnie osobno przejrzyj trudne przypadki. Nie ogłaszaj zwycięzcy na podstawie jednego atrakcyjnego akapitu ani długości odpowiedzi.
| Testowana rola | Kontrolowane dane wejściowe | Obserwowalny wynik |
|---|---|---|
| Autor opisu | Zatwierdzone źródło i glosariusz | Wady pierwszego przebiegu i zaakceptowana rewizja |
| Recenzent tłumaczenia | Stały kandydat i fakty źródłowe | Użyteczne ustalenia i błędne zastrzeżenia |
| Asystent rewizji | Zapisane instrukcje recenzenta | Poprawki i nowo wprowadzone wady |
Oddziel kontrole automatyczne od ocen człowieka
Uruchom dokładne porównania dla chronionych pól i rewizji źródeł. Sprawdź wymagane pola wyniku, pokrycie identyfikatorów, liczbę placeholderów i parsowalność znaczników. Wynik poprawny według schematu powinien przejść do przeglądu redakcyjnego, a nie bezpośrednio do importu.
Niech właściciele produktu i języka ocenią twierdzenia, pominięcia, terminologię i naturalność wyrażenia. Każdą poprawkę zapisuj z oryginalnym kandydatem i zaakceptowaną wersją. Nierozstrzygnięte fakty traktuj jako pracę wstrzymaną. Jeśli recenzent ręcznie przepisze treść, zachowaj tę interwencję, aby wynik nie był przedstawiany jako nietknięte wyjście modelu.
Zweryfikuj pakiet importu w sklepie testowym
Przygotuj propozycję importu z aktualnych względem źródła i zaakceptowanych kandydatów. Użyj testowego środowiska WordPress/WooCommerce i potwierdź jego rzeczywisty kontrakt przechowywania wielojęzycznego, zanim zmapujesz języki docelowe. Zachowaj eksport źródła i wcześniejsze wartości pól do porównania.
Po autoryzowanym imporcie testowym zapisz raport importu i porównaj przechowywany tekst, SKU, cenę oraz jednostki z zaakceptowanym pakietem. Przejrzyj locale sklepu i warianty. Wykonuj rzeczywiste zrzuty ekranu testu i oznaczaj środowisko. Wygenerowany CSV, odpowiedź modelu i zapisany wielojęzyczny katalog to różne rezultaty; eksperyment powinien wskazać, które z nich osiągnięto.
Prowadź dziennik kosztów i interwencji
Zapisz tożsamość modelu, ścieżkę dostępu, próby żądań, użycie danych wejściowych i wyjściowych, szczegóły dostępnego cache, opłaty za żądania i czas ręcznej rewizji. Nieudane lub przerwane żądania pozostaw w rejestrze, gdy znane jest ich użycie. Nieznane użycie powinno pozostać puste z podanym powodem, zamiast zmieniać się w zero.
Raportuj wydatek API na zaakceptowaną rewizję produkt-locale tylko wtedy, gdy dziennik jest wystarczająco kompletny i zaakceptowano co najmniej jedną rewizję. Pracę opartą na subskrypcji trzymaj osobno od opłat API i wskaż rzeczywistego dostawcę. Pełny koszt zadania porównuj z obciążeniem redakcyjnym, a nie tylko z ceną pierwszego generowania.
Status dowodów i ograniczenia dostępu
GPT-6 Astra oficjalnie istnieje. Publiczna migawka katalogu APIsRouter z 5 września 2026 r. nie zawierała tego modelu, a ten artykuł nie potwierdza dostępu do Astry przez gateway. Przyszłe uruchomienie musi zapisać rzeczywistą autoryzowaną ścieżkę dostępu i tożsamość modelu; pracę wykonaną przez oficjalny produkt OpenAI należy przypisać temu produktowi.
Ten przypadek pozostaje zablokowany przez brak dowodów: nie są dostępne uruchomienie dla 20 SKU, wielojęzyczne wyniki, decyzje recenzentów, dziennik użycia ani zweryfikowany import sklepu. Nie ma wyników przypadku do zaraportowania. Publikacja jako ukończonego przypadku wymaga tych artefaktów, w tym nieudanych kontroli i interwencji człowieka, a następnie przeglądu źródeł i redakcji.
Częste pytania
Co Astra powinna robić w procesie katalogu?
Oceniaj tworzenie szkicu lub przegląd wymagający kontekstu, na przykład niejednoznaczną terminologię i twierdzenia z zastrzeżeniami. Zachowanie tożsamości i składanie importu pozostaw deterministycznym krokom.
Dlaczego używać stałej próbki?
Stała próbka sprawia, że różnice łatwiej przypisać testowanej konfiguracji. Uwzględnij trudne rekordy i stosuj te same kryteria akceptacji do każdego kandydata.
Jak liczyć ręczne poprawki?
Zachowaj początkowego kandydata, instrukcje recenzenta i zaakceptowaną rewizję. Klasyfikuj poprawki i zapisuj czas, gdy jest mierzony, aby praca człowieka pozostała widoczna w wyniku.
Jak uniknąć faworyzowania jednego modelu w porównaniu?
Utrzymuj źródło, glosariusz i zadania bez zmian, a w miarę możliwości ukryj tożsamość modelu przed recenzentami redakcyjnymi. Porównuj zaakceptowaną pracę i wady według tej samej rubryki.
Jaki jest bieżący status przypadku?
Eksperyment jest zdefiniowany, ale zablokowany przez brak dowodów. Przed uznaniem go za ukończony sprawdź w sekcji dowodów brakujące zapisy uruchomienia i dostępu.