Koszty API Astra: od użycia do zaakceptowanej pracy
Updated 2026-09-05
Rozliczaj osobno zwykłe wejście, odczyty cache, zapisy cache i wyjście. Użyj aktualnego oficjalnego cennika oraz kompletnego rejestru żądań, aby oszacować zadanie.
Wybierz system rozliczeń przed wyborem stawki
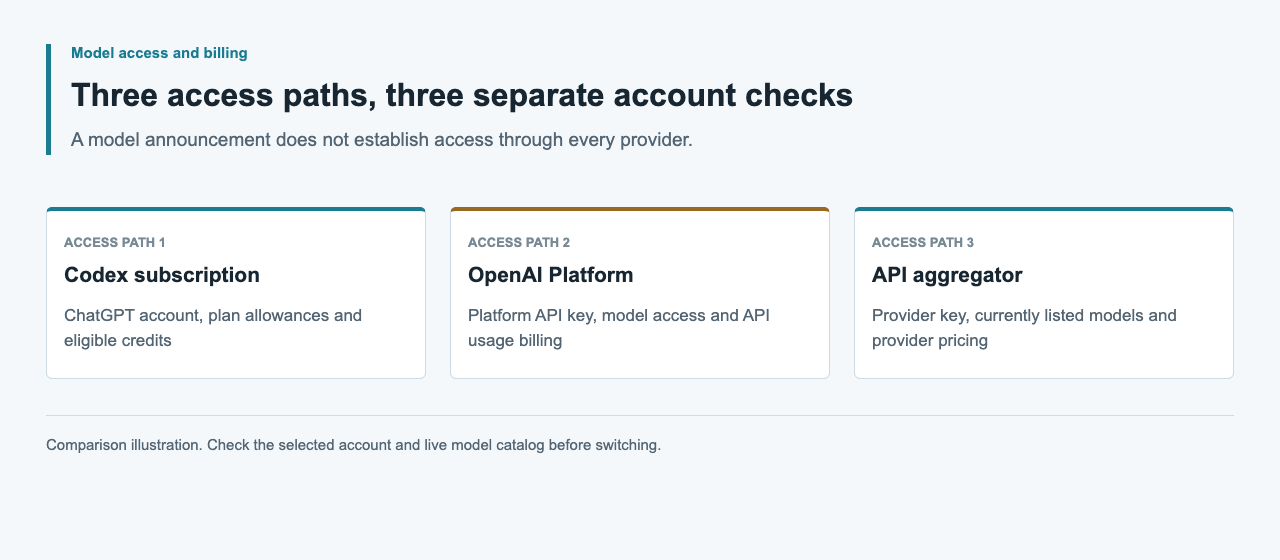
Bezpośrednie żądania API Astra korzystają z rozliczeń OpenAI Platform. Praca Codex uwierzytelniona przez ChatGPT korzysta z limitów i kredytów subskrypcji lub obszaru roboczego. OpenAI publikuje je oddzielnie, więc stawka kredytu Codex nie jest ceną w dolarach za token API, a wliczona tura subskrypcji nie jest rachunkiem API.
W przypadku żądań bezpośrednich otwórz oficjalną stronę cen API i wybierz właściwe stawki gpt-6-astra dla poziomu usługi, przedziału kontekstu i sposobu przetwarzania. Zachowaj URL cennika i datę obserwacji przy szacunku. Zbuduj obliczenie z użycia na poziomie żądania, a następnie porównaj sumę z rejestrem użycia i rachunkiem Platform. Ułatwia to znalezienie różnic w wyborze stawki lub brakujących żądaniach.
Zapisz dokładne pola użycia Responses
Oficjalny przewodnik prompt caching dokumentuje input_tokens, input_tokens_details.cached_tokens i input_tokens_details.cache_write_tokens. Odczyty z cache i zapisy do cache to osobne kategorie wejścia, więc przed obliczeniem zwykłego wejścia odejmij oba. Założenie, że każdy token spoza cache ma zwykłą stawkę wejściową, może zaniżyć koszt żądania zapisującego cache.
Przewodnik dotyczący rozumowania dokumentuje output_tokens i output_tokens_details.reasoning_tokens. Tokeny rozumowania są zawarte w użyciu wyjścia; nie dodawaj ich ponownie jako osobnej kategorii rozliczanych tokenów. Zachowaj total_tokens jako sumę użycia, a nie liczbę do pomnożenia przez jedną stawkę mieszaną. Zapisz pełny obiekt użycia, aby późniejsze uzgodnienie nie zależało od niepełnego logu tekstowego.
| Pole Responses | Znaczenie | Ujęcie księgowe |
|---|---|---|
| Pole usage.input_tokens | Łączna liczba tokenów wejścia | Rozdziel zwykłe wejście, odczyty i zapisy cache |
| Pole usage.input_tokens_details.cached_tokens | Tokeny wejścia z cache | Zastosuj stawkę wejścia z cache |
| Pole usage.input_tokens_details.cache_write_tokens | Tokeny wejścia zapisane w cache | Zastosuj stawkę zapisu do cache |
| Pole usage.output_tokens | Tokeny wyjścia wraz z rozumowaniem | Zastosuj stawkę wyjścia tylko raz |
| Pole usage.output_tokens_details.reasoning_tokens | Rozumowanie zawarte w wyjściu | Zachowaj jako podzbiór diagnostyczny |
| Pole usage.total_tokens | Łączne użycie wejścia i wyjścia | Zachowaj do uzgodnienia |
Oblicz podsumę tokenów bez podwójnego liczenia
Niech I oznacza tokeny wejścia, C wejście z cache, W wejście zapisane do cache, a O tokeny wyjścia. Zwykłe wejście wynosi I - C - W. Przy stawkach R_input, R_cached, R_write i R_output podanych w tej samej walucie za milion tokenów podsumę tokenów oblicza się jako ((I - C - W) * R_input + C * R_cached + W * R_write + O * R_output) / 1,000,000.
Poniższa funkcja offline przyjmuje zaobserwowane użycie i osobno wybrany cennik. Nazwy stawek są zmiennymi aplikacji, a nie polami API. Zwraca null dla brakujących lub niespójnych danych zamiast po cichu traktować nieznane użycie jako bezpłatne. Wynik obejmuje wyłącznie tokeny, nie narzędzia, podatki ani inne pozycje rachunku.
function estimateTokenCost(usage, rates) {
  const I = usage?.input_tokens
  const C = usage?.input_tokens_details?.cached_tokens
  const W = usage?.input_tokens_details?.cache_write_tokens
  const O = usage?.output_tokens
  const tokens = [I, C, W, O]
  const prices = [rates?.input, rates?.cached, rates?.write, rates?.output]
  if (!tokens.every(n => Number.isSafeInteger(n) && n >= 0)) return null
  if (!prices.every(n => Number.isFinite(n) && n >= 0)) return null
  if (C > I || W > I - C) return null
  const subtotal = ((I - C - W) * rates.input
    + C * rates.cached + W * rates.write
    + O * rates.output) / 1_000_000
  return Number.isFinite(subtotal) ? subtotal : null
}
Rozstrzygaj reguły kontekstu i poziomu usługi dla każdego żądania
Oficjalny cennik Astry rozróżnia zwykłe wejście, wejście z cache, zapisy cache i wyjście, a także różne przedziały kontekstu i poziomy usługi. Rozstrzygnij te reguły dla każdego żądania, zanim przekażesz stawki do formuły. Nie stosuj ponownie mnożnika, jeśli wybrany wiersz cennika już go zawiera.
Zachowaj przy odpowiedzi metadane poziomu usługi i przetwarzania oraz porównaj je z tym, co żądano. Nie używaj ponownie mnożników szybkości ani kredytów Codex w bezpośrednim obliczeniu API: należą do innego harmonogramu cen produktu. W przypadku nietypowych sposobów przetwarzania uzgodnij wynik z warunkami właściwego dostawcy. Prawidłowa formuła tokenów z niewłaściwą podstawą stawek nadal daje błędny szacunek kosztu.
Oddziel szacunki tokenów od pełnych kosztów zadania
Zadanie może wymagać wielu żądań modelu, wywołań narzędzi i poprawek. Dodaj podsumę tokenów dla każdego zarejestrowanego żądania, a następnie osobno rozlicz narzędzia lub usługi dostawcy według ich rzeczywistego użycia i ceny. Możliwość wywołania narzędzia przez model nie oznacza, że narzędzie jest wliczone bez dodatkowej opłaty.
Infrastrukturę, koszty generowania zasobów i czas ludzkiej weryfikacji trzymaj w osobnych kategoriach. Dołącz rachunki usług i okres, którego dotyczą, oraz konsekwentnie rozdzielaj koszty wspólne między zadania. W przypadku gry, partii lokalizacyjnej lub zadania badawczego wskaż, jakie elementy obejmuje suma. Oddziel podatki i przeliczenia walut od stawek tokenów, aby uzgodnić zarówno podsumę użycia, jak i końcową zapłaconą kwotę.
| Składnik kosztu | Dowód do zachowania | Zasada łączenia |
|---|---|---|
| Tokeny modelu | Użycie Responses oraz właściwe stawki API | Zsumuj podsumy żądań |
| Narzędzia lub usługi dostawcy | Użycie narzędzia i oficjalna kategoria cenowa | Dodaj pozycje rozliczane osobno |
| Inne zasoby uruchomieniowe lub zasoby gry | Rachunki usług i przypisanie kosztu | Raportuj w osobnych kategoriach |
| Weryfikacja ludzka | Zarejestrowany czas i opisany sposób wyceny | Trzymaj osobno od wydatków API |
Uwzględniaj ponowienia, niepełną pracę i brakujące użycie
Przewodnik OpenAI dotyczący rozumowania ostrzega, że niepełna generacja może zużyć tokeny wejścia i rozumowania bez wytworzenia widocznego tekstu. Licz użycie, które faktycznie zwrócono, nawet gdy wynik nie przejdzie kontroli akceptacji. Nie ograniczaj rejestru do udanych odpowiedzi końcowych ani nie szacuj wydatku wyłącznie na podstawie długości odpowiedzi.
Dla każdej próby zachowaj tożsamość odpowiedzi, model, status, użycie i zadanie, do którego należy. Przed sumowaniem uzgodnij duplikaty. Jeśli połączenie zawiedzie i nie nadejdzie użycie, oznacz próbę jako nierozstrzygniętą do czasu wyjaśnienia przez rejestry dostawcy; nie ustalono ani zerowego kosztu, ani pełnego sukcesu. Ogranicz ponowienia, aby chwilowa usterka nie utworzyła nieprzejrzanej serii płatnych prób.
Budżetuj wokół zaakceptowanych wyników i ograniczonej pracy
Zdefiniuj jednostkę zaakceptowanej pracy przed pomiarem: przetestowaną zmianę kodu, zaakceptowany rekord produktu-locale lub notatkę badawczą powiązaną ze źródłem. Koszt jednostki zaakceptowanej to przypisywalny koszt zadania podzielony przez liczbę zaakceptowanych jednostek, wyłącznie gdy liczba ta jest różna od zera. Raportuj próbę i nierozstrzygnięte użycie obok współczynnika.
Stosuj razem limit żądań, ograniczone ponowienia i warunek zatrzymania zadania. Udokumentowane pole max_output_tokens ogranicza generację, w tym rozumowanie, ale nie jest pełnym budżetem walutowym dla zadania z wieloma żądaniami. Ustaw także kontrole konta i śledź skumulowane wydatki. Mniejszy kontekst lub inne ustawienia rozumowania należy oceniać według tych samych kryteriów akceptacji, a nie reklamować jako gwarantowane oszczędności.
Dostępność dostawcy i dowody: 5 września 2026 r.
Pola użycia i formuła w tym przewodniku pochodzą z oficjalnej dokumentacji OpenAI. Na potrzeby artykułu nie zmierzono kosztu ani czasu wykonania zadania Astra. 5 września 2026 r. publiczny endpoint cenowy APIsRouter zwrócił HTTP 200, success: true i 34 modele bez Astry ani GPT-6, więc nie ma tu wyceny Astry z APIsRouter.
Używaj aktualnych cen OpenAI dla bezpośrednich żądań Astra i katalogu APIsRouter na żywo dla jego własnych ofert. Porównanie dostawców wymaga takich samych zadań, rzeczywistej tożsamości modelu, zaakceptowanych wyników, pełnego użycia i właściwych stawek. Zachowaj te dane przy obliczeniu, aby czytelnicy mogli odróżnić szacunek od uzgodnionego rachunku zadania.
Częste pytania
Jaka jest obecna cena API Astra?
Skorzystaj z oficjalnej strony cen OpenAI API dla gpt-6-astra. Wybierz poziom usługi i przedział kontekstu dotyczące żądania, w tym osobne stawki odczytu i zapisu cache.
Czy tokeny rozumowania są naliczane dodatkowo poza output_tokens?
Tokeny rozumowania są zawarte w użyciu wyjścia. Zastosuj stawkę wyjścia do output_tokens tylko raz, a output_tokens_details.reasoning_tokens zachowaj do diagnozy zamiast dodawać ponownie.
Jak zapisy cache wpływają na formułę?
Odejmij cached_tokens i cache_write_tokens od łącznego wejścia, aby otrzymać zwykłe wejście. Osobno wyceń zwykłe wejście, odczyty cache i zapisy cache, korzystając z odpowiednich oficjalnych stawek.
Czy timeout lub niepełna odpowiedź są bezpłatne?
Niekoniecznie. Niepełna generacja może zużyć tokeny, a timeout może pozostawić nierozstrzygnięte dowody rozliczenia. Zachowaj zwrócone użycie i uzgodnij brakujące rejestry zamiast przypisywać zerowy koszt.
Ile kosztuje zadanie Astra przez APIsRouter?
W sprawdzeniu z 5 września 2026 r. nie było wyceny, ponieważ Astra nie znajdowała się w katalogu. Sprawdź bieżące oferty, a do bezpośrednich szacunków Astry użyj cen OpenAI.