ต้นทุน Astra API จาก usage สู่ผลงานที่ยอมรับ
Updated 2026-09-05
แยก ordinary input, cache read, cache write และ output ออกจากกัน ใช้ rate card official ปัจจุบันกับ request ledger ที่ครบถ้วนเพื่อประเมิน task
เลือกระบบ billing ก่อนเลือก rate
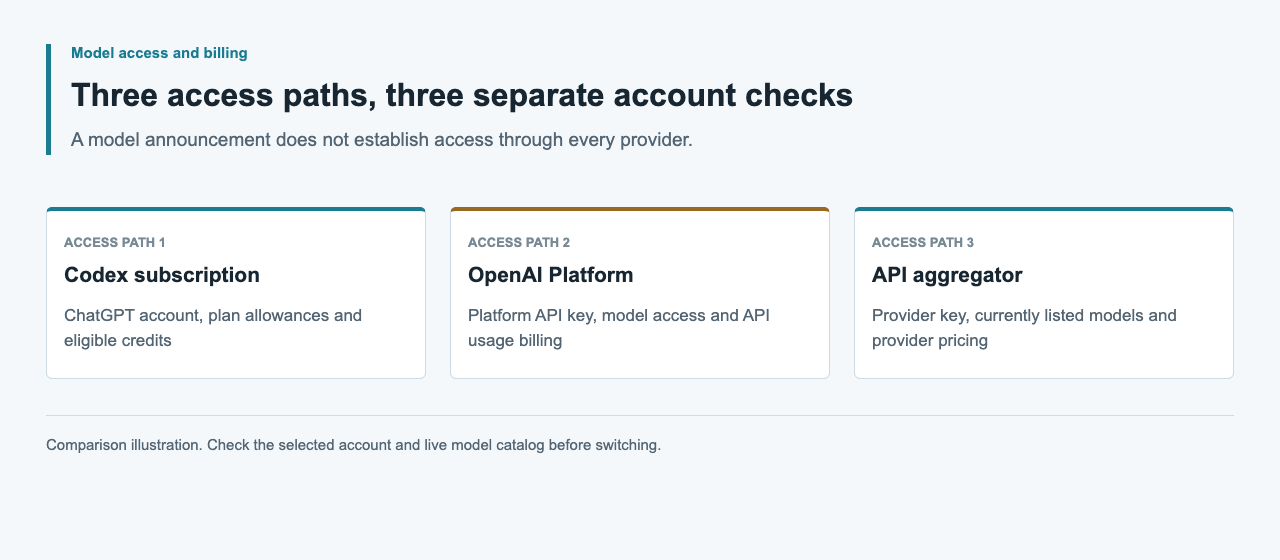
คำขอ Astra API โดยตรงใช้ billing ของ OpenAI Platform งาน Codex ที่ยืนยันตัวตนผ่าน ChatGPT ใช้ subscription หรือ workspace allowance และ credit OpenAI เผยแพร่ข้อมูลเหล่านี้แยกกัน ดังนั้น Codex credit rate ไม่ใช่ราคา dollar ต่อ API token และ subscription turn ที่รวมอยู่ไม่ใช่ API receipt
สำหรับคำขอโดยตรง ให้เปิดหน้า API pricing อย่างเป็นทางการ แล้วเลือก rate ของ gpt-6-astra ให้ตรงกับ service tier, context band และ processing arrangement เก็บ URL ของ rate card กับวันที่สังเกตไว้กับ estimate สร้างการคำนวณจาก usage ระดับ request แล้วเทียบยอดรวมกับ Platform usage record และ bill วิธีนี้ช่วยหาความต่างจากการเลือก rate ผิดหรือ request ที่หายได้ง่ายขึ้น
เก็บ Responses usage field ที่แน่นอน
คู่มือ prompt-caching อย่างเป็นทางการระบุ input_tokens, input_tokens_details.cached_tokens และ input_tokens_details.cache_write_tokens cached read และ cache write เป็นหมวดแยกภายใน input จึงต้องลบทั้งสองออกก่อนคำนวณ ordinary input การสมมติว่า uncached token ทุกตัวใช้ ordinary input rate อาจทำให้ request ที่เขียน cache ถูกประเมินต่ำไป
คู่มือ reasoning ระบุ output_tokens และ output_tokens_details.reasoning_tokens reasoning token รวมอยู่ใน output usage แล้ว อย่าบวกซ้ำเป็นหมวด token ที่คิดเงินอีก เก็บ total_tokens เป็นยอด usage ไม่ใช่จำนวนที่จะคูณด้วย blended rate เดียว เก็บ usage object ฉบับเต็มไว้ เพื่อให้การกระทบยอดภายหลังไม่ต้องพึ่ง text-only log ที่ไม่ครบ
| Responses field | ความหมาย | วิธีบันทึกต้นทุน |
|---|---|---|
| usage.input_tokens | Input token ทั้งหมด | แยก ordinary input, cache read และ cache write |
| usage.input_tokens_details.cached_tokens | Cached input token | ใช้ cached-input rate |
| usage.input_tokens_details.cache_write_tokens | Input token ที่เขียนลง cache | ใช้ cache-write rate |
| usage.output_tokens | Output token รวม reasoning | ใช้ output rate เพียงครั้งเดียว |
| usage.output_tokens_details.reasoning_tokens | Reasoning ที่อยู่ภายใน output | เก็บเป็น diagnostic subset |
| usage.total_tokens | Input และ output usage รวม | เก็บไว้สำหรับกระทบยอด |
คำนวณ token subtotal โดยไม่บวกซ้ำ
ให้ I เป็น input token, C เป็น cached input, W เป็น cache-write input และ O เป็น output token ordinary input คือ I - C - W เมื่อ R_input, R_cached, R_write และ R_output เป็น rate ในสกุลเงินเดียวกันต่อ 1 ล้าน token token subtotal คือ ((I - C - W) * R_input + C * R_cached + W * R_write + O * R_output) / 1,000,000
ฟังก์ชัน offline ด้านล่างรับ observed usage และ rate card ที่เลือกแยกกัน ชื่อ rate เป็น application variable ไม่ใช่ API field ฟังก์ชันคืน null เมื่อ input หายหรือไม่สอดคล้อง แทนการถือว่า usage ที่ไม่ทราบมีต้นทุนเป็นศูนย์ ผลลัพธ์ครอบคลุมเฉพาะ token ไม่รวม tool, tax หรือรายการ billing อื่น
function estimateTokenCost(usage, rates) {
  const I = usage?.input_tokens
  const C = usage?.input_tokens_details?.cached_tokens
  const W = usage?.input_tokens_details?.cache_write_tokens
  const O = usage?.output_tokens
  const tokens = [I, C, W, O]
  const prices = [rates?.input, rates?.cached, rates?.write, rates?.output]
  if (!tokens.every(n => Number.isSafeInteger(n) && n >= 0)) return null
  if (!prices.every(n => Number.isFinite(n) && n >= 0)) return null
  if (C > I || W > I - C) return null
  const subtotal = ((I - C - W) * rates.input
    + C * rates.cached + W * rates.write
    + O * rates.output) / 1_000_000
  return Number.isFinite(subtotal) ? subtotal : null
}
แก้กฎ context และ service tier ต่อ request
ราคา official ของ Astra แยก ordinary input, cached input, cache write และ output พร้อม context band และ service tier ที่ต่างกัน แก้กฎเหล่านี้ต่อ request ก่อนส่ง rate ให้สูตร อย่าใช้ multiplier ซ้ำ หากเลือก rate-card row ที่รวมไว้แล้ว
เก็บ service-tier และ processing metadata ไว้กับ response แล้วเทียบกับสิ่งที่ร้องขอ อย่านำ Codex speed หรือ credit multiplier มาใช้กับการคำนวณ direct API เพราะอยู่ใน product price schedule คนละชุด สำหรับ processing arrangement ที่ไม่ปกติ ให้กระทบยอดกับเงื่อนไขของ provider ที่ใช้ สูตร token ที่ถูกต้องแต่ฐาน rate ผิดก็ยังเป็น estimate ต้นทุนที่ผิด
แยก token estimate ออกจาก task cost ทั้งหมด
task หนึ่งอาจต้องใช้ model request, tool call และ revision หลายครั้ง รวม token subtotal ของแต่ละ request ที่บันทึกไว้ แล้วบวก provider tool หรือ service ที่คิดแยกตาม usage และราคาจริง ความสามารถของโมเดลในการเรียก tool ไม่ได้แปลว่า tool นั้นรวมอยู่โดยไม่คิดเงินเพิ่ม
เก็บ infrastructure ค่าใช้จ่ายสร้าง asset และเวลาของ human review เป็นหมวดแยก แนบ service receipt กับช่วงเวลาที่ครอบคลุม และจัดสรรค่าใช้จ่ายร่วมด้วยวิธีที่สอดคล้องกัน สำหรับเกม localization batch หรือ research task ให้ระบุว่า total รวม component ใด แยก tax และ currency conversion ออกจาก token rate เพื่อกระทบยอดทั้ง usage subtotal และยอดเงินจริงที่จ่าย
| องค์ประกอบต้นทุน | หลักฐานที่ต้องเก็บ | กฎการรวม |
|---|---|---|
| Model token | Responses usage พร้อม API rate ที่ใช้ได้ | รวม subtotal ของแต่ละ request |
| Provider tool หรือ service | Tool usage และหมวดราคาทางการ | บวก item ที่คิดแยก |
| Runtime หรือ asset อื่น | Service receipt และ attribution | รายงานแยกเป็นหมวด |
| Human review | เวลาที่บันทึกและวิธีประเมินมูลค่า | แยกจาก API spend |
ทำให้ retry งานไม่ครบ และ usage ที่หายมองเห็นได้
คู่มือ reasoning ของ OpenAI เตือนว่า generation ที่ไม่ครบอาจใช้ input และ reasoning token โดยไม่สร้างข้อความที่เห็น นับ usage ที่คืนมาจริงแม้ผลลัพธ์จะไม่ผ่าน acceptance check อย่าจำกัด ledger ไว้เฉพาะ final answer ที่สำเร็จ หรือประเมิน spend จากความยาว answer อย่างเดียว
สำหรับ attempt แต่ละตัว เก็บ response identity, model, status, usage และ task ที่สังกัด กระทบยอด duplicate ก่อนรวม หาก connection fail และไม่มี usage เข้ามา ให้ทำเครื่องหมาย attempt เป็น unresolved จนกว่า provider record จะชี้แจง ไม่ควรสรุปทั้ง zero cost หรือ full success จำกัด retry เพื่อไม่ให้ fault ชั่วคราวสร้าง attempt ที่คิดเงินจำนวนมากโดยไม่มีการรีวิว
วาง budget รอบผลลัพธ์ที่ยอมรับและงานที่มีขอบเขต
กำหนดหน่วยของงานที่ยอมรับก่อนวัด เช่น code change ที่ทดสอบแล้ว product-locale record ที่อนุมัติ หรือ research note ที่เชื่อม source Cost per accepted unit คือ attributable task cost หารด้วยจำนวน accepted unit เฉพาะเมื่อจำนวนนั้นไม่เป็นศูนย์ รายงาน sample และ usage ที่ยังไม่คลี่คลายไว้คู่กับ ratio
ใช้ request ceiling, bounded retry และ task stop condition ร่วมกัน field max_output_tokens ตามเอกสารจำกัด generation รวม reasoning แต่ไม่ใช่ currency budget ทั้งหมดของ multi-request task ตั้ง account control และติดตาม spend สะสมด้วย context ที่เล็กลงหรือ reasoning setting อื่นควรประเมินด้วย acceptance criteria เดียวกัน ไม่ควรโฆษณาว่าประหยัดได้แน่นอน
ความพร้อมของ provider และหลักฐาน: September 5, 2026
usage field และสูตรในคู่มือนี้มาจากเอกสาร OpenAI อย่างเป็นทางการ ไม่มีการวัดต้นทุนหรือ runtime ของ Astra task สำหรับบทความนี้ เมื่อ September 5, 2026 public APIsRouter pricing endpoint คืน HTTP 200, success: true และ 34 model โดยไม่มี Astra หรือ GPT-6 จึงไม่มีราคา APIsRouter Astra ในหน้านี้
ใช้ราคา OpenAI ปัจจุบันสำหรับ direct Astra request และใช้ APIsRouter catalog แบบ live สำหรับ offering ของ APIsRouter เอง การเปรียบเทียบ provider ต้องใช้ task ที่ตรงกัน model identity จริง output ที่ยอมรับ usage ครบ และ rate ที่ใช้ได้ เก็บ record เหล่านี้ไว้กับ calculation เพื่อแยก estimate ออกจาก task bill ที่กระทบยอดแล้ว
คำถามที่พบบ่อย
ราคาปัจจุบันของ Astra API คือเท่าไร?
ใช้หน้า API pricing อย่างเป็นทางการของ OpenAI สำหรับ gpt-6-astra เลือก service tier และ context band ที่ตรงกับ request รวม cache-read และ cache-write rate ที่แยกกัน
Reasoning token คิดเงินเพิ่มจาก output_tokens หรือไม่?
Reasoning token รวมอยู่ใน output usage ใช้ output rate กับ output_tokens เพียงครั้งเดียว เก็บ output_tokens_details.reasoning_tokens ไว้วินิจฉัย ไม่ต้องบวกซ้ำ
Cache write กระทบสูตรอย่างไร?
ลบ cached_tokens และ cache_write_tokens จาก input ทั้งหมดเพื่อได้ ordinary input แล้วคิดราคา ordinary input, cache read และ cache write แยกตาม official rate ที่ใช้ได้
Timeout หรือคำตอบที่ไม่ครบไม่มีค่าใช้จ่ายหรือไม่?
ไม่จำเป็น generation ที่ไม่ครบอาจใช้ token และ timeout อาจทิ้ง billing evidence ไว้ unresolved เก็บ usage ที่คืนมาและกระทบยอด record ที่หาย แทนการกำหนดต้นทุนเป็นศูนย์
Task Astra ผ่าน APIsRouter มีต้นทุนเท่าไร?
ไม่มี quote จากการตรวจเมื่อ September 5, 2026 เพราะ Astra ไม่อยู่ใน catalog ตรวจ offering ปัจจุบัน และใช้ราคา OpenAI ประเมิน direct Astra