Astra API cost کو درست طریقے سے calculate کریں
Updated 2026-09-05
ہر request کا usage محفوظ کریں، cache اور reasoning fields کو ایک بار price کریں، اور model tokens کو مکمل task delivery cost سے الگ report کریں۔
پہلے طے کریں کہ آپ کس cost کو measure کر رہے ہیں
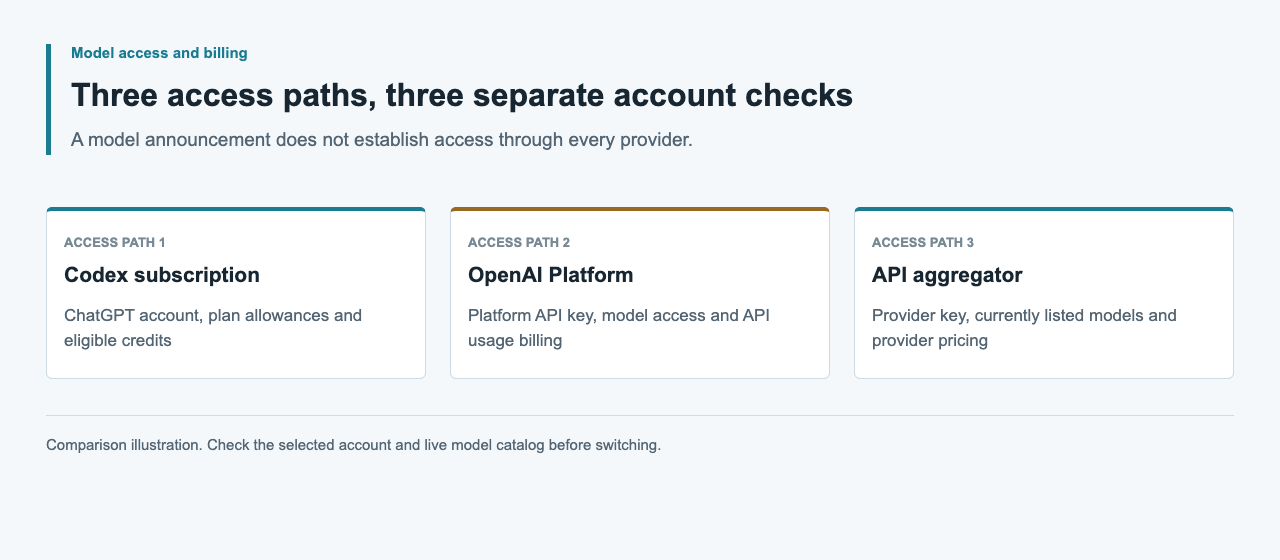
Direct GPT-6 Astra API requests OpenAI Platform billing استعمال کرتی ہیں۔ ChatGPT-authenticated Codex work subscription یا workspace allowances اور credits استعمال کرتی ہے۔ OpenAI انہیں الگ publish کرتا ہے، اس لیے Codex credit rate API token کی dollar price نہیں اور included subscription turn API receipt نہیں۔
Direct requests کے لیے official API pricing page کھولیں اور service tier، context band اور processing arrangement کے مطابق gpt-6-astra rates منتخب کریں۔ Rate-card URL اور observation date estimate کے ساتھ رکھیں۔ Calculation request-level usage سے بنائیں، پھر Platform usage records اور bill سے total compare کریں۔ اس سے rate selection یا missing requests کا فرق تلاش کرنا آسان ہو گا۔
Responses usage کے fields کو صحیح پڑھیں
Official prompt-caching guide input_tokens، input_tokens_details.cached_tokens اور input_tokens_details.cache_write_tokens document کرتی ہے۔ Cached reads اور cache writes input کے اندر الگ categories ہیں، اس لیے ordinary input نکالتے وقت دونوں subtract کریں۔ ہر uncached token پر ordinary input rate فرض کرنا cache لکھنے والی request کی cost کم دکھا سکتا ہے۔
Reasoning guide output_tokens اور output_tokens_details.reasoning_tokens document کرتی ہے۔ Reasoning tokens output usage میں شامل ہیں؛ انہیں دوسری billed category کے طور پر دوبارہ add نہ کریں۔ total_tokens کو usage total سمجھیں، ایک blended rate سے multiply ہونے والا count نہیں۔ Full usage object record کریں تاکہ بعد کی reconciliation incomplete text-only log پر depend نہ کرے۔
| Usage field | اس میں کیا شامل ہے | حساب میں استعمال |
|---|---|---|
| usage.input_tokens | Total input tokens | Cached اور cache-write input نکالیں |
| usage.input_tokens_details.cached_tokens | Cache سے پڑھے گئے input tokens | Cached-input rate لگائیں |
| usage.input_tokens_details.cache_write_tokens | Cache میں لکھے گئے input tokens | Cache-write rate لگائیں |
| usage.output_tokens | Reasoning سمیت output tokens | Output rate ایک بار لگائیں |
| usage.output_tokens_details.reasoning_tokens | Output کے اندر reasoning | Diagnostic subset کے طور پر محفوظ کریں |
| usage.total_tokens | کل input اور output usage | Reconciliation کے لیے رکھیں |
Double counting کے بغیر token subtotal نکالیں
I کو input tokens، C کو cached input، W کو cache-write input اور O کو output tokens سمجھیں۔ Ordinary input I - C - W ہوگا۔ اگر rates اسی currency میں فی million tokens R_input، R_cached، R_write اور R_output ہیں تو token subtotal ((I - C - W) * R_input + C * R_cached + W * R_write + O * R_output) / 1,000,000 ہے۔
نیچے والا offline function observed usage اور الگ منتخب rate card لیتا ہے۔ اس کے rate names application variables ہیں، API fields نہیں۔ Missing یا inconsistent inputs پر null واپس کریں، unknown usage کو خاموشی سے free نہ سمجھیں۔ یہ result صرف tokens cover کرتا ہے، tools، taxes یا دوسرے bill items نہیں۔
function estimateTokenCost(usage, rates) {
  const I = usage?.input_tokens
  const C = usage?.input_tokens_details?.cached_tokens
  const W = usage?.input_tokens_details?.cache_write_tokens
  const O = usage?.output_tokens
  const tokens = [I, C, W, O]
  const prices = [rates?.input, rates?.cached, rates?.write, rates?.output]
  if (!tokens.every(n => Number.isSafeInteger(n) && n >= 0)) return null
  if (!prices.every(n => Number.isFinite(n) && n >= 0)) return null
  if (C > I || W > I - C) return null
  const subtotal = ((I - C - W) * rates.input
    + C * rates.cached + W * rates.write
    + O * rates.output) / 1_000_000
  return Number.isFinite(subtotal) ? subtotal : null
}
ہر request کے لیے context اور service-tier rules resolve کریں
Astra کی official pricing ordinary input، cached input، cache writes اور output کو الگ rates اور context bands کے ساتھ distinguish کرتی ہے۔ Formula میں rates دینے سے پہلے ہر request کے لیے یہ rules resolve کریں۔ اگر multiplier شامل rate-card row منتخب کر چکے ہیں تو اسے دوبارہ apply نہ کریں۔
Response کے ساتھ service-tier اور processing metadata رکھیں اور اسے requested settings سے compare کریں۔ Direct API calculation میں Codex speed یا credit multipliers reuse نہ کریں؛ وہ الگ product schedule سے تعلق رکھتے ہیں۔ غیر معمولی processing arrangement کو applicable provider terms سے reconcile کریں۔ غلط rate basis کے ساتھ صحیح formula بھی غلط cost estimate ہے۔
Token estimate کو مکمل task cost سے الگ رکھیں
ایک task میں کئی model requests، tool calls اور revisions ہو سکتی ہیں۔ ہر recorded request کا token subtotal جمع کریں، پھر provider tools یا services کی actual usage اور pricing کے مطابق الگ charges شامل کریں۔ Model کا tool call کر سکنا اس بات کا ثبوت نہیں کہ tool کی cost شامل ہے۔
Infrastructure، asset-generation expenses اور human review time الگ categories میں رکھیں۔ Service receipts اور ان کا وقت محفوظ کریں اور shared costs کو مستقل طریقے سے allocate کریں۔ Game، localization batch یا research task کے لیے واضح کریں کہ total میں کون سے components شامل ہیں۔ Taxes اور currency conversion کو token rates سے الگ رکھیں تاکہ subtotal اور final payment دونوں reconcile ہو سکیں۔
| Cost component | Evidence محفوظ کریں | Combination rule |
|---|---|---|
| Model tokens | Responses usage اور applicable API rates | Request subtotals جمع کریں |
| Provider tools یا services | Tool usage اور official pricing category | Separately billed items شامل کریں |
| Other runtime یا assets | Service receipts اور attribution | الگ categories میں report کریں |
| Human review | Recorded time اور valuation method | API spend سے الگ رکھیں |
Retries، incomplete work اور missing usage نمایاں رکھیں
OpenAI reasoning guide خبردار کرتی ہے کہ incomplete generation input اور reasoning tokens خرچ کر سکتی ہے، چاہے visible text نہ ملے۔ Acceptance check fail ہونے پر بھی returned usage count کریں۔ Ledger کو صرف کامیاب final answers تک محدود نہ کریں اور answer length سے spend کا اندازہ نہ لگائیں۔
ہر attempt کے لیے response identity، model، status، usage اور task محفوظ کریں۔ Sum کرنے سے پہلے duplicates reconcile کریں۔ Connection fail ہو اور usage نہ آئے تو provider records واضح ہونے تک attempt کو unresolved رکھیں؛ zero cost یا full success میں سے کوئی بات ثابت نہیں۔ Retries bounded رکھیں تاکہ temporary fault billable attempts کا بے نظر سلسلہ نہ بنائے۔
Accepted results اور bounded work کے اردگرد budget بنائیں
Cost measure کرنے سے پہلے accepted work کی unit define کریں: tested code change، approved product-locale record یا source-linked research note۔ Cost per accepted unit attributable task cost کو accepted-unit count سے divide کر کے نکلتی ہے، اور count nonzero ہونا چاہیے۔ Ratio کے ساتھ sample اور unresolved usage بھی report کریں۔
Request ceiling، bounded retries اور task stop condition ساتھ استعمال کریں۔ Documented max_output_tokens reasoning سمیت generation کو محدود کرتا ہے، مگر multi-request task کے لیے مکمل currency budget نہیں ہے۔ Account controls بھی set کریں اور accumulated spend track کریں۔ چھوٹا context یا دوسری reasoning setting صرف اسی acceptance criteria کے خلاف evaluate کریں، guaranteed saving کے طور پر نہ بیچیں۔
Provider availability اور evidence: 5 ستمبر 2026
اس guide کے usage fields اور formula official OpenAI documentation سے لیے گئے ہیں۔ Article کے لیے کوئی Astra task cost یا runtime measure نہیں کیا گیا۔ 5 ستمبر 2026 کو public APIsRouter pricing endpoint نے HTTP 200، success: true اور 34 models واپس کیے، مگر Astra یا GPT-6 نہیں تھی، اس لیے یہاں APIsRouter Astra quote موجود نہیں۔
Direct Astra requests کے لیے OpenAI کی current pricing اور اپنی offerings کے لیے live APIsRouter catalog استعمال کریں۔ Provider comparison میں matching tasks، actual model identity، accepted outputs، complete usage اور applicable rates چاہییں۔ Calculation کے ساتھ records رکھیں تاکہ estimate اور reconciled task bill الگ دکھائی دیں۔
عمومی سوالات
Astra API کی موجودہ price کیا ہے؟
gpt-6-astra کے لیے official OpenAI API pricing page دیکھیں۔ اپنی request کے service tier اور context band منتخب کریں، اور cache-read اور cache-write rates الگ رکھیں۔
کیا reasoning tokens output_tokens کے علاوہ charge ہوتے ہیں؟
Reasoning tokens output usage کے اندر شامل ہوتے ہیں۔ output_tokens پر output rate ایک بار لگائیں؛ output_tokens_details.reasoning_tokens کو diagnosis کے لیے رکھیں، دوبارہ add نہ کریں۔
Cache writes formula پر کیا اثر ڈالتی ہیں؟
Ordinary input حاصل کرنے کے لیے total input سے cached_tokens اور cache_write_tokens نکالیں۔ Ordinary input، cache reads اور cache writes کو متعلقہ official rates سے الگ price کریں۔
کیا timeout یا incomplete answer free ہوتی ہے؟
ضروری نہیں۔ Incomplete generation tokens خرچ کر سکتی ہے اور timeout billing evidence کو unresolved چھوڑ سکتا ہے۔ Returned usage رکھیں اور missing records reconcile کریں، zero cost فرض نہ کریں۔
APIsRouter کے ذریعے Astra task کی price کتنی ہے؟
5 ستمبر 2026 کی check میں Astra catalog میں نہیں تھی، اس لیے quote موجود نہیں۔ Current offerings چیک کریں؛ direct Astra estimate کے لیے OpenAI pricing استعمال کریں۔