Custos da API do Astra, do uso ao trabalho aceito
Updated 2026-09-05
Contabilize separadamente entrada comum, leituras de cache, gravações em cache e saída. Use a tabela de tarifas oficial atual e um registro completo de solicitações para estimar uma tarefa.
Escolha o sistema de cobrança antes de escolher uma tarifa
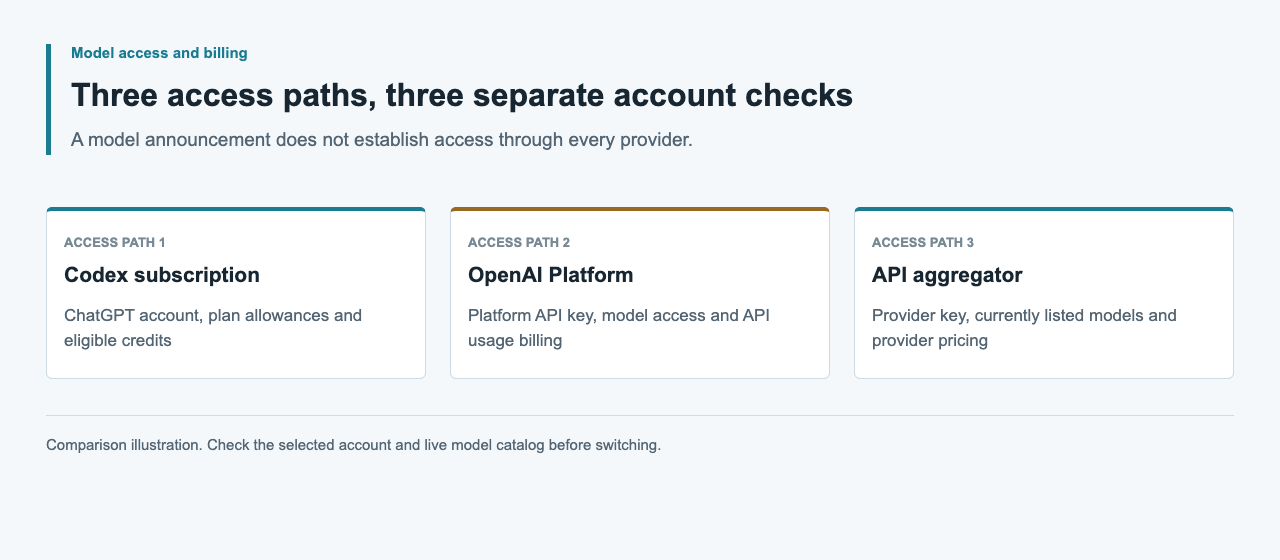
Solicitações diretas à API do Astra usam o faturamento da OpenAI Platform. O trabalho do Codex autenticado pelo ChatGPT usa franquias e créditos de assinatura ou workspace. A OpenAI publica esses itens separadamente; portanto, uma tarifa de crédito do Codex não é um preço em dólares por token de API, e um turno incluído na assinatura não é um recibo da API.
Para solicitações diretas, abra a página oficial de preços da API e selecione as tarifas de gpt-6-astra aplicáveis ao nível de serviço, faixa de contexto e modalidade de processamento. Mantenha a URL da tabela de tarifas e a data da observação junto da estimativa. Faça o cálculo a partir do uso por solicitação e depois compare o total com os registros de uso e a fatura da Platform. Assim fica mais fácil localizar diferenças na escolha da tarifa ou solicitações ausentes.
Capture os campos exatos de uso de Responses
O guia oficial de cache de prompts documenta input_tokens, input_tokens_details.cached_tokens e input_tokens_details.cache_write_tokens. Leituras de cache e gravações em cache são categorias separadas dentro da entrada; subtraia ambas antes de calcular a entrada comum. Assumir que todo token sem cache usa a tarifa de entrada comum pode subestimar uma solicitação que grava um cache.
O guia de raciocínio documenta output_tokens e output_tokens_details.reasoning_tokens. Tokens de raciocínio estão incluídos no uso de saída; não os some novamente como outra categoria faturada. Mantenha total_tokens como um total de uso, não como uma quantidade à qual se aplica uma única tarifa combinada. Registre o objeto usage completo para que a reconciliação posterior não dependa de um log incompleto somente de texto.
| Campo de Responses | Significado | Tratamento contábil |
|---|---|---|
| usage.input_tokens | Total de tokens de entrada | Separe entrada comum, leituras e gravações de cache |
| usage.input_tokens_details.cached_tokens | Tokens de entrada em cache | Aplique a tarifa de entrada em cache |
| usage.input_tokens_details.cache_write_tokens | Tokens de entrada gravados no cache | Aplique a tarifa de gravação em cache |
| usage.output_tokens | Tokens de saída incluindo raciocínio | Aplique a tarifa de saída uma vez |
| usage.output_tokens_details.reasoning_tokens | Raciocínio dentro da saída | Mantenha como subconjunto de diagnóstico |
| usage.total_tokens | Uso total de entrada e saída | Mantenha para reconciliação |
Calcule o subtotal de tokens sem contar duas vezes
Seja I o número de tokens de entrada, C a entrada em cache, W a entrada gravada no cache e O os tokens de saída. A entrada comum é I - C - W. Com as tarifas R_input, R_cached, R_write e R_output cotadas na mesma moeda por milhão de tokens, o subtotal de tokens é ((I - C - W) * R_input + C * R_cached + W * R_write + O * R_output) / 1,000,000.
A função offline abaixo aceita o uso observado e uma tabela de tarifas selecionada separadamente. Seus nomes de tarifas são variáveis da aplicação, não campos da API. Ela retorna null para entradas ausentes ou inconsistentes, em vez de tratar silenciosamente o uso desconhecido como gratuito. O resultado cobre apenas tokens, não ferramentas, impostos ou outros itens da fatura.
function estimateTokenCost(usage, rates) {
  const I = usage?.input_tokens
  const C = usage?.input_tokens_details?.cached_tokens
  const W = usage?.input_tokens_details?.cache_write_tokens
  const O = usage?.output_tokens
  const tokens = [I, C, W, O]
  const prices = [rates?.input, rates?.cached, rates?.write, rates?.output]
  if (!tokens.every(n => Number.isSafeInteger(n) && n >= 0)) return null
  if (!prices.every(n => Number.isFinite(n) && n >= 0)) return null
  if (C > I || W > I - C) return null
  const subtotal = ((I - C - W) * rates.input
    + C * rates.cached + W * rates.write
    + O * rates.output) / 1_000_000
  return Number.isFinite(subtotal) ? subtotal : null
}
Resolva as regras de contexto e nível de serviço por solicitação
Os preços oficiais do Astra distinguem entrada comum, entrada em cache, gravações em cache e saída, com diferentes faixas de contexto e níveis de serviço. Resolva essas regras para cada solicitação antes de fornecer tarifas à fórmula. Não aplique um multiplicador novamente se já tiver selecionado uma linha da tabela que o inclua.
Mantenha metadados de nível de serviço e processamento junto da resposta e compare-os com o que foi solicitado. Não reutilize multiplicadores de velocidade ou crédito do Codex em um cálculo de API direta: eles pertencem a outra tabela de preços de produto. Para modalidades incomuns de processamento, reconcilie com os termos aplicáveis do provedor. Uma fórmula correta de tokens com uma base de tarifa errada continua sendo uma estimativa de custo incorreta.
Separe estimativas de tokens dos custos completos da tarefa
Uma tarefa pode exigir várias solicitações de modelo, chamadas de ferramentas e revisões. Some o subtotal de tokens de cada solicitação registrada e depois adicione ferramentas ou serviços do provedor cobrados separadamente conforme o uso e o preço reais. A capacidade de um modelo chamar uma ferramenta não significa que essa ferramenta esteja incluída sem custo adicional.
Mantenha infraestrutura, despesas de geração de ativos e tempo de revisão humana em categorias separadas. Anexe recibos de serviços e o período que cobrem e aloque custos compartilhados de forma consistente entre as tarefas. Para um jogo, lote de localização ou tarefa de pesquisa, declare quais componentes o total inclui. Separe impostos e conversões de moeda das tarifas de tokens para reconciliar tanto o subtotal de uso quanto o valor final pago.
| Componente de custo | Evidência a preservar | Regra de combinação |
|---|---|---|
| Tokens do modelo | Uso de Responses mais tarifas aplicáveis da API | Some os subtotais das solicitações |
| Ferramentas ou serviços do provedor | Uso da ferramenta e categoria de preço oficial | Adicione itens cobrados separadamente |
| Outro runtime ou ativos | Recibos de serviço e atribuição | Informe em categorias separadas |
| Revisão humana | Tempo registrado e método de avaliação declarado | Mantenha separado do gasto da API |
Mantenha visíveis as tentativas, o trabalho incompleto e o uso ausente
O guia de raciocínio da OpenAI alerta que uma geração incompleta pode consumir tokens de entrada e de raciocínio sem produzir texto visível. Conte o uso efetivamente retornado mesmo quando o resultado falha na verificação de aceitação. Não restrinja o registro a respostas finais bem-sucedidas nem estime o gasto apenas pelo tamanho da resposta.
Para cada tentativa, conserve identidade da resposta, modelo, status, uso e a tarefa à qual pertence. Reconcilie duplicatas antes de somar. Se uma conexão falhar e nenhum uso chegar, marque a tentativa como não resolvida até que os registros do provedor a esclareçam; não está estabelecido nem custo zero nem sucesso completo. Limite as tentativas para que uma falha temporária não crie uma série não revisada de tentativas faturáveis.
Faça o orçamento em torno de resultados aceitos e trabalho limitado
Defina a unidade de trabalho aceito antes de medi-la: uma alteração de código testada, um registro de produto-locale aprovado ou uma nota de pesquisa ligada a fontes. O custo por unidade aceita é o custo atribuível da tarefa dividido pela quantidade de unidades aceitas, somente quando essa quantidade não é zero. Informe a amostra e o uso não resolvido junto da proporção.
Use em conjunto um teto de solicitações, tentativas limitadas e uma condição de parada da tarefa. O campo documentado max_output_tokens limita a geração, incluindo raciocínio, mas não é um orçamento monetário completo para uma tarefa com várias solicitações. Configure controles da conta e acompanhe também o gasto acumulado. Contexto menor ou configurações diferentes de raciocínio devem ser avaliados com os mesmos critérios de aceitação, não anunciados como economia garantida.
Disponibilidade do provedor e evidências: 5 de setembro de 2026
Os campos de uso e a fórmula deste guia vêm da documentação oficial da OpenAI. Nenhum custo ou runtime de tarefa do Astra foi medido para o artigo. Em 5 de setembro de 2026, o endpoint público de preços da APIsRouter retornou HTTP 200, success: true e 34 modelos sem Astra ou GPT-6; portanto, não há uma cotação de Astra da APIsRouter aqui.
Use os preços atuais da OpenAI para solicitações diretas do Astra e o catálogo ao vivo da APIsRouter para suas próprias ofertas. Uma comparação de provedores precisa de tarefas equivalentes, identidade real do modelo, saídas aceitas, uso completo e tarifas aplicáveis. Mantenha esses registros junto do cálculo para que os leitores distingam uma estimativa de uma fatura reconciliada de tarefa.
Perguntas frequentes
Qual é o preço atual da API do Astra?
Use a página oficial de preços da API da OpenAI para gpt-6-astra. Selecione o nível de serviço e a faixa de contexto aplicáveis à sua solicitação, incluindo tarifas separadas para leitura e gravação em cache.
Os tokens de raciocínio são cobrados além de output_tokens?
Tokens de raciocínio estão incluídos no uso de saída. Aplique a tarifa de saída a output_tokens uma vez e mantenha output_tokens_details.reasoning_tokens para diagnóstico, sem somá-los novamente.
Como as gravações em cache afetam a fórmula?
Subtraia cached_tokens e cache_write_tokens da entrada total para obter a entrada comum. Precifique separadamente entrada comum, leituras de cache e gravações em cache usando as tarifas oficiais aplicáveis.
Um timeout ou uma resposta incompleta é gratuito?
Não necessariamente. Uma geração incompleta pode consumir tokens, e um timeout pode deixar a evidência de cobrança sem resolução. Mantenha o uso retornado e reconcilie registros ausentes em vez de atribuir custo zero.
Quanto custa uma tarefa do Astra pela APIsRouter?
Não há cotação na verificação de 5 de setembro de 2026 porque o Astra estava ausente do catálogo. Consulte as ofertas atuais e use os preços da OpenAI para estimativas diretas do Astra.