Astra สำหรับ ecommerce: การทดลอง catalog
Updated 2026-09-05
ประเมินว่า Astra สร้าง product content หลายภาษาที่มีประโยชน์พร้อมรักษา fact ได้หรือไม่ ฉบับร่างนี้กำหนดการทดลอง ส่วนผลลัพธ์ของเคสยังรอหลักฐาน
ทดสอบงานที่ต้องใช้วิจารณญาณ
ใช้ Astra กับคำถามที่ยากเพราะต้องเข้าใจบริบท เช่น term ของสินค้าที่มีหลายความหมาย description ที่ต้องรักษา qualification หรือ brand voice ที่ต้องใช้สำนวนท้องถิ่นอย่างเป็นธรรมชาติ เก็บการคัดลอก SKU และการจัดรูปแบบ import file ไว้ในโค้ดแบบ deterministic
OpenAI อธิบาย GPT-6 Astra ว่าเหมาะกับ reasoning ที่ซับซ้อนและ workflow ระดับมืออาชีพ การทดลอง ecommerce ที่ใช้ได้จริงควรทดสอบ capability นั้นกับ acceptance rule ของคุณเอง ถามว่า copy ที่ได้ยอมรับได้หรือไม่และต้องแก้มากเพียงใด แทนการสมมติว่า capability ทั่วไปของโมเดลพิสูจน์ความถูกต้องของ catalog
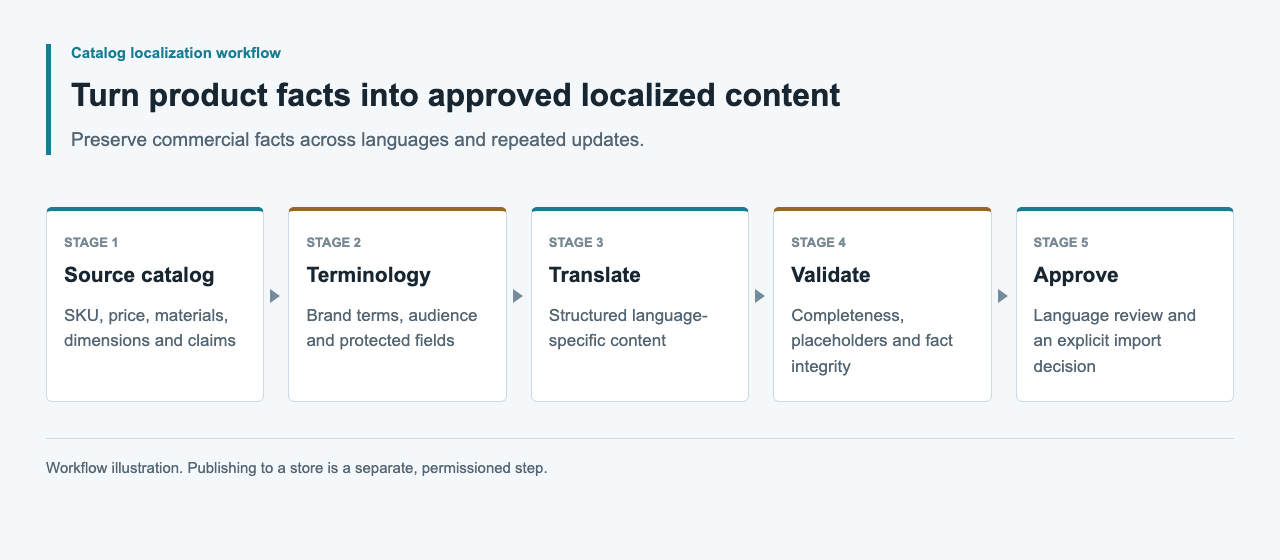
กำหนด sample ก่อนรัน
sample ที่เสนอมี SKU ที่เป็นของคุณเองหรือ synthetic 20 รายการ พร้อม target version ภาษาอังกฤษ Japanese และ German นี่คือ test design ไม่ใช่ catalog ที่ผ่านการประมวลผล ใส่ variant relationship ที่แตกต่างกัน fact ที่หาย protected brand term measurement และ source statement ที่กำกวมอย่างน้อย 1 รายการ
ใช้ source snapshot และ glossary เดียวกันกับ candidate ทุกตัว ตัดสินใจว่า field ใดจำเป็นและ description แบบใดยอมรับได้ก่อนเห็น output บันทึกสิทธิ์ของ source และอย่าใส่ข้อมูลลูกค้าจริงลงในการทดลอง sample นี้มีไว้เปิดเผยข้อผิดพลาด ไม่ใช่เป็นตัวแทนของ product category หรือตลาดทุกแบบ
ตรึง task และ approval contract
ขอ localized text และ issue list แยกกัน ห้ามเปลี่ยน SKU, price, currency, unit และ variant identity เก็บ claim ที่ไม่มีหลักฐานออกจาก draft และกำหนดให้สร้าง review issue เมื่อ specification หาย เก็บ source reference ไว้ เพื่อให้ reviewer ตรวจสินค้าได้ ไม่ใช่ตรวจ confidence ของโมเดล
Template ด้านล่างเป็น task contract ตัวอย่าง ใช้เตรียม controlled run ในอนาคตได้ โดยบันทึก model setting และ access จริงแยกกัน เก็บคำแนะนำ follow-up ของมนุษย์เป็นส่วนหนึ่งของ experiment history แทนการผนวกเข้ากับ request แรกแบบมองไม่เห็น
Inputs: fixed source catalog, glossary revision, locale brief.
For each product-locale pair, propose title and description.
Use only supported facts; retain qualifications and care warnings.
Return review issues separately from public copy.
Do not edit SKU, price, currency, measurement units or variant IDs.
Do not write to a store or publish any page.
Keep every candidate associated with its source revision.
เปรียบเทียบบทบาท drafting และ review อย่างยุติธรรม
ประเมิน Astra เป็น drafter และ reviewer ใน experimental arm แยกกัน หากมีสิทธิ์ ให้ source glossary และ acceptance rule คงที่ทั้งหมด review step ที่แข็งแรงกว่าจะมีประโยชน์ก็ต่อเมื่อจับ defect ที่เกี่ยวข้องได้โดยไม่สร้างการเปลี่ยนแปลงใหม่ที่ไม่มีหลักฐาน
สำหรับ comparison model ให้บันทึก ID ที่มีอยู่จริงแบบ exact และใช้ sample เดียวกัน ปกปิด model identity จาก editorial reviewer เมื่อทำได้ นับ product-locale revision ที่ยอมรับและหมวด correction แล้วตรวจเคสยากทีละรายการ อย่าประกาศผู้ชนะจากย่อหน้าที่ดูดีเพียงหนึ่งย่อหน้า หรือจากความยาวของ response
| บทบาทที่ทดสอบ | Input ที่ควบคุม | ผลลัพธ์ที่สังเกตได้ |
|---|---|---|
| Description drafter | Approved source และ glossary | Defect รอบแรกและ revision ที่ยอมรับ |
| Translation reviewer | Candidate ที่ตรึงไว้และ source fact | Finding ที่มีประโยชน์และ objection ที่ผิด |
| Revision assistant | คำแนะนำของ reviewer ที่บันทึกไว้ | Correction และ defect ที่เพิ่งถูกนำเข้ามา |
แยก automated check ออกจาก human judgment
รันการเปรียบเทียบแบบ exact สำหรับ protected field และ source revision ตรวจ required output field, identifier coverage, placeholder count และ markup ที่ parse ได้ ผลลัพธ์ที่ผ่าน schema ควรไป editorial review ไม่ใช่ตรงไป import
ให้ product reviewer และ language reviewer ประเมิน claim omission terminology และสำนวนที่เป็นธรรมชาติ บันทึก correction แต่ละข้อพร้อม candidate เดิมและ version ที่ยอมรับ ถือ fact ที่ยังไม่คลี่คลายเป็นงานที่พักไว้ หาก reviewer เขียน copy ใหม่ด้วยมือ ให้เก็บ intervention นั้นไว้ เพื่อไม่ให้นำเสนอผลลัพธ์ว่าเป็น output จากโมเดลที่ไม่ถูกแตะต้อง
ตรวจ import package ใน test store
เตรียม import proposal จาก candidate ที่อนุมัติและ source ยังเป็นปัจจุบัน ใช้ WordPress/WooCommerce environment สำหรับทดสอบ และยืนยัน multilingual storage contract จริงก่อน map target language เก็บ source export และค่าฟิลด์ก่อนหน้าไว้เปรียบเทียบ
หลัง authorized test import ให้บันทึก import report และเทียบ text, SKU, price และ unit ที่จัดเก็บกับ package ที่อนุมัติ ตรวจ storefront locale และ variant เก็บ screenshot จาก test จริงพร้อมติดป้าย environment CSV ที่สร้างขึ้น model answer และ catalog หลายภาษาที่จัดเก็บแล้วเป็น deliverable คนละแบบ การทดลองควรบอกว่าสิ่งใดสำเร็จแล้ว
เก็บ cost และ intervention ledger
บันทึก model identity, access path, request attempt, input และ output usage, cache detail ที่มี charge ต่อ request และเวลาที่แก้ด้วยมือ เก็บ request ที่ล้มเหลวหรือถูกขัดจังหวะไว้เมื่อรู้ usage แล้ว usage ที่ไม่ทราบควรเว้นว่างพร้อมเหตุผล แทนการกลายเป็นศูนย์
รายงาน API spend ต่อ accepted product-locale revision เฉพาะเมื่อ ledger ครบพอและมีอย่างน้อย 1 revision ที่ยอมรับ แยกงานแบบ subscription ออกจาก API charge และระบุ provider ที่ใช้จริง เปรียบเทียบ task cost ทั้งหมดกับภาระ editorial ไม่ใช่แค่ต้นทุน generation ครั้งแรก
สถานะหลักฐานและข้อจำกัดการเข้าถึง
GPT-6 Astra มีอยู่จริงอย่างเป็นทางการ public APIsRouter catalog snapshot เมื่อ September 5, 2026 ไม่ได้แสดงรายการนี้ และบทความนี้ไม่ได้พิสูจน์การเข้าถึง Astra ผ่าน gateway run ในอนาคตต้องบันทึก access path ที่ได้รับอนุญาตจริงและ model identity หากงานทำผ่านผลิตภัณฑ์ OpenAI อย่างเป็นทางการ ต้องระบุ attribution ให้ผลิตภัณฑ์นั้น
เคสนี้ยังติดข้อจำกัดด้านหลักฐาน: ไม่มี 20-SKU run, multilingual output, reviewer decision, usage ledger หรือ verified store import ให้ใช้รายงาน ไม่มีผลลัพธ์เคสที่จะนำเสนอ การเผยแพร่เป็นเคสที่เสร็จแล้วต้องมี artifact เหล่านี้ รวม failed check และ human intervention ตามด้วย source กับ editorial review
คำถามที่พบบ่อย
Astra ควรทำอะไรใน catalog workflow?
ประเมินงาน drafting หรือ review ที่ต้องใช้บริบท เช่น terminology ที่กำกวมและ claim ที่มี qualification เก็บ identity preservation และ import assembly ไว้ในขั้นตอน deterministic
ทำไมต้องใช้ sample ที่ตรึงไว้?
sample ที่คงที่ทำให้ตีความความแตกต่างว่าเกิดจาก configuration ที่ทดสอบได้ง่ายขึ้น ใส่ record ที่ยากและใช้ acceptance criteria เดียวกันกับ candidate ทุกตัว
ควรนับ manual correction อย่างไร?
เก็บ candidate แรก คำแนะนำของ reviewer และ revision ที่ยอมรับ จัดประเภท correction และบันทึกเวลาเมื่อวัดได้ เพื่อให้งานของมนุษย์ยังมองเห็นในผลลัพธ์
เปรียบเทียบโดยไม่ลำเอียงเข้าข้างโมเดลหนึ่งได้อย่างไร?
คง source glossary และ task ให้เหมือนกัน และปกปิด model identity จาก editorial reviewer เมื่อทำได้ เปรียบเทียบงานที่ยอมรับกับ defect ภายใต้ rubric เดียวกัน
สถานะปัจจุบันของเคสคืออะไร?
การทดลองถูกกำหนดไว้แล้วแต่ยังติดข้อจำกัดด้านหลักฐาน ดูส่วน evidence สำหรับ run และ access record ที่หายก่อนถือว่าเป็นเคสที่เสร็จ