Fluxos de pesquisa quantitativa com IA
Updated 2026-09-06
Use agentes para propor e implementar hipóteses e deixe dados versionados e experimentos reproduzíveis avaliá-las. Mantenha conversa do modelo e computação numérica distintas.
Transforme uma ideia em um experimento falseável
Escreva o mecanismo que deseja testar, as variáveis observáveis, o universo pretendido e as condições que rejeitariam a ideia. Um agente pode ajudar a traduzir essa especificação em código, mas não deve redefinir o critério de sucesso depois de ver os resultados. Separe perguntas de implementação de perguntas de pesquisa: um fator pode ser calculado corretamente e ainda não conter sinal útil. Salve uma especificação pequena antes da primeira solicitação de geração de código para que o experimento final possa ser comparado à intenção original.
Escolha o papel correto de RD-Agent, Qlib e FinRL
O RD-Agent automatiza partes do desenvolvimento de pesquisa, incluindo implementação iterativa e feedback. O Qlib fornece um fluxo quantitativo para dados, modelos e avaliação. O FinRL fornece ambientes de pesquisa de aprendizado por reforço. Esses projetos podem informar etapas diferentes, mas não são clientes de chat intercambiáveis. Solicitações de LLM pertencem à camada de raciocínio e programação do agente. Construção de features, treinamento, simulação e métricas consomem computação no ambiente do experimento. Registre os dois caminhos para que um orçamento de modelo não seja confundido com o orçamento completo de recursos.
| Componente | Trabalho principal | O que você deve fornecer |
|---|---|---|
| Agente de pesquisa | Hipótese, implementação, revisão | Contrato da tarefa e ferramentas permitidas |
| Qlib | Dados, treinamento, sinal e avaliação de portfólio | Conjunto de dados compatível e configuração do experimento |
| FinRL | Treinamento de política em ambiente de mercado | Ambiente, definição de recompensa e desenho de avaliação |
| Revisor humano | Metodologia e interpretação | Critérios de aceitação independentes |
Corrija o contrato de dados antes de gerar fatores
Documente identidade do instrumento, fusos horários, política de ajuste, calendário e tratamento de valores ausentes. Para pesquisa de ações dos EUA, use um conjunto de dados e configuração de região apropriados; mudar um rótulo em um exemplo de outro mercado não migra suas premissas. Preserve composição histórica do universo e timestamps de publicação para features fundamentais ou textuais. Normalize e ajuste transformações somente nos dados de desenvolvimento permitidos. Uma feature calculada a partir de uma reapresentação posterior pode vazar informação futura mesmo quando seu período contábil parece pertencer ao passado.
Use a estrutura oficial do fluxo como limite de execução
A interface qrun documentada do Qlib executa um fluxo configurado de dados, modelo e avaliação e registra artefatos. Forneça uma configuração revisada em vez de pedir a um agente que improvise todo o ambiente em runtime. O comando abaixo é o padrão oficial de invocação; o nome do arquivo representa sua própria configuração completa. Valide caminho do conjunto de dados, região, universo de instrumentos, benchmark e segmentos train/validation/test antes da execução. Uma pequena verificação de carregamento de dados deve falhar claramente se o histórico ou os campos necessários estiverem indisponíveis.
# Requires an installed Qlib environment and a reviewed configuration.
qrun configuration.yaml
Inspecione o artefato completo do experimento
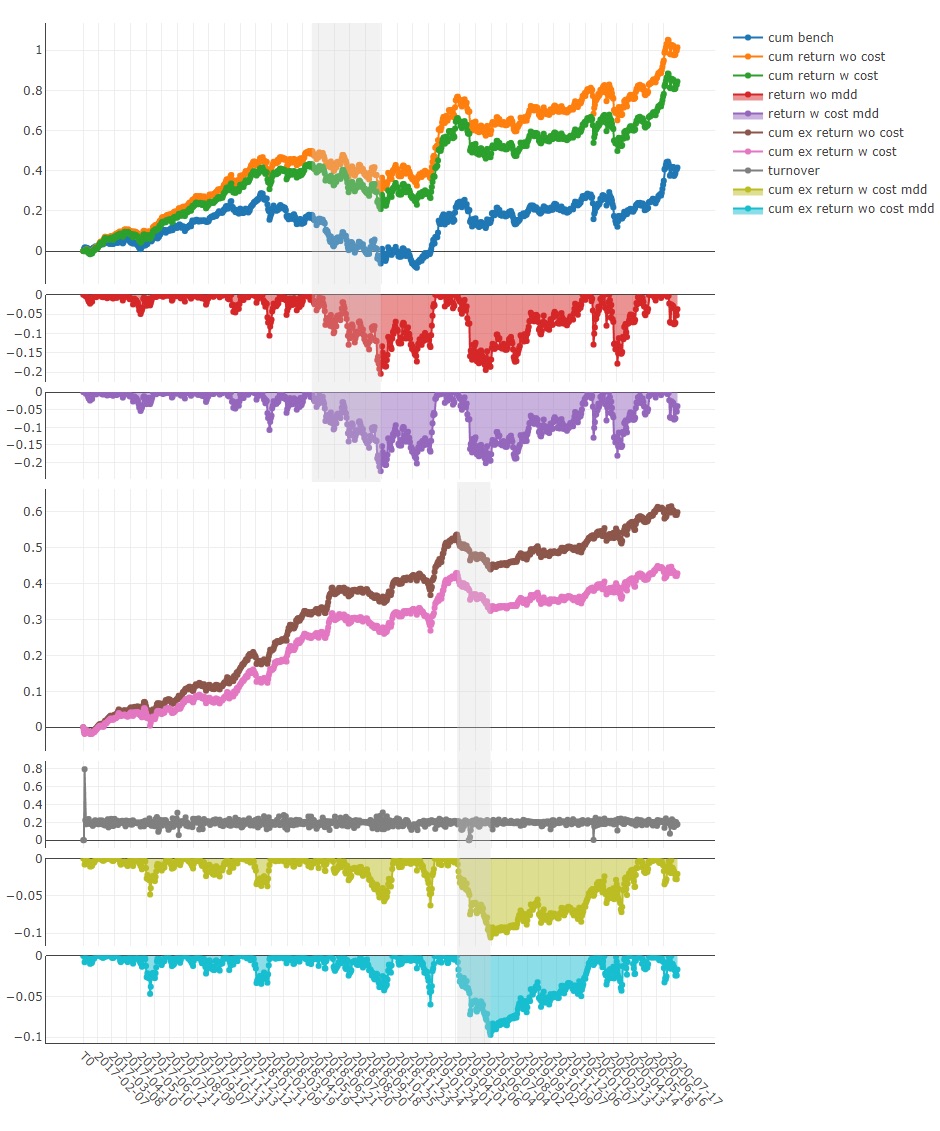
Mantenha juntos código candidato, configuração, identidade do ambiente, seed quando relevante, manifesto de dados e saídas registradas. Inspecione risco, turnover e contexto do benchmark além de qualquer resultado principal. A figura oficial do Qlib ilustra os tipos de análise que um fluxo quantitativo pode expor. É um exemplo service, não um resultado deste guia. Um gráfico só é útil quando os trades ou sinais subjacentes, premissas de entrada e período de avaliação podem ser inspecionados, incluindo intervalos desfavoráveis.
Controle o processo de busca e o ambiente de execução
Dê ao código gerado um ambiente descartável e limitado em recursos, com apenas os conjuntos de dados e ferramentas necessários. Revise acesso à rede, montagens de arquivos e exposição de segredos antes da execução. Limite o número de revisões candidatas e preserve experimentos rejeitados. Se um agente usar repetidamente uma pontuação holdout para melhorar o código, essa pontuação virou feedback de desenvolvimento. Reserve uma janela de avaliação realmente intocada ou outro desenho de avaliação predeclarado. Compare candidatos com uma linha de base adequada e registre toda decisão de seleção, não apenas a implementação final.
Faça orçamento separado para trabalho do modelo e computação
Acompanhe geração de hipóteses, revisões de código, embeddings e tentativas do modelo em um registro de solicitações. Acompanhe treinamento, simulação, armazenamento e acesso a dados em um registro separado de recursos unido pelo ID do experimento. Um cache local pode reduzir trabalho repetido, mas precisa ser indexado por identidade do código e dos dados; caso contrário, pode retornar resultado de outro candidato. Pare quando o orçamento de iterações ou computação for atingido. Resuma a descoberta mais bem sustentada e a incerteza restante, em vez de deixar o agente procurar indefinidamente um resultado favorável.
Evidências e escopo
Este passo a passo usa as fontes oficiais de RD-Agent, Qlib e FinRL vinculadas abaixo. O padrão de configuração e a figura service são apoiados por fontes; nenhum loop RD-Agent, execução de treinamento Qlib, política FinRL ou retorno financeiro foi executado ou medido para esta página. Use o guia RD-Agent vinculado para configuração específica da versão do modelo e mantenha um registro de execução separado ao conduzir seu próprio experimento.
Perguntas frequentes
O Qlib precisa de uma chave de API de LLM?
Seu fluxo quantitativo central não precisa. Um agente de pesquisa conectado pode precisar de credenciais de chat ou embedding, enquanto o Qlib executa o trabalho numérico configurado.
Quando o FinRL é mais adequado que um fluxo de fatores?
Quando a pergunta de pesquisa envolve aprendizado de política sequencial em um ambiente definido. O ambiente e o desenho da recompensa se tornam partes centrais do experimento.
O agente pode escolher o período de teste?
Um revisor deve aprovar os limites da avaliação antes do desenvolvimento. Permitir que o agente escolha períodos favoráveis depois de ver os resultados enfraquece o experimento.
O que torna um fator gerado reproduzível?
Código preservado, versão dos dados, calendário e regras de ajuste, versões de dependências, estado de pré-processamento e configuração completa da avaliação.
O que faço quando o código gerado falha?
Mantenha o código e as evidências estruturadas da falha, corrija a menor etapa afetada em uma nova versão do experimento e preserve a tentativa original no histórico de busca.