เวิร์กโฟลว์วิจัยเชิงปริมาณด้วย AI
Updated 2026-09-06
ให้ agent เสนอและทำ hypothesis แล้วให้ข้อมูลที่มีเวอร์ชันกับการทดลองที่ทำซ้ำได้เป็นผู้ประเมิน แยกบทสนทนาของโมเดลออกจากการคำนวณเชิงตัวเลข
เปลี่ยนไอเดียให้เป็นการทดลองที่หักล้างได้
เขียนกลไกที่ต้องการทดสอบ ตัวแปรที่สังเกตได้ universe ที่ตั้งใจใช้ และเงื่อนไขที่จะทำให้ไอเดียถูกปฏิเสธ agent ช่วยแปลง specification เป็นโค้ดได้ แต่ไม่ควรนิยามเกณฑ์ความสำเร็จใหม่หลังเห็นผลลัพธ์ แยกคำถามด้าน implementation ออกจากคำถามด้านวิจัย เพราะ factor ที่คำนวณถูกต้องก็ยังอาจไม่มี signal ที่เป็นประโยชน์ เก็บ specification ขนาดเล็กก่อนคำขอ code-generation ครั้งแรก เพื่อเปรียบเทียบการทดลองสุดท้ายกับเจตนาเดิมได้
เลือกบทบาทที่ถูกต้องของ RD-Agent, Qlib และ FinRL
RD-Agent ทำให้บางส่วนของการพัฒนาวิจัยเป็นอัตโนมัติ รวมถึง implementation แบบวนซ้ำและ feedback Qlib จัดหาเวิร์กโฟลว์เชิงปริมาณสำหรับข้อมูล โมเดล และ evaluation FinRL จัดหา environment สำหรับงาน reinforcement learning โปรเจกต์เหล่านี้ช่วยคนละ stage แต่ใช้แทนกันไม่ได้เหมือน chat client คำขอ LLM อยู่ในชั้น reasoning และ coding ของ agent ส่วนการสร้าง feature การ train การจำลอง และ metric ใช้ compute ใน environment ของการทดลอง บันทึกทั้งสองเส้นทาง เพื่อไม่ให้เข้าใจว่า model budget คือ resource budget ทั้งหมด
| Component | งานหลัก | สิ่งที่คุณต้องจัดหา |
|---|---|---|
| Research agent | Hypothesis, implementation, revision | Task contract และเครื่องมือที่อนุญาต |
| Qlib | การประเมิน data, training, signal และ portfolio | Dataset และ experiment configuration ที่เข้ากันได้ |
| FinRL | ฝึก policy ใน market environment | Environment, reward definition และ evaluation design |
| Human reviewer | Methodology และการตีความ | เกณฑ์การยอมรับที่เป็นอิสระ |
แก้ data contract ก่อนสร้าง factor
บันทึก identity ของตราสาร timezone นโยบายการปรับราคา calendar และการจัดการ missing value สำหรับงานวิจัยหุ้นสหรัฐฯ ให้ใช้ dataset ของสหรัฐฯ และ region configuration ที่เหมาะสม การเปลี่ยน label ในตัวอย่างคนละตลาดไม่ได้ย้าย assumptions ของตัวอย่างนั้นมา เก็บ membership ของ historical universe และ timestamp ที่เผยแพร่ไว้สำหรับ feature เชิงพื้นฐานหรือข้อความ Normalize และ fit transformation บน development data ที่อนุญาตเท่านั้น feature ที่คำนวณจาก restatement ในภายหลังอาจรั่วไหลข้อมูลอนาคต แม้งวดบัญชีจะดูเหมือนอยู่ในอดีตก็ตาม
ใช้โครงสร้าง official workflow เป็นขอบเขตการรัน
interface qrun ที่ Qlib จัดทำเอกสารไว้จะรัน workflow ของ data model และ evaluation ที่ตั้งค่าแล้ว พร้อมบันทึก artifact ส่ง configuration ที่ผ่านการรีวิว แทนการขอให้ agent คิด environment ทั้งหมดขึ้นเองตอน runtime คำสั่งด้านล่างคือรูปแบบ invocation อย่างเป็นทางการ filename เป็นตัวแทน configuration ฉบับสมบูรณ์ของคุณ ตรวจ dataset path, region, instrument universe, benchmark และช่วง train/validation/test ก่อนรัน data-loading check ขนาดเล็กควรล้มเหลวอย่างชัดเจนหาก history หรือ field ที่ต้องใช้ไม่มีอยู่
# Requires an installed Qlib environment and a reviewed configuration.
qrun configuration.yaml
ตรวจ artifact ของการทดลองให้ครบถ้วน
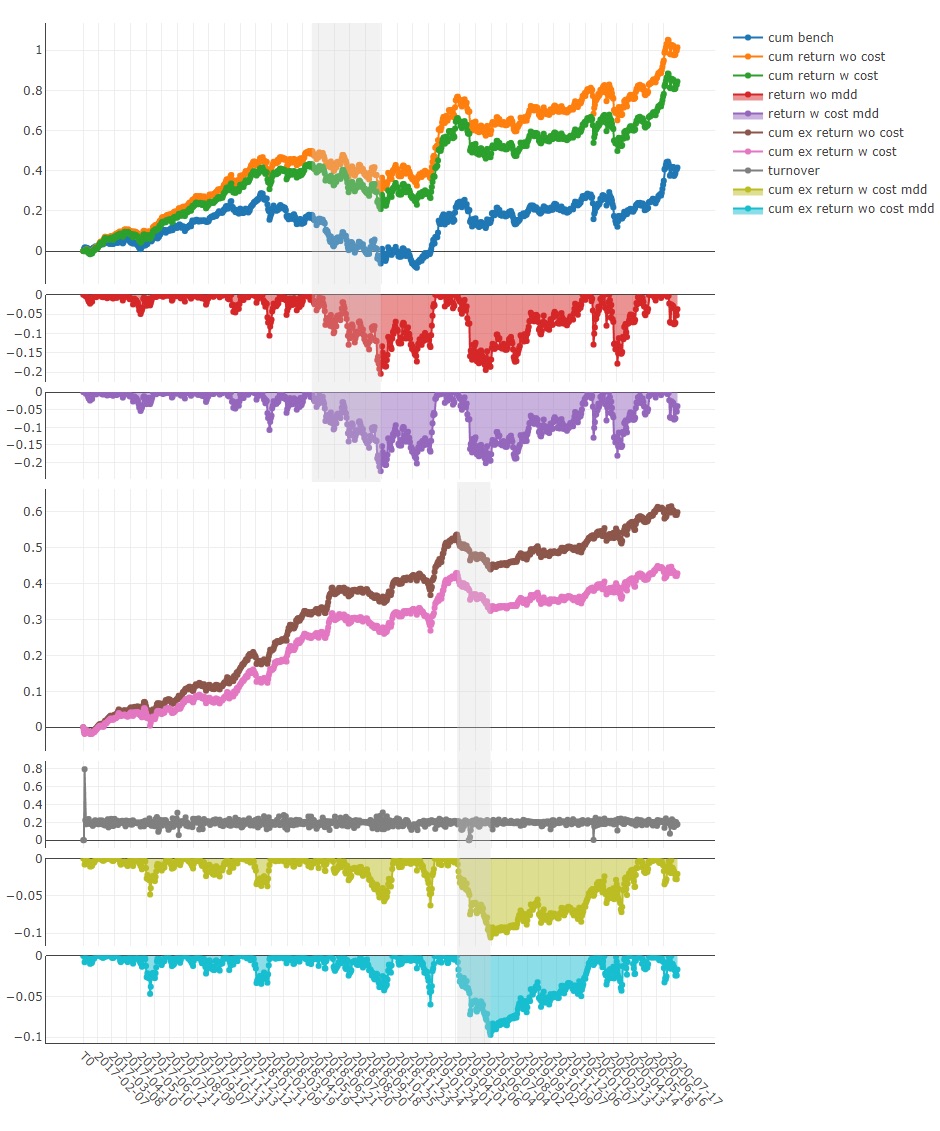
เก็บ candidate code, configuration, identity ของ environment, seed เมื่อเกี่ยวข้อง, data manifest และ output ที่บันทึกไว้ด้วยกัน ตรวจ risk, turnover และบริบทของ benchmark รวมถึงผลลัพธ์ headline รูป Qlib อย่างเป็นทางการแสดงประเภทการวิเคราะห์ที่ workflow เชิงปริมาณเปิดเผยได้ แต่เป็นเพียงตัวอย่างจาก service ไม่ใช่ผลจากคู่มือนี้ chart มีประโยชน์เมื่อสามารถตรวจ trades หรือ signals ต้นทาง assumptions ของ input และช่วง evaluation ได้ รวมถึงช่วงเวลาที่ผลไม่ดี
ควบคุมกระบวนการค้นหาและ environment ที่ใช้รัน
ให้โค้ดที่สร้างขึ้นรันใน environment ชั่วคราวที่จำกัดทรัพยากร โดยมีเฉพาะ dataset และเครื่องมือที่จำเป็น รีวิว network access, file mount และการเปิดเผย secret ก่อนรัน จำกัดจำนวน candidate revision และเก็บการทดลองที่ถูกปฏิเสธไว้ หาก agent ใช้ score ที่กันไว้เพื่อปรับโค้ดซ้ำๆ score นั้นก็กลายเป็น feedback สำหรับ development แล้วกันช่วง evaluation ที่ไม่เคยแตะจริง หรือใช้ evaluation design อื่นที่ประกาศไว้ล่วงหน้า เปรียบเทียบ candidate กับ baseline ที่เหมาะสมและบันทึกการตัดสินใจเลือกทุกครั้ง ไม่ใช่เฉพาะ implementation สุดท้าย
แยกงบงานโมเดลออกจากงบการคำนวณ
ติดตามการสร้าง hypothesis, code revision, embedding และ model retry ใน request ledger ติดตาม training, simulation, storage และ data access ใน resource ledger แยก แล้วเชื่อมด้วย experiment ID cache ภายในเครื่องลดงานซ้ำได้ แต่ต้องใช้ code และ data identity เป็น key มิฉะนั้นอาจคืนผลจาก candidate อื่น หยุดเมื่อถึง iteration หรือ compute budget สรุป finding ที่มีหลักฐานรองรับที่สุดและความไม่แน่นอนที่เหลือ แทนการปล่อยให้ agent ค้นหาผลลัพธ์ที่ดูดีไปเรื่อยๆ
หลักฐานและขอบเขต
บทความนี้อิงแหล่งข้อมูลทางการของ RD-Agent, Qlib และ FinRL ที่ลิงก์ไว้ รูปแบบ configuration และรูป service มีแหล่งข้อมูลรองรับ แต่หน้านี้ไม่ได้รันหรือวัด RD-Agent loop, Qlib training run, FinRL policy หรือผลตอบแทนทางการเงิน ใช้คู่มือ RD-Agent ที่ลิงก์ไว้สำหรับ model configuration ตามเวอร์ชัน และเก็บ execution record แยกเมื่อรันการทดลองของคุณเอง
คำถามที่พบบ่อย
Qlib ต้องใช้ LLM API key หรือไม่?
workflow เชิงปริมาณหลักของ Qlib ไม่ต้องใช้ research agent ที่ต่อเพิ่มอาจต้องใช้ credential สำหรับ chat หรือ embedding ขณะที่ Qlib ทำงานเชิงตัวเลขตาม configuration
FinRL เหมาะกว่า factor workflow เมื่อใด?
เมื่อคำถามวิจัยเกี่ยวกับการเรียนรู้ policy แบบลำดับใน environment ที่กำหนดไว้ การออกแบบ environment และ reward จึงกลายเป็นส่วนหลักของการทดลอง
ให้ agent เลือกช่วง test ได้หรือไม่?
ผู้รีวิวควรอนุมัติขอบเขต evaluation ก่อน development การให้ agent เลือกช่วงที่ได้เปรียบหลังเห็นผลลัพธ์ทำให้การทดลองอ่อนแอลง
อะไรทำให้ factor ที่สร้างขึ้นทำซ้ำได้?
เก็บ code, data version, calendar และกฎ adjustment, dependency version, สถานะ preprocessing และ evaluation configuration ฉบับเต็ม
เมื่อโค้ดที่สร้างขึ้นล้มเหลวควรทำอย่างไร?
เก็บโค้ดและหลักฐานความล้มเหลวแบบมีโครงสร้าง แก้เฉพาะ stage ที่ได้รับผลกระทบใน experiment version ใหม่ และเก็บความพยายามเดิมไว้ใน search history