Процеси кількісного дослідження за допомогою AI
Updated 2026-09-06
Використовуйте агентів для пропозиції та реалізації гіпотез, а потім дозвольте версіонованим даним і відтворюваним експериментам оцінити їх. Розділяйте розмову з моделлю та числові обчислення.
Перетворіть ідею на фальсифікований експеримент
Запишіть механізм, який хочете перевірити, спостережувані змінні, передбачений універсум і умови, що відкинуть ідею. Агент може допомогти перетворити специфікацію на код, але не має перевизначати критерій успіху після перегляду результатів. Відокремлюйте питання реалізації від дослідницьких питань: фактор можна правильно обчислити й усе одно не отримати корисного сигналу. Збережіть невелику специфікацію до першого запиту на генерацію коду, щоб майбутній експеримент можна було порівняти з початковим задумом.
Оберіть правильну роль для RD-Agent, Qlib і FinRL
RD-Agent автоматизує частини розвитку дослідження, включно з ітеративною реалізацією та зворотним зв’язком. Qlib надає кількісний процес для даних, моделей і оцінювання. FinRL надає середовища дослідження з reinforcement learning. Ці проєкти можуть підтримувати різні етапи, але вони не є взаємозамінними чат-клієнтами. Запити LLM належать шару міркування й кодування агента. Побудова ознак, навчання, симуляція та метрики споживають обчислення в середовищі експерименту. Записуйте обидва шляхи, щоб бюджет моделі не сприймався як повний ресурсний бюджет.
| Компонент | Основна робота | Що ви маєте надати |
|---|---|---|
| Дослідницький агент | Гіпотеза, реалізація, ревізія | Контракт завдання та дозволені інструменти |
| Qlib | Дані, навчання, сигнал та оцінювання портфеля | Сумісний набір даних і конфігурація експерименту |
| FinRL | Навчання політики в ринковому середовищі | Середовище, визначення винагороди та дизайн оцінювання |
| Людський рецензент | Методологія та інтерпретація | Незалежні критерії прийняття |
Виправте контракт даних до генерації факторів
Задокументуйте ідентичність інструмента, часові пояси, політику коригування, календар і обробку пропущених значень. Для дослідження акцій США використовуйте відповідний набір даних США та конфігурацію регіону; зміна ярлика в прикладі іншого ринку не переносить його припущення. Зберігайте історичний склад універсуму та часові мітки публікації для фундаментальних або текстових ознак. Нормалізуйте й підганяйте перетворення лише на дозволених даних розробки. Ознака, обчислена з пізнішого переглянутого звіту, може пропустити майбутню інформацію, навіть коли її обліковий період виглядає минулим.
Використовуйте офіційну структуру процесу як межу виконання
Задокументований інтерфейс qrun Qlib виконує налаштований процес даних, моделі та оцінювання й записує артефакти. Надавайте перевірену конфігурацію, а не просіть агента імпровізувати все середовище під час виконання. Наведена нижче команда є офіційним шаблоном виклику; ім’я файла позначає вашу повну конфігурацію. До виконання перевірте шлях до набору даних, регіон, універсум інструментів, бенчмарк і сегменти train/validation/test (навчання, перевірки та тесту). Невелика перевірка завантаження даних має чітко завершуватися помилкою, якщо потрібна історія або поля недоступні.
# Requires an installed Qlib environment and a reviewed configuration.
qrun configuration.yaml
Перевіряйте повний артефакт експерименту
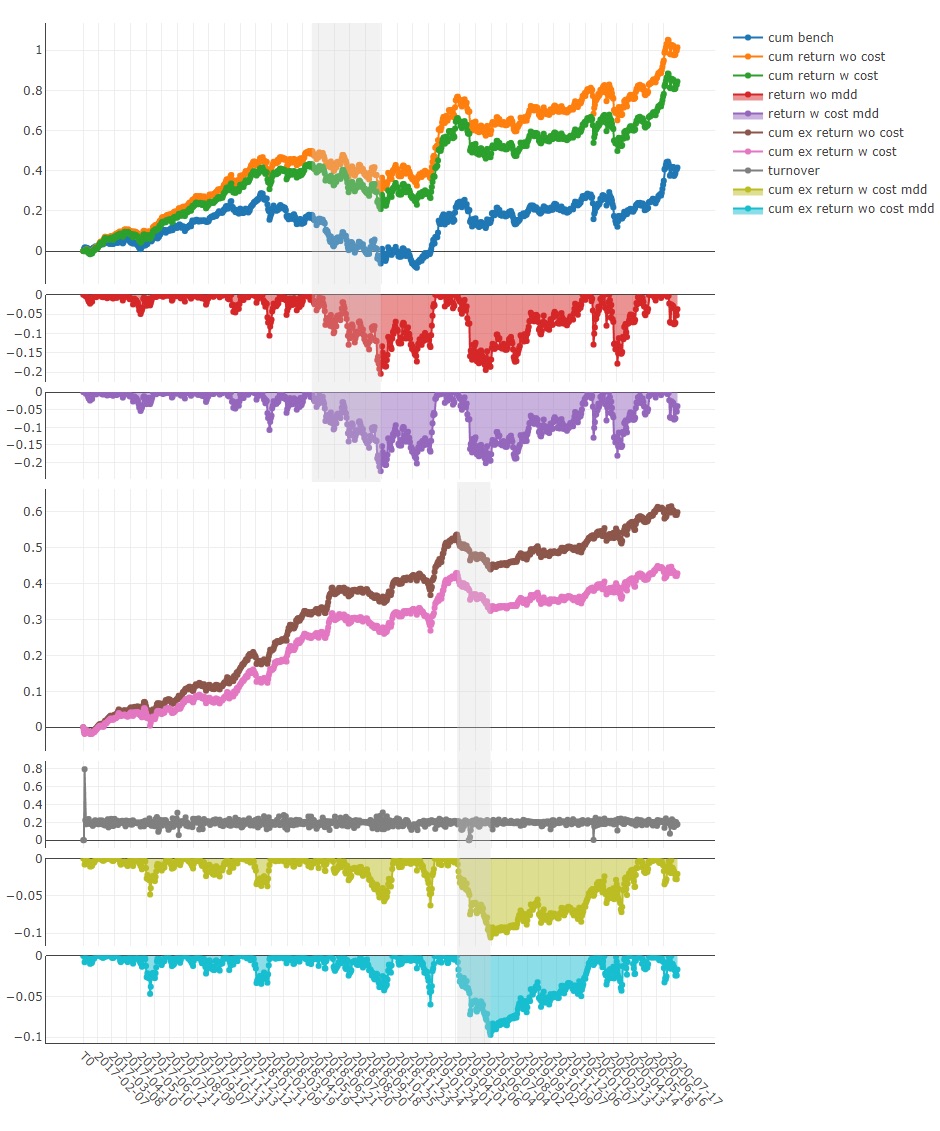
Зберігайте код кандидата, конфігурацію, ідентичність середовища, seed за потреби, маніфест даних і записані результати разом. Перевіряйте ризик, оборотність і контекст бенчмарка так само, як і головний результат. Офіційний рисунок Qlib ілюструє види аналізу, які може показати кількісний процес. Це приклад із висхідного проєкту, а не результат цього посібника. Графік корисний лише тоді, коли можна перевірити базові угоди або сигнали, вхідні припущення та період оцінювання, включно з несприятливими інтервалами.
Контролюйте процес пошуку та середовище виконання
Надайте згенерованому коду одноразове середовище з обмеженими ресурсами, лише з потрібними наборами даних та інструментами. До виконання перевірте доступ до мережі, монтування файлів і розкриття секретів. Обмежте кількість ревізій кандидатів і зберігайте відхилені експерименти. Якщо агент повторно використовує оцінку на відкладених даних для покращення коду, ця оцінка стала зворотним зв’язком розробки. Залиште справді недоторкане вікно оцінювання або інший заздалегідь оголошений дизайн оцінювання. Порівнюйте кандидатів із відповідною базовою лінією й записуйте кожне рішення відбору, а не лише фінальну реалізацію.
Плануйте роботу моделі та обчислення окремо
Відстежуйте генерацію гіпотез, ревізії коду, embedding-и та повтори моделі в журналі запитів. Навчання, симуляцію, сховище та доступ до даних записуйте в окремому журналі ресурсів, пов’язаному через ID експерименту. Локальний кеш може зменшити повторну роботу, але має бути прив’язаний до ідентичності коду й даних; інакше він поверне результат іншого кандидата. Зупиняйтеся після досягнення бюджету ітерацій або обчислень. Підсумовуйте найкраще підтверджене відкриття та залишкову невизначеність, а не дозволяйте агенту безкінечно шукати сприятливий результат.
Докази та охоплення
Цей огляд спирається на пов’язані нижче офіційні джерела RD-Agent, Qlib і FinRL. Шаблон конфігурації та рисунок із висхідного проєкту підтверджені джерелами; для цієї сторінки не виконувалися й не вимірювалися цикл RD-Agent, навчання Qlib, політика FinRL чи фінансова дохідність. Використовуйте пов’язаний посібник RD-Agent для конфігурації моделі конкретної версії та зберігайте окремий запис виконання під час власного експерименту.
Поширені запитання
Чи потрібен Qlib ключ API LLM?
Його основному кількісному процесу — ні. Підключеному дослідницькому агенту можуть знадобитися облікові дані чату або embedding-ів, тоді як Qlib виконує налаштовану числову роботу.
Коли FinRL підходить краще за факторний процес?
Коли дослідницьке питання стосується послідовного навчання політики у визначеному середовищі. Середовище та дизайн винагороди стають центральними частинами експерименту.
Чи може агент обрати період тестування?
Рецензент має схвалити межі оцінювання до розробки. Дозвіл агенту обирати сприятливі періоди після перегляду результатів послаблює експеримент.
Що робить згенерований фактор відтворюваним?
Збережені код, версія даних, календар і правила коригування, версії залежностей, стан попередньої обробки та повна конфігурація оцінювання.
Що робити, коли згенерований код не працює?
Збережіть код і структуровані докази збою, виправте найменший уражений етап у новій версії експерименту та залиште початкову спробу в історії пошуку.