AI quantitative research workflows
Updated 2026-09-06
Agents سے hypotheses propose اور implement کرائیں، پھر versioned data اور reproducible experiments سے evaluate کریں۔ Model conversation اور numerical computation الگ رکھیں۔
Idea کو falsifiable experiment میں بدلیں
Test کرنے والا mechanism، observable variables، intended universe اور idea reject کرنے والی conditions لکھیں۔ Agent specification کو code میں translate کر سکتی ہے مگر results دیکھنے کے بعد success criterion redefine نہ کرے۔ Implementation questions کو research questions سے الگ کریں: factor صحیح calculate ہو کر بھی useful signal نہ رکھ سکتا ہے۔ پہلی code-generation request سے پہلے چھوٹی specification save کریں تاکہ eventual experiment original intent سے compare ہو سکے۔
RD-Agent، Qlib اور FinRL کا درست role چنیں
RD-Agent research development کے حصے automate کرتا ہے، iterative implementation اور feedback سمیت۔ Qlib data، models اور evaluation کا quantitative workflow دیتا ہے۔ FinRL reinforcement-learning research environments فراہم کرتا ہے۔ یہ projects مختلف stages inform کر سکتے ہیں مگر interchangeable chat clients نہیں۔ LLM requests agent کی reasoning اور coding layer ہیں۔ Feature construction، training، simulation اور metrics experiment environment کی computation استعمال کرتے ہیں۔ دونوں paths record کریں تاکہ model budget complete resource budget نہ سمجھا جائے۔
| Component | Primary work | آپ کو کیا supply کرنا ہے |
|---|---|---|
| Research agent | Hypothesis، implementation، revision | Task contract اور permitted tools |
| Qlib | Data، training، signal اور portfolio evaluation | Compatible dataset اور experiment configuration |
| FinRL | Market environment میں policy training | Environment، reward definition اور evaluation design |
| Human reviewer | Methodology اور interpretation | Independent acceptance criteria |
Factors generate کرنے سے پہلے data contract fix کریں
Instrument identity، timezones، adjustment policy، calendar اور missing-value handling document کریں۔ US equity research میں مناسب US dataset اور region configuration استعمال کریں؛ دوسرے market example پر label بدلنے سے assumptions migrate نہیں ہوتیں۔ Fundamental یا textual features کے لیے historical universe membership اور publication timestamps رکھیں۔ Transformations صرف allowed development data پر normalize اور fit کریں۔ Later restatement سے calculated feature future information leak کر سکتی ہے، چاہے accounting period past کا نظر آئے۔
Official workflow structure کو execution boundary بنائیں
Qlib کا documented qrun interface configured data، model اور evaluation workflow execute کر کے artifacts record کرتا ہے۔ Agent سے runtime پر پورا environment improvise کرانے کے بجائے reviewed configuration دیں۔ نیچے command official invocation pattern ہے؛ filename آپ کی complete configuration ہے۔ Execution سے پہلے dataset path، region، instrument universe، benchmark اور train/validation/test segments validate کریں۔ History یا fields unavailable ہوں تو small data-loading check واضح fail ہو۔
# Requires an installed Qlib environment and a reviewed configuration.
qrun configuration.yaml
Complete experiment artifact inspect کریں
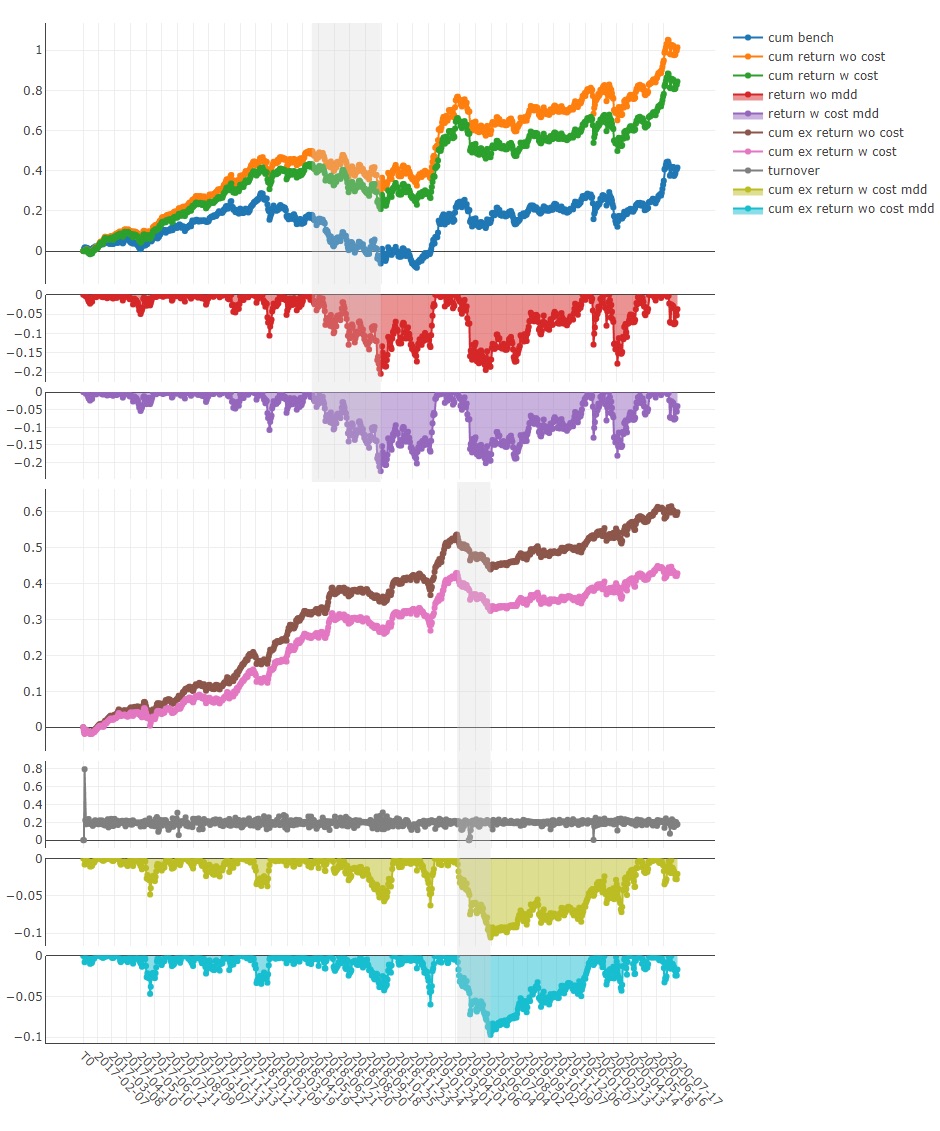
Candidate code، configuration، environment identity، relevant seed، data manifest اور recorded outputs ساتھ رکھیں۔ Headline result کے ساتھ risk، turnover اور benchmark context inspect کریں۔ Official Qlib figure quantitative workflow کی possible analysis دکھاتی ہے۔ یہ service example ہے، اس guide کا result نہیں۔ Chart تب useful ہے جب underlying trades یا signals، input assumptions اور evaluation period، unfavorable intervals سمیت، inspect ہو سکیں۔
Search process اور execution environment control کریں
Generated code کو disposable، resource-bounded environment دیں جس میں صرف ضروری datasets اور tools ہوں۔ Execution سے پہلے network access، file mounts اور secret exposure review کریں۔ Candidate revisions limit کریں اور rejected experiments محفوظ کریں۔ Agent held-out score سے code بار بار improve کرے تو score development feedback بن گیا ہے۔ واقعی untouched evaluation window یا predeclared evaluation design رکھیں۔ Appropriate baseline سے candidates compare کریں اور ہر selection decision record کریں، صرف final implementation نہیں۔
Model work اور computation الگ budget کریں
Hypothesis generation، code revisions، embeddings اور model retries request ledger میں track کریں۔ Training، simulation، storage اور data access کو experiment ID سے joined separate resource ledger میں رکھیں۔ Local cache repeated work کم کر سکتی ہے مگر code اور data identity سے key ہونی چاہیے، ورنہ دوسرے candidate کا result آ سکتا ہے۔ Iteration یا compute budget پہنچے تو stop کریں۔ Agent کو favorable result کے لیے indefinite search نہ کرنے دیں؛ best-supported finding اور remaining uncertainty summarize کریں۔
Evidence اور scope
یہ walkthrough linked official RD-Agent، Qlib اور FinRL sources پر مبنی ہے۔ Configuration pattern اور service figure source-backed ہیں؛ اس page کے لیے RD-Agent loop، Qlib training run، FinRL policy یا financial return execute یا measure نہیں کیا گیا۔ Version-specific model configuration کے لیے linked RD-Agent guide دیکھیں اور اپنی experiment میں separate execution record رکھیں۔
عمومی سوالات
کیا Qlib کو LLM API key چاہیے؟
اس کے core quantitative workflow کو نہیں۔ Attached research agent کو chat یا embedding credentials چاہیے ہو سکتی ہیں، جبکہ Qlib configured numerical work کرتی ہے۔
Factor workflow کے مقابلے FinRL کب بہتر ہے؟
جب research question defined environment میں sequential policy learning کے بارے میں ہو۔ Environment اور reward design experiment کے مرکزی حصے بن جاتے ہیں۔
کیا agent test period چن سکتی ہے؟
Development سے پہلے reviewer evaluation boundaries approve کرے۔ Results دیکھنے کے بعد agent کو favorable periods چننے دینا experiment کو کمزور کرتا ہے۔
Generated factor reproducible کیسے بنتا ہے؟
Preserved code، data version، calendar اور adjustment rules، dependency versions، preprocessing state اور complete evaluation configuration سے۔
Generated code fail ہو تو کیا کروں؟
Code اور structured failure evidence رکھیں، نئی experiment version میں smallest affected stage fix کریں اور original attempt search history میں محفوظ رکھیں۔