Configuração de RD-Agent e Qlib
Updated 2026-09-06
Configure a camada de modelo do agente de pesquisa, valide seus embeddings separadamente e prepare o ambiente quantitativo local antes de iniciar um experimento iterativo.
Atribua responsabilidades distintas ao RD-Agent e ao Qlib
Use RD-Agent para desenvolver e revisar implementações de pesquisa e Qlib para executar um fluxo quantitativo configurado. As chamadas de modelo do agente podem propor hipóteses, escrever código e interpretar feedback. Qlib trata dados, treinamento e avaliação no ambiente do experimento. Uma chave de API de modelo resolve, portanto, apenas uma dependência. Antes da configuração, escolha o cenário específico do RD-Agent, fixe a revisão do projeto e defina os limites de dados e avaliação. Assim a preparação do ambiente permanece separada das decisões de pesquisa que o agente tomará.
Configure chat e embedding pelo backend documentado
Na revisão 32b3d395 analisada, o .env.example do RD-Agent documenta o backend LiteLLM, o modelo de chat e uma base compatível com OpenAI, além de uma rota de embedding com prefixo de proxy separada. O template de shell abaixo mapeia slots de modelo pertencentes à aplicação para esses campos documentados. Escolha um modelo de chat atual depois de conferir seus recursos. EMBEDDING_BASE_URL e EMBEDDING_MODEL_ID devem apontar para um serviço de embedding disponível de forma independente; não presuma que o gateway de chat fornece um. Forneça as duas credenciais pelo ambiente e use o comando de inicialização documentado do cenário para sua versão fixada.
export BACKEND=rdagent.oai.backend.LiteLLMAPIBackend
export OPENAI_API_BASE=https://api.apisrouter.com/v1
export CHAT_MODEL="openai/$RESEARCH_MODEL_ID"
# Set OPENAI_API_KEY securely for the chat endpoint.

export LITELLM_PROXY_API_BASE="$EMBEDDING_BASE_URL"
export EMBEDDING_MODEL="litellm_proxy/$EMBEDDING_MODEL_ID"
# Set LITELLM_PROXY_API_KEY securely for the embedding service.
Valide as duas capacidades de modelo de forma independente
Confira se o cliente de chat selecionado realiza o formato de resposta e o comportamento de ferramentas exigidos pelo cenário. Para embeddings, confira vetor não vazio, dimensão consistente e identidade estável do modelo. Trocar o modelo de embedding pode exigir reconstruir vetores armazenados; uma resposta de chat bem-sucedida não valida recuperação. O diagrama apoiado por fontes mostra apenas a rota de chat proposta. Prefixos de provedor do LiteLLM selecionam comportamento do cliente e não são necessariamente o ID de modelo visto pelo endpoint; preserve tanto o valor configurado quanto a identidade de solicitação resolvida.
Prepare o ambiente quantitativo antes do loop do agente
Verifique o conjunto de dados, o ambiente Python e o container de execução permitido com uma pequena checagem determinística. Para pesquisa internacional, alinhe região do conjunto de dados, calendário do mercado e universo de instrumentos ao mercado pretendido. A documentação do fluxo Qlib oferece uma região dos EUA, mas seu conjunto de dados e premissas de exemplo não devem ser copiados sem alteração para outro mercado. Confirme cobertura histórica, política de ajuste e identidade do benchmark. Só então permita que um agente gere código candidato nesse ambiente; caso contrário, revisões repetidas do modelo podem apenas compensar uma configuração de dados quebrada.
Inspecione hipótese, código e feedback juntos
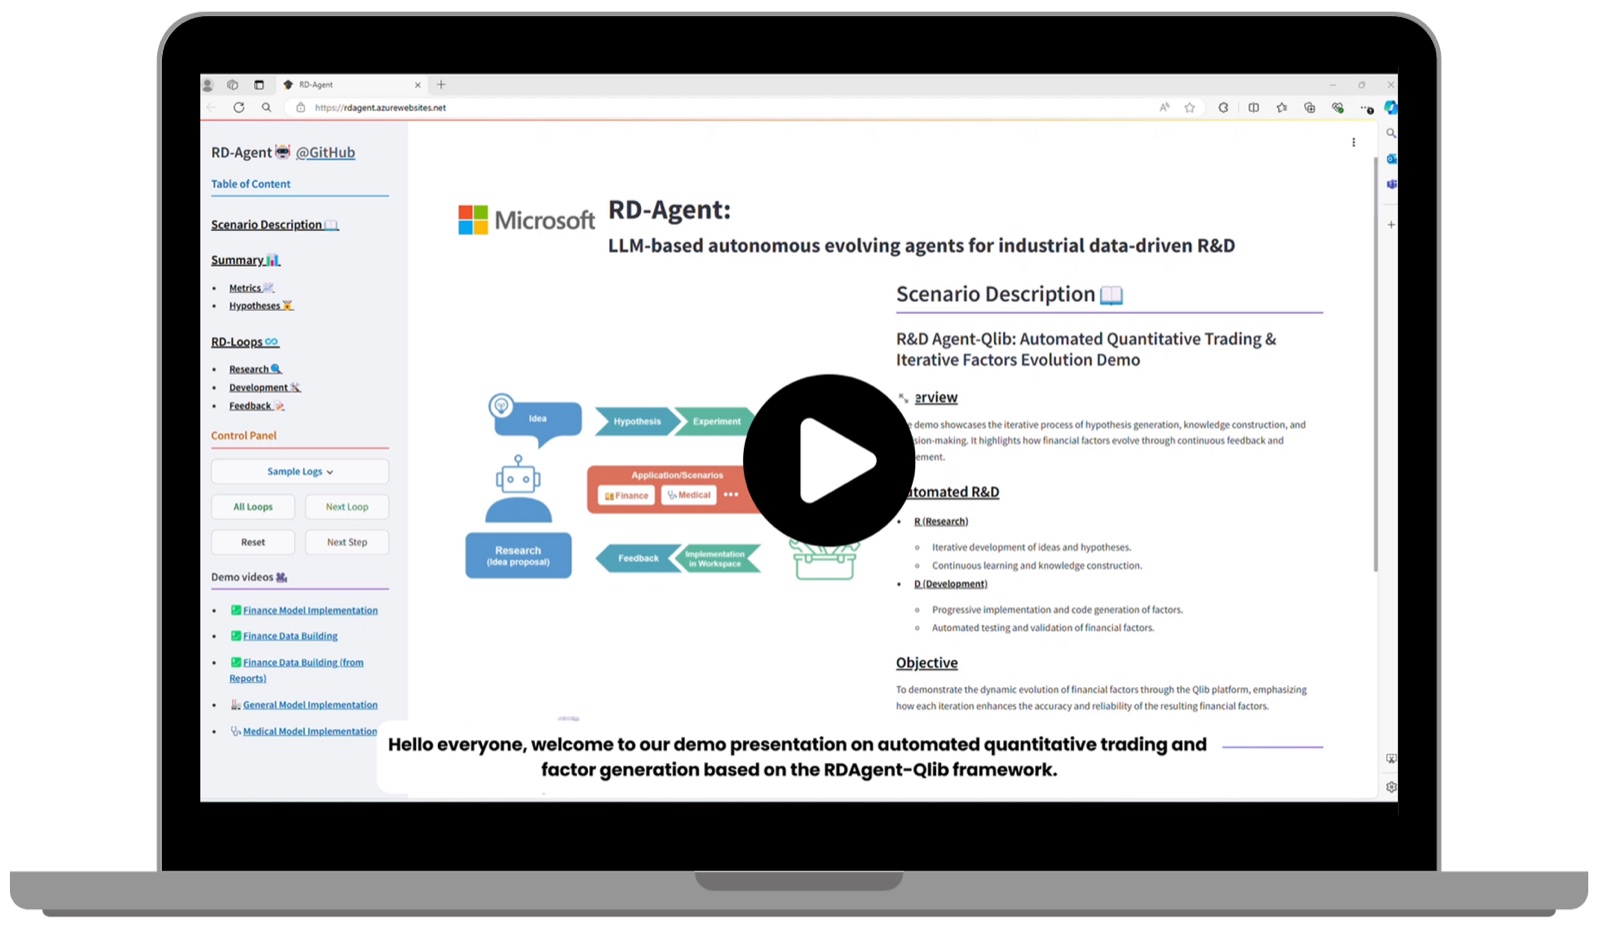
A ilustração oficial do RD-Agent mostra uma interface de pesquisa iterativa. Use essa estrutura como lembrete para preservar cada hipótese com sua implementação e feedback, em vez de salvar apenas o relatório final. Um revisor deve conseguir saber se o agente corrigiu um erro de software, mudou a pergunta de pesquisa ou selecionou outro candidato depois de ver uma pontuação. Mantenha experimentos rejeitados acessíveis e separe a saída da ferramenta da interpretação do agente sobre essa saída.
Limite a execução de código e preserve a independência da avaliação
Execute código gerado com limites explícitos de sistema de arquivos, rede e recursos. Monte somente os conjuntos de dados necessários e evite expor credenciais não relacionadas. Congele janelas de treinamento, validação e avaliação holdout antes do desenvolvimento iterativo. Se feedback de teste for devolvido repetidamente ao agente, registre que o período de teste passou a fazer parte do processo de desenvolvimento. Um manifesto do experimento deve incluir revisão da fonte, hash do código, versão dos dados, configuração, identidade do ambiente e decisão de seleção. Isso torna visíveis tanto a execução bem-sucedida quanto a falha metodológica ao próximo revisor.
Acompanhe custos e recupere a etapa falha
Una o registro de solicitações de chat e embedding ao registro de computação local usando IDs de experimento. Estimativas de custo do LiteLLM não são necessariamente as cobranças reais do gateway; reconcilie com o registro de faturamento aplicável. Separe falha de transporte do modelo, incompatibilidade de índice vetorial, exceção de código e dados Qlib ausentes em estados diferentes. Repita chamadas transitórias dentro de um orçamento e retenha erros de código para inspeção. Evite reiniciar o loop inteiro quando apenas um artefato de fonte ou uma solicitação de modelo precisa de correção e invalide caches quando modelo, código ou conjunto de dados relevante mudar.
Evidências e limites
Os campos de ambiente e o comportamento do backend foram revisados na revisão oficial da fonte 32b3d395 em 5 de setembro de 2026. A invocação e as responsabilidades do Qlib seguem sua documentação oficial. Nenhuma solicitação do cliente do projeto, resultado de embedding ou loop completo RD-Agent/Qlib foi executado pela APIsRouter para este guia. O próximo passo de aceitação é um cenário delimitado com entradas, evidências de solicitação e saídas numéricas preservadas.
Perguntas frequentes
O Qlib usa OPENAI_API_BASE?
Essa variável configura o caminho do modelo do agente descrito aqui. O Qlib propriamente dito executa dados, modelo e avaliação em seu próprio runtime.
Posso usar um provedor de embedding separado?
O template revisado documenta um LITELLM_PROXY_API_BASE e uma chave separados com um modelo litellm_proxy-prefixed. Verifique o serviço escolhido e a compatibilidade vetorial de forma independente.
Por que o modelo de chat tem o prefixo openai/?
Ele seleciona o provedor compatível no LiteLLM. Confira o ID de modelo da solicitação resolvida ao validar o endpoint, em vez de presumir que todo prefixo é encaminhado sem alteração.
Um hello de chat valida o loop de pesquisa?
Não. Ele testa uma operação do cliente. Embeddings, recuperação, execução de código, dados Qlib e avaliação final exigem cada um seu próprio resultado observável.
O que preservar quando o agente altera código?
Mantenha código anterior e novo, hipótese, feedback e identidade do experimento para que revisores reconstruam a busca e detectem vazamento da avaliação.