Procesy badań ilościowych z AI
Updated 2026-09-06
Używaj agentów do proponowania i implementowania hipotez, a następnie pozwól, aby wersjonowane dane i powtarzalne eksperymenty je oceniły. Zachowaj rozróżnienie między rozmową z modelem a obliczeniami liczbowymi.
Zamień pomysł w eksperyment podatny na falsyfikację
Zapisz mechanizm, który chcesz przetestować, obserwowalne zmienne, zamierzone uniwersum oraz warunki, które odrzuciłyby pomysł. Agent może pomóc przełożyć tę specyfikację na kod, ale nie powinien redefiniować kryterium sukcesu po zobaczeniu wyników. Oddziel pytania implementacyjne od badawczych: czynnik może być obliczony poprawnie i nadal nie zawierać użytecznego sygnału. Przed pierwszym żądaniem generowania kodu zapisz małą specyfikację, aby późniejszy eksperyment można było porównać z pierwotną intencją.
Wybierz właściwą rolę RD-Agent, Qlib i FinRL
RD-Agent automatyzuje części rozwoju badań, w tym iteracyjną implementację i przekazywanie informacji zwrotnej. Qlib dostarcza ilościowy proces dla danych, modeli i ewaluacji. FinRL zapewnia środowiska badawcze uczenia ze wzmocnieniem. Projekty te mogą wspierać różne etapy, ale nie są wymiennymi klientami czatu. Żądania LLM należą do warstwy rozumowania i kodowania agenta. Budowa cech, trenowanie, symulacja i metryki zużywają zasoby obliczeniowe środowiska eksperymentu. Zapisz obie ścieżki, aby budżet modelu nie został pomylony z pełnym budżetem zasobów.
| Komponent | Główna praca | Co musisz dostarczyć |
|---|---|---|
| Agent badawczy | Hipoteza, implementacja, rewizja | Kontrakt zadania i dozwolone narzędzia |
| Qlib | Ewaluacja danych, trenowania, sygnału i portfela | Zgodny zbiór danych i konfiguracja eksperymentu |
| FinRL | Trenowanie polityki w środowisku rynkowym | Środowisko, definicja nagrody i projekt ewaluacji |
| Recenzent człowiek | Metodologia i interpretacja | Niezależne kryteria akceptacji |
Ustal kontrakt danych przed generowaniem czynników
Udokumentuj tożsamość instrumentu, strefy czasowe, politykę korekt, kalendarz i obsługę brakujących wartości. W badaniach akcji amerykańskich użyj odpowiedniego zbioru danych z USA i konfiguracji regionu; zmiana etykiety w przykładzie z innego rynku nie przenosi jego założeń. Zachowaj historyczną przynależność do uniwersum i znaczniki czasu publikacji dla cech fundamentalnych lub tekstowych. Normalizuj i dopasowuj przekształcenia wyłącznie na dozwolonych danych rozwojowych. Czynnik obliczony z późniejszego przekształcenia danych może ujawnić informację z przyszłości, nawet gdy jego okres rachunkowy wygląda na należący do przeszłości.
Użyj oficjalnej struktury procesu jako granicy wykonania
Udokumentowany interfejs qrun Qlib wykonuje skonfigurowany proces danych, modelu i ewaluacji oraz zapisuje artefakty. Dostarcz przejrzaną konfigurację, zamiast prosić agenta o improwizowanie całego środowiska w czasie działania. Polecenie poniżej jest oficjalnym wzorcem wywołania; nazwa pliku oznacza własną kompletną konfigurację. Przed wykonaniem zweryfikuj ścieżkę zbioru danych, region, uniwersum instrumentów, benchmark i segmenty treningu, walidacji oraz testu. Mała kontrola ładowania danych powinna wyraźnie zgłosić brak wymaganej historii lub pól.
# Requires an installed Qlib environment and a reviewed configuration.
qrun configuration.yaml
Przeanalizuj kompletny artefakt eksperymentu
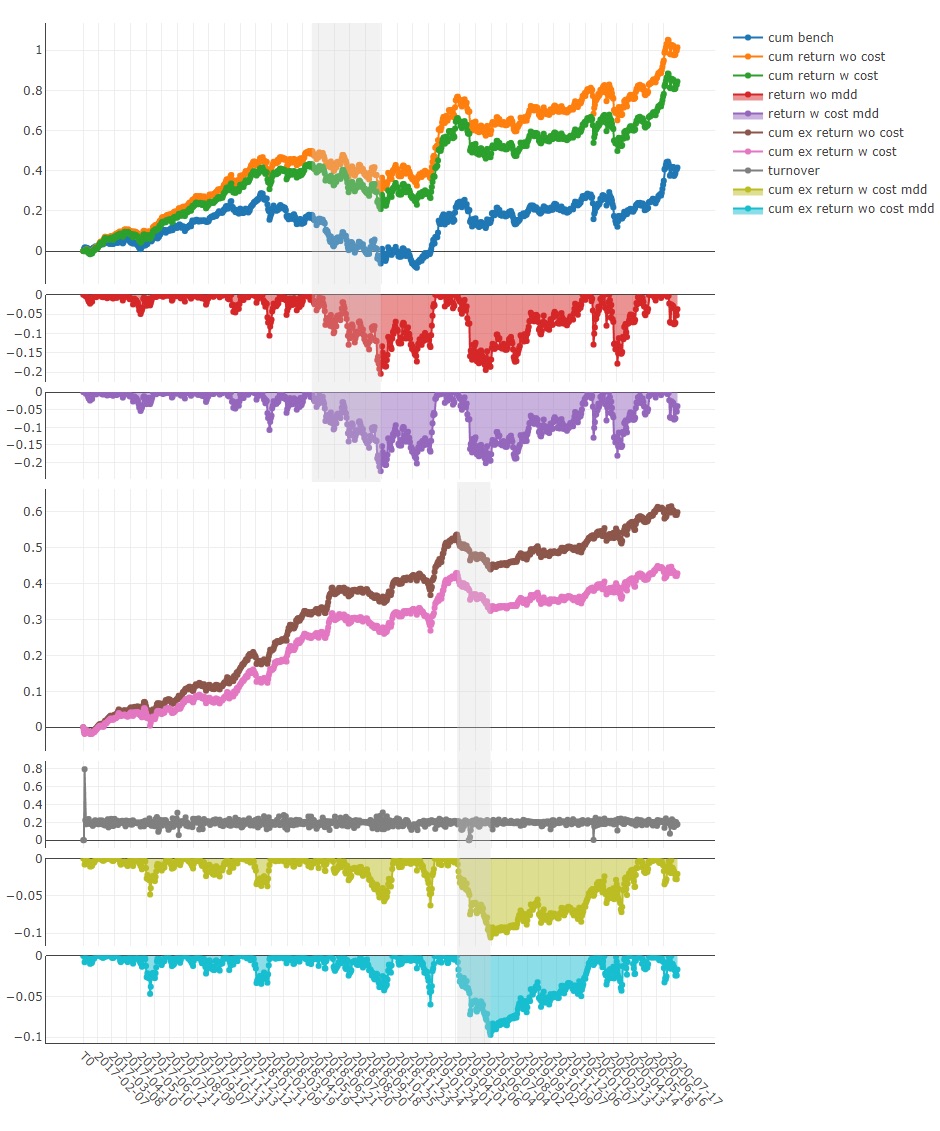
Przechowuj razem kod kandydata, konfigurację, tożsamość środowiska, odpowiedni seed, manifest danych i zapisane wyniki. Analizuj ryzyko, obrót portfela i kontekst benchmarku, a także każdy główny wynik. Oficjalny wykres Qlib ilustruje rodzaje analiz, które może ujawnić proces ilościowy. Jest przykładem service, a nie wynikiem tego przewodnika. Wykres jest użyteczny tylko wtedy, gdy można przejrzeć leżące pod nim transakcje lub sygnały, założenia wejściowe i okres ewaluacji, w tym niekorzystne przedziały.
Kontroluj proces wyszukiwania i środowisko wykonania
Dostarcz wygenerowanemu kodowi jednorazowe środowisko z ograniczonymi zasobami, zawierające tylko potrzebne zbiory danych i narzędzia. Przed wykonaniem przejrzyj dostęp do sieci, montowania plików i ujawnienie sekretów. Ogranicz liczbę rewizji kandydatów i zachowaj odrzucone eksperymenty. Jeśli agent wielokrotnie używa wyniku na odłożonych danych do poprawiania kodu, wynik ten stał się informacją zwrotną rozwoju. Zarezerwuj naprawdę nietknięte okno ewaluacji lub inny wcześniej zadeklarowany projekt ewaluacji. Kandydatów porównuj z odpowiednim baseline'em i zapisuj każdą decyzję wyboru, nie tylko końcową implementację.
Budżetuj osobno pracę modelu i obliczenia
Śledź generowanie hipotez, rewizje kodu, embeddingi i ponowienia modelu w dzienniku żądań. Trenowanie, symulację, przechowywanie i dostęp do danych śledź w osobnym dzienniku zasobów połączonym identyfikatorem eksperymentu. Lokalny cache może ograniczyć powtórną pracę, ale musi być kluczowany tożsamością kodu i danych; w przeciwnym razie zwróci wynik innego kandydata. Zatrzymaj się po osiągnięciu budżetu iteracji lub obliczeń. Podsumuj najlepiej poparte ustalenie i pozostałą niepewność, zamiast pozwalać agentowi bez końca szukać korzystnego wyniku.
Dowody i zakres
Ten przewodnik opiera się na oficjalnych źródłach RD-Agent, Qlib i FinRL wskazanych poniżej. Wzorzec konfiguracji i wykres service są poparte źródłami; na potrzeby tej strony nie wykonano ani nie zmierzono pętli RD-Agent, trenowania Qlib, polityki FinRL ani wyniku finansowego. Skorzystaj z powiązanego przewodnika RD-Agent dla konfiguracji modelu właściwej dla wersji i zachowaj osobny rekord wykonania przy uruchamianiu własnego eksperymentu.
Częste pytania
Czy Qlib potrzebuje klucza API LLM?
Jego podstawowy proces ilościowy nie potrzebuje. Dołączony agent badawczy może wymagać danych uwierzytelniających czatu lub embeddingów, podczas gdy Qlib wykonuje skonfigurowane obliczenia liczbowe.
Kiedy FinRL lepiej pasuje niż proces czynnikowy?
Gdy pytanie badawcze dotyczy sekwencyjnego uczenia polityki w zdefiniowanym środowisku. Środowisko i projekt nagrody stają się centralnymi częściami eksperymentu.
Czy agent może wybrać okres testowy?
Recenzent powinien zatwierdzić granice ewaluacji przed rozwojem. Pozwalanie agentowi wybierać korzystne okresy po zobaczeniu wyników osłabia eksperyment.
Co sprawia, że wygenerowany czynnik jest powtarzalny?
Zachowany kod, wersja danych, kalendarz i reguły korekt, wersje zależności, stan przetwarzania wstępnego oraz kompletna konfiguracja ewaluacji.
Co zrobić, gdy wygenerowany kod zawiedzie?
Zachowaj kod i ustrukturyzowane dowody awarii, napraw najmniejszy dotknięty etap w nowej wersji eksperymentu i pozostaw pierwotną próbę w historii wyszukiwania.