Konfiguracja RD-Agent i Qlib
Updated 2026-09-06
Skonfiguruj warstwę modelu agenta badawczego, osobno zweryfikuj embeddingi i przygotuj lokalne środowisko ilościowe przed rozpoczęciem iteracyjnego eksperymentu.
Przypisz RD-Agent i Qlib różne odpowiedzialności
RD-Agent wykorzystuj do rozwijania i zmieniania implementacji badawczych, a Qlib do wykonywania skonfigurowanego procesu ilościowego. Wywołania modelu agenta mogą proponować hipotezy, pisać kod i interpretować informacje zwrotne. Qlib obsługuje dane, trenowanie i ewaluację w środowisku eksperymentu. Klucz API modelu rozwiązuje zatem tylko jedną zależność. Przed konfiguracją wybierz konkretny scenariusz RD-Agent, przypnij rewizję projektu i zdefiniuj granice zbioru danych oraz ewaluacji. Oddziela to przygotowanie środowiska od decyzji badawczych podejmowanych przez agenta.
Skonfiguruj czat i embeddingi przez udokumentowany backend
W przejrzanej rewizji 32b3d395 plik .env.example RD-Agent dokumentuje backend LiteLLM, model czatu i bazę zgodną z OpenAI oraz osobną trasę embeddingów z prefiksem proxy. Poniższy szablon powiązuje sloty modeli należące do aplikacji z tymi udokumentowanymi polami. Wybierz aktualny model czatu po sprawdzeniu jego możliwości. EMBEDDING_BASE_URL i EMBEDDING_MODEL_ID muszą wskazywać niezależnie dostępną usługę embeddingów; nie zakładaj, że gateway czatu ją zapewnia. Oba dane uwierzytelniające dostarcz przez środowisko i użyj udokumentowanego polecenia startowego scenariusza dla przypiętej wersji.
export BACKEND=rdagent.oai.backend.LiteLLMAPIBackend
export OPENAI_API_BASE=https://api.apisrouter.com/v1
export CHAT_MODEL="openai/$RESEARCH_MODEL_ID"
# Set OPENAI_API_KEY securely for the chat endpoint.

export LITELLM_PROXY_API_BASE="$EMBEDDING_BASE_URL"
export EMBEDDING_MODEL="litellm_proxy/$EMBEDDING_MODEL_ID"
# Set LITELLM_PROXY_API_KEY securely for the embedding service.
Niezależnie zweryfikuj obie możliwości modelu
Sprawdź, czy wybrany klient czatu obsługuje wymagany przez scenariusz format odpowiedzi i zachowanie narzędzi. Dla embeddingów sprawdź niepusty wektor, stały wymiar i stabilną tożsamość modelu. Zmiana modelu embeddingów może wymagać odbudowania zapisanych wektorów; udana odpowiedź czatu nie waliduje pobierania. Diagram oparty na źródłach pokazuje tylko proponowaną trasę czatu. Prefiksy dostawcy LiteLLM wybierają zachowanie klienta i nie muszą być identyfikatorem modelu widzianym przez endpoint, więc zachowaj zarówno skonfigurowaną wartość, jak i rozwiązaną tożsamość żądania.
Przygotuj środowisko ilościowe przed pętlą agenta
Małą deterministyczną kontrolą zweryfikuj zbiór danych, środowisko Pythona i dozwolony kontener wykonawczy. W badaniach międzynarodowych dopasuj region zbioru danych, kalendarz rynku i uniwersum instrumentów do zamierzonego rynku. Dokumentacja procesu Qlib wspiera region USA, ale przykładowego zbioru danych i założeń nie należy bez zmian kopiować na inny rynek. Potwierdź zakres historyczny, politykę korekt i tożsamość benchmarku. Dopiero wtedy pozwól agentowi generować kod kandydacki w tym środowisku; inaczej kolejne rewizje modelu mogą jedynie kompensować zepsutą konfigurację danych.
Przeglądaj razem hipotezę, kod i informacje zwrotne
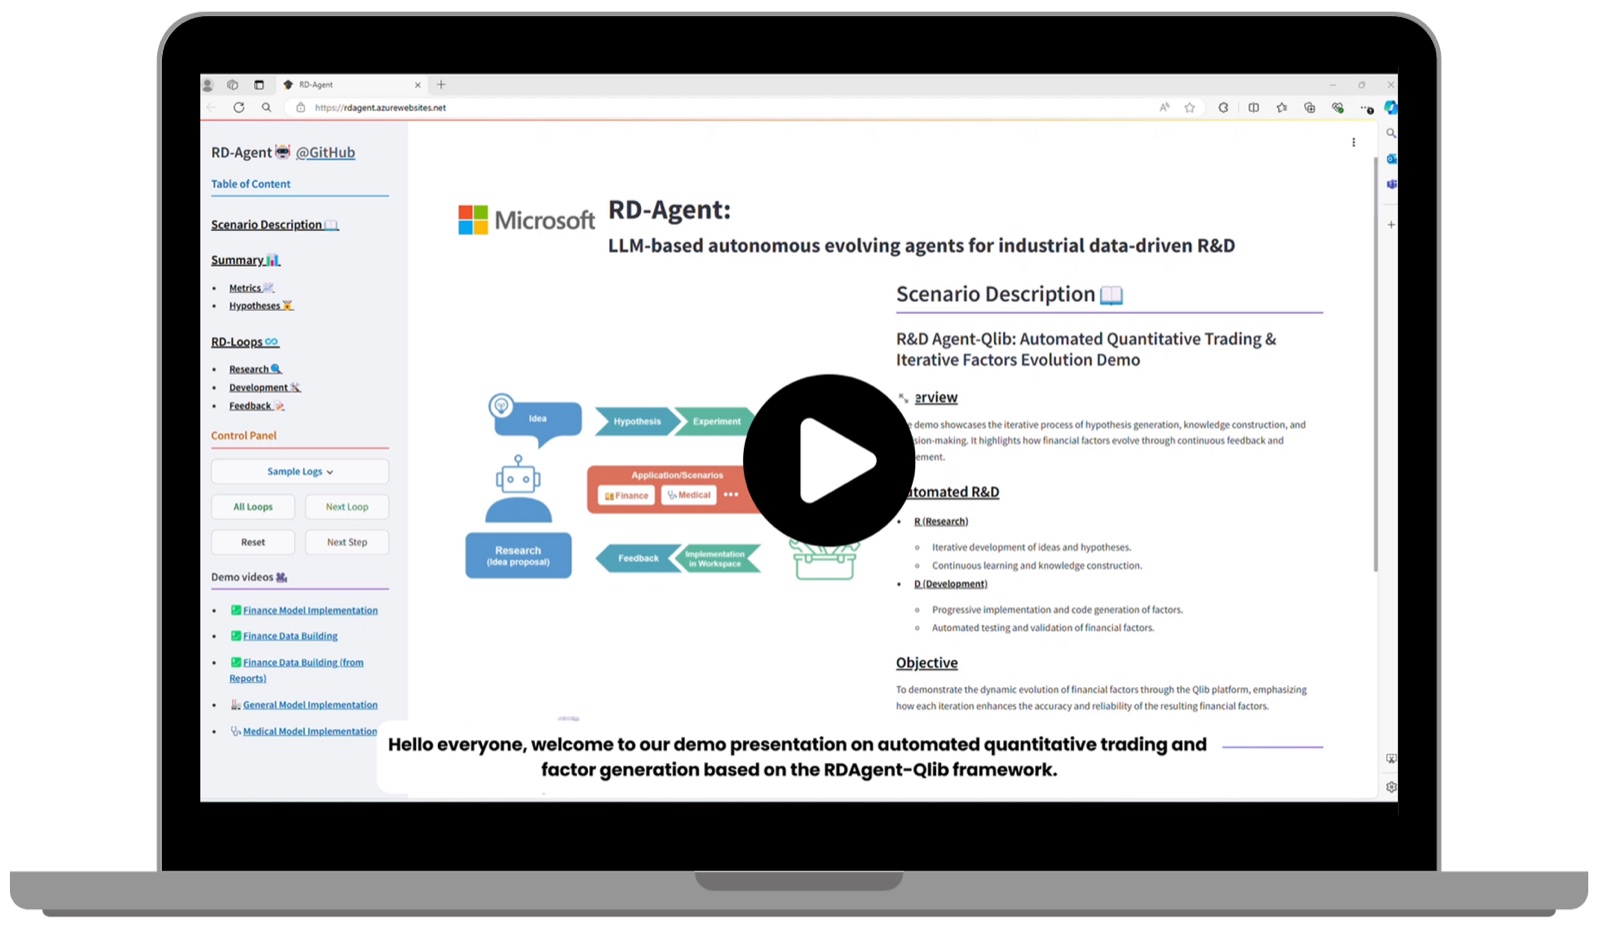
Oficjalna ilustracja RD-Agent pokazuje iteracyjny interfejs badawczy. Użyj tej struktury jako przypomnienia, aby każdą hipotezę zachować wraz z implementacją i informacją zwrotną, zamiast zapisywać tylko końcowy raport. Recenzent powinien móc ustalić, czy agent naprawił błąd oprogramowania, zmienił pytanie badawcze, czy wybrał innego kandydata po zobaczeniu wyniku. Zachowaj dostęp do odrzuconych eksperymentów i oddziel wynik narzędzia od interpretacji agenta.
Ogranicz wykonywanie kodu i zachowaj niezależność ewaluacji
Uruchamiaj wygenerowany kod z jawnymi limitami systemu plików, sieci i zasobów. Montuj tylko wymagane zbiory danych i nie ujawniaj niezwiązanych danych uwierzytelniających. Zamroź okna treningu, walidacji i ewaluacji odłożonej przed iteracyjnym rozwojem. Jeśli informacja zwrotna z testu jest wielokrotnie przekazywana agentowi, zapisz, że okres testowy stał się częścią procesu rozwojowego. Manifest eksperymentu powinien zawierać rewizję źródła, hash kodu, wersję danych, konfigurację, tożsamość środowiska i decyzję wyboru. Dzięki temu zarówno udane wykonanie, jak i błąd metodologiczny pozostają widoczne dla następnego recenzenta.
Śledź koszty i odzyskuj zawodny etap
Połącz dziennik żądań czatu i embeddingów z dziennikiem lokalnych obliczeń przez identyfikatory eksperymentów. Szacunki kosztu LiteLLM nie muszą odpowiadać rzeczywistym opłatom gatewaya; uzgodnij je z właściwym rekordem rozliczenia. Błąd transportu modelu, niezgodność indeksu wektorowego, wyjątek kodu i brakujące dane Qlib trzymaj jako różne stany. Chwilowe wywołania ponawiaj w budżecie, a błędy kodu zachowaj do inspekcji. Unikaj restartowania całej pętli, gdy korekty wymaga tylko jeden artefakt źródłowy lub żądanie modelu, i unieważniaj cache po zmianie odpowiedniego modelu, kodu lub zbioru danych.
Dowody i ograniczenia
Pola środowiska i zachowanie backendu przejrzano w oficjalnej rewizji źródła 32b3d395 5 września 2026 r. Wywołanie Qlib i odpowiedzialności wynikają z jego oficjalnej dokumentacji. Na potrzeby tego przewodnika nie wykonano żądania klienta projektu, wyniku embeddingów ani kompletnej pętli RD-Agent/Qlib przez APIsRouter. Następnym etapem akceptacji jest ograniczony scenariusz z zachowanymi danymi wejściowymi, dowodami żądań i wynikami liczbowymi.
Częste pytania
Czy Qlib używa OPENAI_API_BASE?
Ta zmienna konfiguruje opisaną tutaj ścieżkę modelu agenta. Sam Qlib wykonuje pracę danych, modelu i ewaluacji we własnym środowisku.
Czy mogę użyć osobnego dostawcy embeddingów?
Przejrzany szablon dokumentuje osobne LITELLM_PROXY_API_BASE i klucz z modelem z prefiksem litellm_proxy. Niezależnie zweryfikuj wybraną usługę i zgodność wektorów.
Dlaczego model czatu ma prefiks openai/?
Wybiera on zgodnego dostawcę w LiteLLM. Przy walidacji endpointu sprawdź rozwiązaną wartość identyfikatora modelu żądania, zamiast zakładać, że każdy prefiks jest przekazywany bez zmian.
Czy powitanie czatu zweryfikuje pętlę badawczą?
Nie. Testuje jedną operację klienta. Embeddingi, pobieranie, wykonywanie kodu, dane Qlib i końcowa ewaluacja wymagają własnych obserwowalnych wyników.
Co zachować, gdy agent zmienia kod?
Zachowaj wcześniejszy kod, nowy kod, hipotezę, informacje zwrotne i tożsamość eksperymentu, aby recenzenci mogli odtworzyć wyszukiwanie i wykryć wyciek danych ewaluacyjnych.