Astra API-kosten van gebruik naar geaccepteerd werk
Updated 2026-09-05
Registreer gewone input, cache reads, cache writes en output afzonderlijk. Gebruik de actuele officiële tariefkaart en een volledig requestledger om een taak te schatten.
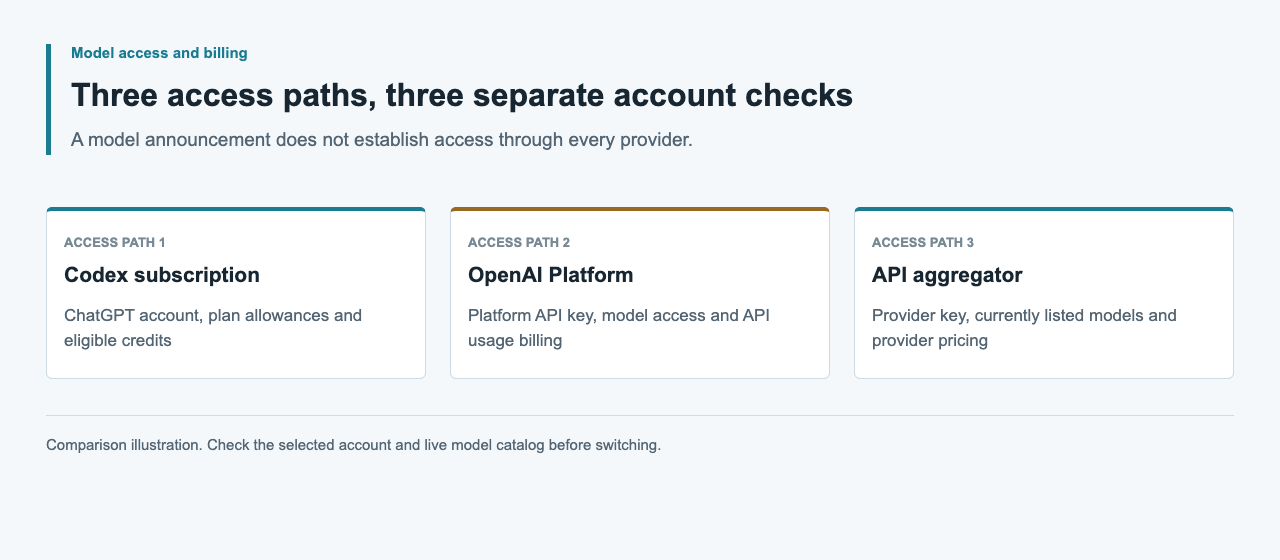
Kies het factureringssysteem vóór je een tarief kiest
Directe Astra API-requests gebruiken OpenAI Platform-facturering. Met ChatGPT geauthenticeerd Codex-werk gebruikt abonnement- of workspace-allowances en credits. OpenAI publiceert deze afzonderlijk: een Codex-creditrate is geen dollarprijs per API-token en een inbegrepen abonnementsbeurt is geen API-ontvangstbewijs.
Open voor directe requests de officiële API-prijspagina en selecteer de toepasselijke gpt-6-astra-tarieven voor servicelaag, contextband en verwerkingsregeling. Bewaar de URL van de tariefkaart en observatiedatum bij je schatting. Bouw de berekening op uit request-level usage en vergelijk het totaal daarna met je Platform-gebruiksrecords en factuur. Zo zijn verschillen in tariefkeuze of ontbrekende requests eenvoudiger te vinden.
Leg de exacte Responses-usagevelden vast
De officiële prompt-cachinggids documenteert input_tokens, input_tokens_details.cached_tokens en input_tokens_details.cache_write_tokens. Cached reads en cache writes zijn afzonderlijke categorieën binnen input; trek beide af voordat je gewone input berekent. Aannemen dat elke niet-gecachete token tegen het gewone inputtarief valt, kan een request die een cache schrijft onderschatten.
De reasoninggids documenteert output_tokens en output_tokens_details.reasoning_tokens. Reasoning-tokens zijn inbegrepen in output usage; tel ze niet nogmaals als aparte gefactureerde tokencategorie. Gebruik total_tokens als usage-totaal, niet als aantal dat je met één blended rate vermenigvuldigt. Bewaar het volledige usage-object, zodat latere afstemming niet afhankelijk is van een onvolledig tekstlog.
| Responses-veld | Betekenis | Behandeling in administratie |
|---|---|---|
| usage.input_tokens | Totale inputtokens | Splits gewone input, cache reads en writes |
| usage.input_tokens_details.cached_tokens | Cached inputtokens | Pas het cached-inputtarief toe |
| usage.input_tokens_details.cache_write_tokens | Inputtokens die naar de cache zijn geschreven | Pas het cache-writetarief toe |
| usage.output_tokens | Outputtokens inclusief reasoning | Pas het outputtarief één keer toe |
| usage.output_tokens_details.reasoning_tokens | Reasoning binnen output | Bewaar als diagnostische subset |
| usage.total_tokens | Totale input- en outputusage | Bewaar voor afstemming |
Bereken het tokensubtotaal zonder dubbel tellen
Laat I staan voor inputtokens, C voor cached input, W voor cache-write-input en O voor outputtokens. Gewone input is I - C - W. Met tarieven R_input, R_cached, R_write en R_output, uitgedrukt in dezelfde valuta per miljoen tokens, is het tokensubtotaal ((I - C - W) * R_input + C * R_cached + W * R_write + O * R_output) / 1,000,000.
De offlinefunctie hieronder accepteert geobserveerde usage en een afzonderlijk geselecteerde tariefkaart. De tariefnamen zijn applicatievariabelen, geen API-velden. De functie retourneert null voor ontbrekende of inconsistente input in plaats van onbekend gebruik stilzwijgend als gratis te behandelen. Het resultaat dekt alleen tokens, niet tools, belastingen of andere factuurposten.
function estimateTokenCost(usage, rates) {
  const I = usage?.input_tokens
  const C = usage?.input_tokens_details?.cached_tokens
  const W = usage?.input_tokens_details?.cache_write_tokens
  const O = usage?.output_tokens
  const tokens = [I, C, W, O]
  const prices = [rates?.input, rates?.cached, rates?.write, rates?.output]
  if (!tokens.every(n => Number.isSafeInteger(n) && n >= 0)) return null
  if (!prices.every(n => Number.isFinite(n) && n >= 0)) return null
  if (C > I || W > I - C) return null
  const subtotal = ((I - C - W) * rates.input
    + C * rates.cached + W * rates.write
    + O * rates.output) / 1_000_000
  return Number.isFinite(subtotal) ? subtotal : null
}
Bepaal context- en servicelaagregels per request
De officiële Astra-prijsstelling onderscheidt gewone input, cached input, cache writes en output, met verschillende contextbanden en servicelagen. Bepaal die regels per request voordat je tarieven aan de formule levert. Pas een multiplier niet nogmaals toe wanneer je al een rij van de tariefkaart hebt geselecteerd waarin die is opgenomen.
Bewaar servicelaag- en verwerkingsmetadata bij de response en vergelijk die met wat is aangevraagd. Gebruik Codex-snelheids- of creditmultipliers niet voor een directe API-berekening: die horen bij een ander product en prijsrooster. Stem bij ongebruikelijke verwerkingsregelingen af op de toepasselijke voorwaarden van de provider. Een correcte tokenformule met de verkeerde tariefbasis blijft een onjuiste kostenschatting.
Houd tokenschattingen gescheiden van volledige taakkosten
Een taak kan meerdere modelrequests, tool calls en revisies vereisen. Tel het tokensubtotaal van elke geregistreerde request op en voeg afzonderlijk gefactureerde providertools of -services toe volgens hun werkelijke gebruik en prijs. Dat een model een tool kan aanroepen, betekent niet dat die tool zonder extra kosten inbegrepen is.
Houd infrastructuur, kosten voor assetgeneratie en menselijke review in afzonderlijke categorieën. Koppel servicebonnen en de gedekte periode en wijs gedeelde kosten consistent toe aan taken. Benoem voor een game, lokalisatiebatch of researchtaak welke onderdelen het totaal bevat. Houd belastingen en valutaomrekeningen gescheiden van tokenrates, zodat je zowel het usagesubtotaal als het uiteindelijke betaalde bedrag kunt afstemmen.
| Kostencomponent | Te bewaren bewijs | Combinatieregel |
|---|---|---|
| Modeltokens | Responses-usage plus toepasselijke API-tarieven | Tel requestsubtotalen op |
| Providertools of -services | Toolgebruik en officiële prijscategorie | Voeg afzonderlijk gefactureerde posten toe |
| Andere runtime of assets | Servicebonnen en attributie | Rapporteer in aparte categorieën |
| Menselijke review | Geregistreerde tijd en vastgelegde waarderingsmethode | Houd gescheiden van API-uitgaven |
Houd retries, onvoltooid werk en ontbrekende usage zichtbaar
De OpenAI-reasoninggids waarschuwt dat onvoltooide generatie input- en reasoning-tokens kan verbruiken zonder zichtbare tekst te produceren. Tel usage die daadwerkelijk wordt geretourneerd, ook als het resultaat je acceptatiecontrole niet haalt. Beperk het ledger niet tot geslaagde eindantwoorden en schat uitgaven niet alleen op basis van antwoordlengte.
Bewaar per poging response-identiteit, model, status, usage en de taak waartoe die hoort. Stem duplicaten af voordat je optelt. Als een verbinding wegvalt en er geen usage aankomt, markeer de poging als onopgelost totdat providerrecords duidelijkheid geven; gratis kosten noch volledig succes zijn vastgesteld. Begrens retries zodat een tijdelijke fout geen ongereviewde reeks gefactureerde pogingen kan veroorzaken.
Budgetteer rond geaccepteerde resultaten en begrensd werk
Definieer de eenheid van geaccepteerd werk voordat je meet: een geteste codewijziging, een goedgekeurd product-locale-record of een brongekoppelde researchnotitie. Kosten per geaccepteerde eenheid zijn de toerekenbare taakkosten gedeeld door het aantal geaccepteerde eenheden, alleen wanneer dat aantal niet nul is. Rapporteer sample en onopgeloste usage naast de verhouding.
Gebruik samen een requestlimiet, begrensde retries en een stopconditie voor de taak. Het gedocumenteerde veld max_output_tokens beperkt generatie, inclusief reasoning, maar is geen volledig valutabudget voor een taak met meerdere requests. Stel ook accountcontroles in en volg de opgelopen uitgaven. Evalueer kleinere context of andere reasoning-instellingen tegen dezelfde acceptatiecriteria en presenteer ze niet als gegarandeerde besparing.
Beschikbaarheid van de provider en bewijs: 5 september 2026
De usagevelden en formule in deze gids komen uit officiële OpenAI-documentatie. Voor het artikel zijn geen Astra-taakkosten of runtime gemeten. Op 5 september 2026 gaf het openbare APIsRouter-pricing-endpoint HTTP 200, success: true en 34 modellen terug zonder Astra of GPT-6; daarom staat hier geen APIsRouter Astra-offerte.
Gebruik de actuele OpenAI-prijsstelling voor directe Astra-requests en de live APIsRouter-catalogus voor het eigen aanbod. Een providervergelijking vereist gelijke taken, echte modelidentiteit, geaccepteerde output, volledige usage en toepasselijke tarieven. Bewaar die records bij de berekening zodat lezers een schatting kunnen onderscheiden van een afgestemde taakfactuur.
Veelgestelde vragen
Wat is de actuele Astra API-prijs?
Gebruik de officiële OpenAI API-prijspagina voor gpt-6-astra. Selecteer de servicelaag en contextband die op je request van toepassing zijn, inclusief afzonderlijke tarieven voor cache reads en cache writes.
Worden reasoning-tokens extra naast output_tokens gefactureerd?
Reasoning-tokens zijn inbegrepen in output usage. Pas het outputtarief één keer toe op output_tokens en bewaar output_tokens_details.reasoning_tokens voor diagnose in plaats van ze nogmaals op te tellen.
Hoe beïnvloeden cache writes de formule?
Trek cached_tokens en cache_write_tokens af van de totale input om gewone input te verkrijgen. Prijs gewone input, cache reads en cache writes afzonderlijk met de toepasselijke officiële tarieven.
Is een timeout of onvolledig antwoord gratis?
Niet noodzakelijk. Onvoltooide generatie kan tokens verbruiken en bij een timeout kan factureringsbewijs onopgelost blijven. Bewaar geretourneerde usage en stem ontbrekende records af in plaats van nul kosten toe te kennen.
Wat kost een Astra-taak via APIsRouter?
Er is geen offerte uit de controle van 5 september 2026 omdat Astra in de catalogus ontbrak. Controleer het actuele aanbod en gebruik OpenAI-prijzen voor directe Astra-schattingen.