AI-workflows voor kwantitatief onderzoek
Updated 2026-09-06
Gebruik agents om hypotheses voor te stellen en te implementeren en laat versiebeheerste data en reproduceerbare experimenten ze evalueren. Houd modelconversatie en numerieke berekening afzonderlijk.
Maak van een idee een falsifieerbaar experiment
Schrijf het mechanisme op dat je wilt testen, de observeerbare variabelen, het bedoelde universum en de voorwaarden die het idee zouden verwerpen. Een agent kan helpen die specificatie naar code te vertalen, maar mag het succescriterium niet na het zien van resultaten herdefiniëren. Scheid implementatievragen van onderzoeksvragen: een factor kan correct worden berekend en toch geen bruikbaar signaal bevatten. Bewaar vóór de eerste codegeneratierequest een kleine specificatie zodat het uiteindelijke experiment met de oorspronkelijke intentie kan worden vergeleken.
Kies de juiste rol voor RD-Agent, Qlib en FinRL
RD-Agent automatiseert delen van onderzoeksontwikkeling, inclusief iteratieve implementatie en feedback. Qlib levert een kwantitatieve workflow voor data, modellen en evaluatie. FinRL biedt reinforcement-learningonderzoeksomgevingen. Deze projecten kunnen verschillende fasen informeren, maar zijn geen uitwisselbare chatclients. LLM-requests horen in de reasoning- en codinglaag van de agent. Featureconstructie, training, simulatie en metrics verbruiken berekening in de experimentele omgeving. Registreer beide paden zodat een modelbudget niet wordt aangezien voor het volledige resourcebudget.
| Component | Primair werk | Wat jij moet leveren |
|---|---|---|
| Researchagent | Hypothese, implementatie, revisie | Taakcontract en toegestane tools |
| Qlib | Data, training, signaal en portfoliobeoordeling | Compatibele dataset en experimentele configuratie |
| FinRL | Policytraining in een marktomgeving | Omgeving, rewarddefinitie en evaluatieontwerp |
| Menselijke reviewer | Methodologie en interpretatie | Onafhankelijke acceptatiecriteria |
Herstel het datacontract vóór je factoren genereert
Documenteer instrumentidentiteit, tijdzones, aanpassingsbeleid, kalender en omgang met ontbrekende waarden. Gebruik voor US-equityresearch een passende Amerikaanse dataset en regioconfiguratie; een label in een voorbeeld uit een andere markt wijzigen, migreert de aannames niet. Bewaar historische universumlidmaatschappen en publicatietimestamps voor fundamentele of tekstuele features. Normaliseer en fit transformaties alleen op toegestane ontwikkeldata. Een feature uit een latere restatement kan toekomstige informatie lekken, zelfs wanneer de accountingperiode in het verleden lijkt te liggen.
Gebruik de officiële workflowstructuur als uitvoeringsgrens
Qlib's gedocumenteerde qrun-interface voert een geconfigureerde data-, model- en evaluatieworkflow uit en registreert artefacts. Lever een gereviewde configuratie aan in plaats van een agent de hele omgeving tijdens runtime te laten improviseren. Het commando hieronder is het officiële aanroeppatroon; de bestandsnaam staat voor je eigen volledige configuratie. Valideer datasetpad, regio, instrumentuniversum, benchmark en train/validation/test-segmenten vóór uitvoering. Een kleine datalaadcontrole moet duidelijk falen als vereiste historie of velden ontbreken.
# Requires an installed Qlib environment and a reviewed configuration.
qrun configuration.yaml
Inspecteer het volledige experimentele artefact
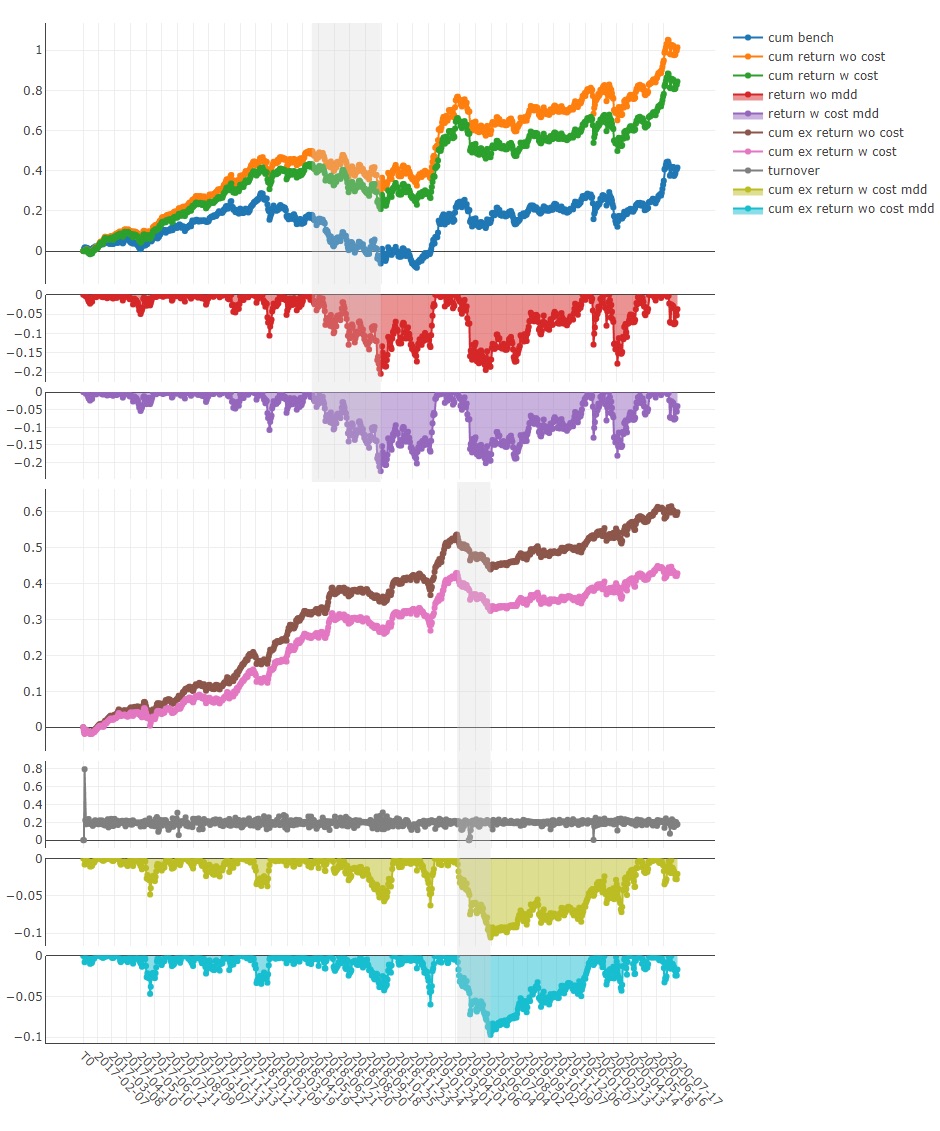
Bewaar kandidaatcode, configuratie, omgevingsidentiteit, seed waar relevant, datamanifest en geregistreerde outputs samen. Inspecteer risico, turnover en benchmarkcontext naast elk headline-resultaat. De officiële Qlib-figuur illustreert welke analyses een kwantitatieve workflow kan blootleggen. Het is een upstreamvoorbeeld en geen resultaat uit deze gids. Een grafiek is alleen nuttig wanneer onderliggende trades of signalen, inputaannames en evaluatieperiode kunnen worden geïnspecteerd, inclusief ongunstige intervallen.
Beheers het zoekproces en de uitvoeringsomgeving
Geef gegenereerde code een disposable omgeving met begrensde resources en alleen de datasets en tools die nodig zijn. Review netwerktoegang, file mounts en secret exposure vóór uitvoering. Beperk het aantal kandidaat-revisies en bewaar afgewezen experimenten. Als een agent herhaaldelijk een holdoutscore gebruikt om code te verbeteren, is die score ontwikkelfeedback geworden. Reserveer een werkelijk onaangeraakt evaluatievenster of een ander vooraf gedeclareerd evaluatieontwerp. Vergelijk kandidaten met een passende baseline en registreer elke selectiebeslissing en niet alleen de uiteindelijke implementatie.
Budgetteer modelwerk en berekening afzonderlijk
Volg hypothesegeneratie, coderevisies, embeddings en modelretries in een requestledger. Volg training, simulatie, opslag en data-access in een afzonderlijke resourceledger die via experiment-ID wordt gekoppeld. Een lokale cache kan herhaald werk verminderen maar moet op code- en data-identiteit worden gesleuteld; anders kan ze een resultaat van een andere kandidaat teruggeven. Stop wanneer iteratie- of computebudget is bereikt. Vat de best ondersteunde bevinding en resterende onzekerheid samen in plaats van de agent eindeloos naar een gunstig resultaat te laten zoeken.
Bewijs en scope
Deze walkthrough put uit de officiële bronnen van RD-Agent, Qlib en FinRL hieronder. Het configuratiepatroon en de upstreamfiguur zijn brononderbouwd; voor deze pagina zijn geen RD-Agent-loop, Qlib-training, FinRL-policy of financieel rendement uitgevoerd of gemeten. Gebruik de gekoppelde RD-Agent-gids voor versie-specifieke modelconfiguratie en bewaar een afzonderlijk uitvoeringsrecord wanneer je je eigen experiment draait.
Veelgestelde vragen
Heeft Qlib een LLM API-key nodig?
De kern van de kwantitatieve workflow niet. Een gekoppelde researchagent kan chat- of embeddingcredentials nodig hebben, terwijl Qlib het geconfigureerde numerieke werk uitvoert.
Wanneer past FinRL beter dan een factorworkflow?
Wanneer de onderzoeksvraag gaat over sequentieel policy learning in een gedefinieerde omgeving. De omgeving en rewarddefinitie worden centrale delen van het experiment.
Kan de agent de testperiode kiezen?
Een reviewer moet evaluatiegrenzen vóór ontwikkeling goedkeuren. De agent gunstige perioden laten selecteren nadat hij resultaten heeft gezien, verzwakt het experiment.
Wat maakt een gegenereerde factor reproduceerbaar?
Bewaarde code, dataversie, kalender en aanpassingsregels, dependencyversies, preprocessingstatus en volledige evaluatieconfiguratie.
Wat moet ik doen wanneer gegenereerde code faalt?
Bewaar code en gestructureerd foutbewijs, herstel de kleinste getroffen fase in een nieuwe experimentversie en bewaar de oorspronkelijke poging in de zoekgeschiedenis.