Kos API Astra daripada penggunaan kepada kerja diterima
Updated 2026-09-05
Kira input biasa, bacaan cache, penulisan cache dan output secara berasingan. Gunakan kad kadar rasmi semasa serta lejar permintaan lengkap untuk menganggarkan tugas.
Pilih sistem pengebilan sebelum memilih kadar
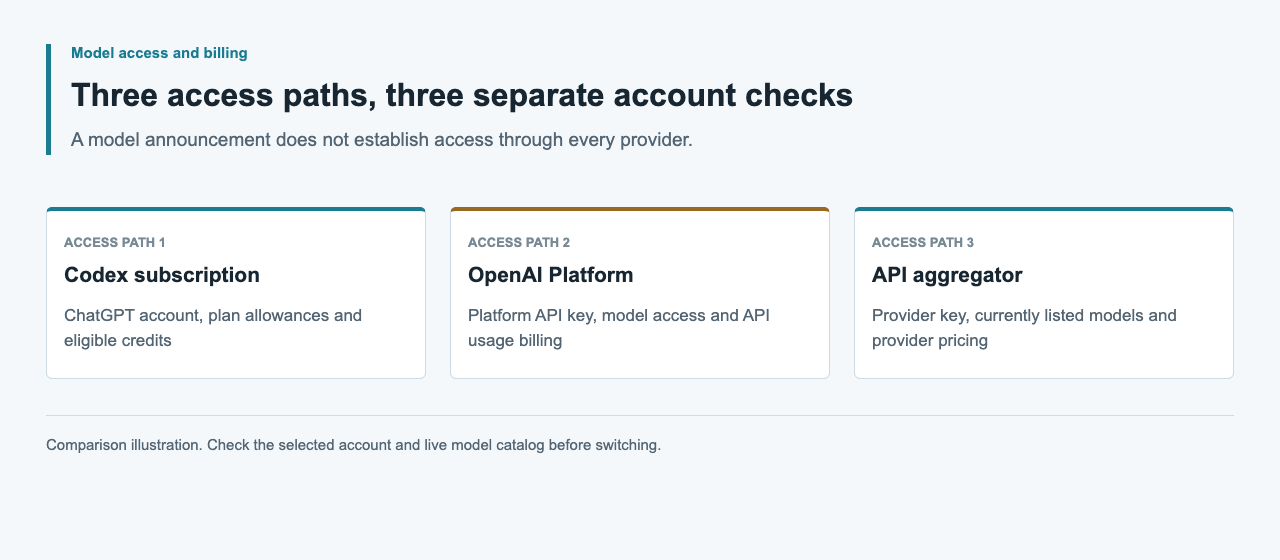
Permintaan API Astra terus menggunakan pengebilan OpenAI Platform. Kerja Codex yang disahkan ChatGPT menggunakan elaun dan kredit langganan atau ruang kerja. OpenAI menerbitkannya secara berasingan, jadi kadar kredit Codex bukan harga dolar bagi setiap token API dan giliran langganan yang termasuk bukan resit API.
Untuk permintaan terus, buka halaman harga API rasmi dan pilih kadar gpt-6-astra yang terpakai bagi tahap perkhidmatan, jalur konteks dan aturan pemprosesan. Simpan URL kad kadar dan tarikh pemerhatian bersama anggaran. Bina pengiraan daripada penggunaan peringkat permintaan, kemudian bandingkan jumlah dengan rekod penggunaan dan bil Platform. Ini memudahkan anda mencari perbezaan pemilihan kadar atau permintaan yang hilang.
Tangkap medan penggunaan Responses yang tepat
Panduan caching prompt rasmi mendokumenkan input_tokens, input_tokens_details.cached_tokens dan input_tokens_details.cache_write_tokens. Bacaan cache dan penulisan cache ialah kategori berasingan dalam input, jadi tolak kedua-duanya sebelum mengira input biasa. Menganggap setiap token tidak cache menggunakan kadar input biasa boleh merendahkan anggaran permintaan yang menulis cache.
Panduan penaakulan mendokumenkan output_tokens dan output_tokens_details.reasoning_tokens. Token penaakulan termasuk dalam penggunaan output; jangan tambahnya sekali lagi sebagai kategori token berbayar. Kekalkan total_tokens sebagai jumlah penggunaan, bukan bilangan yang didarab dengan satu kadar campuran. Rekodkan objek penggunaan penuh supaya rekonsiliasi kemudian tidak bergantung pada log teks sahaja yang tidak lengkap.
| Medan Responses | Maksud | Rawatan perakaunan |
|---|---|---|
| usage.input_tokens | Jumlah token input | Asingkan input biasa, bacaan cache dan penulisan cache |
| usage.input_tokens_details.cached_tokens | Token input cache | Gunakan kadar input cache |
| usage.input_tokens_details.cache_write_tokens | Token input yang ditulis ke cache | Gunakan kadar penulisan cache |
| usage.output_tokens | Token output termasuk penaakulan | Gunakan kadar output sekali sahaja |
| usage.output_tokens_details.reasoning_tokens | Penaakulan dalam output | Kekalkan sebagai subset diagnostik |
| usage.total_tokens | Jumlah penggunaan input dan output | Kekalkan untuk rekonsiliasi |
Kira subtotal token tanpa kiraan berganda
Biarkan I ialah token input, C input cache, W input penulisan cache dan O token output. Input biasa ialah I - C - W. Dengan kadar R_input, R_cached, R_write dan R_output yang disebut dalam mata wang sama bagi setiap juta token, subtotal token ialah ((I - C - W) * R_input + C * R_cached + W * R_write + O * R_output) / 1,000,000.
Fungsi luar talian di bawah menerima penggunaan diperhatikan dan kad kadar yang dipilih berasingan. Nama kadarnya ialah pemboleh ubah aplikasi, bukan medan API. Ia mengembalikan null untuk input hilang atau tidak konsisten dan bukannya menganggap penggunaan tidak diketahui sebagai percuma. Hasilnya meliputi token sahaja, bukan alat, cukai atau item bil lain.
function estimateTokenCost(usage, rates) {
  const I = usage?.input_tokens
  const C = usage?.input_tokens_details?.cached_tokens
  const W = usage?.input_tokens_details?.cache_write_tokens
  const O = usage?.output_tokens
  const tokens = [I, C, W, O]
  const prices = [rates?.input, rates?.cached, rates?.write, rates?.output]
  if (!tokens.every(n => Number.isSafeInteger(n) && n >= 0)) return null
  if (!prices.every(n => Number.isFinite(n) && n >= 0)) return null
  if (C > I || W > I - C) return null
  const subtotal = ((I - C - W) * rates.input
    + C * rates.cached + W * rates.write
    + O * rates.output) / 1_000_000
  return Number.isFinite(subtotal) ? subtotal : null
}
Selesaikan peraturan konteks dan tahap perkhidmatan bagi setiap permintaan
Harga rasmi Astra membezakan input biasa, input cache, penulisan cache dan output, dengan jalur konteks dan tahap perkhidmatan berbeza. Selesaikan peraturan itu untuk setiap permintaan sebelum membekalkan kadar kepada formula. Jangan gunakan pengganda sekali lagi jika anda sudah memilih baris kad kadar yang merangkuminya.
Simpan metadata tahap perkhidmatan dan pemprosesan bersama respons dan bandingkan dengan perkara yang diminta. Jangan gunakan semula pengganda kelajuan atau kredit Codex untuk kiraan API terus kerana ia tergolong dalam jadual harga produk lain. Untuk aturan pemprosesan luar biasa, rekonsiliasikan dengan terma penyedia yang terpakai. Formula token yang betul dengan asas kadar yang salah masih merupakan anggaran kos yang salah.
Asingkan anggaran token daripada kos tugas lengkap
Tugas boleh memerlukan beberapa permintaan model, panggilan alat dan semakan. Tambah subtotal token bagi setiap permintaan direkod, kemudian tambah alat atau perkhidmatan penyedia yang dibilkan berasingan mengikut penggunaan dan harga sebenar. Keupayaan model memanggil alat tidak bermaksud alat itu termasuk tanpa caj tambahan.
Kekalkan infrastruktur, perbelanjaan penjanaan aset dan masa semakan manusia dalam kategori berasingan. Lampirkan resit perkhidmatan dan tempoh yang diliputinya, serta peruntukkan kos bersama secara konsisten merentas tugas. Untuk permainan, kelompok penyetempatan atau tugas penyelidikan, nyatakan komponen yang termasuk dalam jumlah. Asingkan cukai dan penukaran mata wang daripada kadar token supaya subtotal penggunaan dan jumlah akhir yang dibayar kedua-duanya boleh direkonsiliasikan.
| Komponen kos | Bukti untuk disimpan | Peraturan gabungan |
|---|---|---|
| Token model | Penggunaan Responses serta kadar API yang terpakai | Jumlahkan subtotal permintaan |
| Alat atau perkhidmatan penyedia | Penggunaan alat dan kategori harga rasmi | Tambah item yang dibilkan berasingan |
| Runtime atau aset lain | Resit perkhidmatan dan atribusi | Laporkan dalam kategori berasingan |
| Semakan manusia | Masa direkod dan kaedah penilaian dinyatakan | Kekalkan berbeza daripada perbelanjaan API |
Jadikan percubaan semula, kerja tidak lengkap dan penggunaan hilang kelihatan
Panduan penaakulan OpenAI memberi amaran bahawa penjanaan tidak lengkap boleh menggunakan token input dan penaakulan tanpa menghasilkan teks kelihatan. Kira penggunaan yang benar-benar dipulangkan walaupun hasil gagal pemeriksaan penerimaan. Jangan hadkan lejar kepada jawapan akhir berjaya atau anggar perbelanjaan daripada panjang jawapan sahaja.
Bagi setiap percubaan, simpan identiti respons, model, status, penggunaan dan tugas berkaitan. Rekonsiliasikan pendua sebelum menjumlahkan. Jika sambungan gagal dan tiada penggunaan tiba, tandakan percubaan belum selesai sehingga rekod penyedia menjelaskannya; kos sifar atau kejayaan penuh belum terbukti. Hadkan percubaan supaya kesilapan sementara tidak menghasilkan siri percubaan berbayar tanpa semakan.
Belanjakan sekitar hasil diterima dan kerja terhad
Tentukan unit kerja diterima sebelum mengukurnya: perubahan kod diuji, rekod produk-locale diluluskan atau nota penyelidikan berpautan sumber. Kos setiap unit diterima ialah kos tugas boleh atribusi dibahagi bilangan unit diterima, hanya apabila bilangannya bukan sifar. Laporkan sampel dan penggunaan belum selesai bersama nisbah.
Gunakan siling permintaan, percubaan terhad dan syarat berhenti tugas secara bersama. Medan max_output_tokens yang didokumenkan mengehadkan penjanaan, termasuk penaakulan, tetapi bukan belanjawan mata wang lengkap untuk tugas berbilang permintaan. Tetapkan kawalan akaun dan jejak perbelanjaan terkumpul juga. Konteks lebih kecil atau tetapan penaakulan berbeza perlu dinilai dengan kriteria penerimaan sama, bukan diiklankan sebagai penjimatan terjamin.
Ketersediaan penyedia dan bukti: 5 September 2026
Medan penggunaan dan formula panduan ini datang daripada dokumentasi OpenAI rasmi. Tiada kos tugas Astra atau runtime diukur untuk artikel ini. Pada 5 September 2026, endpoint harga awam APIsRouter mengembalikan HTTP 200, success: true dan 34 model tanpa Astra atau GPT-6, jadi tiada sebut harga Astra APIsRouter di sini.
Gunakan harga OpenAI semasa untuk permintaan Astra terus dan katalog APIsRouter langsung untuk tawarannya sendiri. Perbandingan penyedia memerlukan tugas sepadan, identiti model sebenar, output diterima, penggunaan lengkap dan kadar terpakai. Simpan rekod tersebut bersama pengiraan supaya pembaca dapat membezakan anggaran daripada bil tugas yang direkonsiliasikan.
Soalan lazim
Apakah harga API Astra semasa?
Gunakan halaman harga API OpenAI rasmi untuk gpt-6-astra. Pilih tahap perkhidmatan dan jalur konteks yang terpakai kepada permintaan, termasuk kadar bacaan cache dan penulisan cache berasingan.
Adakah token penaakulan dicaj selain output_tokens?
Token penaakulan termasuk dalam penggunaan output. Gunakan kadar output kepada output_tokens sekali sahaja; simpan output_tokens_details.reasoning_tokens untuk diagnosis dan jangan tambahnya lagi.
Bagaimanakah penulisan cache mempengaruhi formula?
Tolak cached_tokens dan cache_write_tokens daripada jumlah input untuk mendapatkan input biasa. Harga input biasa, bacaan cache dan penulisan cache secara berasingan menggunakan kadar rasmi yang terpakai.
Adakah tamat masa atau jawapan tidak lengkap percuma?
Tidak semestinya. Penjanaan tidak lengkap boleh menggunakan token dan tamat masa boleh meninggalkan bukti pengebilan belum selesai. Kekalkan penggunaan yang dipulangkan dan rekonsiliasikan rekod hilang dan bukannya menetapkan kos sifar.
Berapakah kos tugas Astra melalui APIsRouter?
Tiada sebut harga daripada semakan 5 September 2026 kerana Astra tiada dalam katalog. Semak tawaran semasa dan gunakan harga OpenAI untuk anggaran Astra terus.