Configuration de RD-Agent et Qlib
Updated 2026-09-06
Configurez la couche de modèle de l'agent de recherche, validez séparément ses embeddings et préparez l'environnement quantitatif local avant de démarrer une expérience itérative.
Attribuez des responsabilités distinctes à RD-Agent et Qlib
Utilisez RD-Agent pour développer et réviser des implémentations de recherche et Qlib pour exécuter un workflow quantitatif configuré. Les appels de modèle de l'agent peuvent proposer des hypothèses, écrire du code et interpréter le feedback. Qlib gère ses données, son entraînement et son évaluation dans l'environnement d'expérience. Une clé API de modèle ne résout donc qu'une seule dépendance. Avant la configuration, choisissez le scénario RD-Agent précis, figez la révision du projet et définissez les limites du jeu de données et de l'évaluation. Vous séparerez ainsi la préparation de l'environnement des décisions de recherche que l'agent prendra.
Configurez le chat et l'embedding via le backend documenté
À la révision examinée 32b3d395, le fichier .env.example de RD-Agent documente le backend LiteLLM, le modèle de chat et la base compatible OpenAI, ainsi qu'une route d'embedding séparée préfixée par proxy. Le modèle shell ci-dessous mappe des emplacements de modèles gérés par l'application vers ces champs documentés. Choisissez un modèle de chat actuel après avoir vérifié ses capacités. EMBEDDING_BASE_URL et EMBEDDING_MODEL_ID doivent désigner un service d'embedding disponible indépendamment ; ne supposez pas que la passerelle de chat en fournit un. Fournissez les deux identifiants via l'environnement et utilisez la commande de démarrage documentée par le scénario de votre version figée.
export BACKEND=rdagent.oai.backend.LiteLLMAPIBackend
export OPENAI_API_BASE=https://api.apisrouter.com/v1
export CHAT_MODEL="openai/$RESEARCH_MODEL_ID"
# Set OPENAI_API_KEY securely for the chat endpoint.

export LITELLM_PROXY_API_BASE="$EMBEDDING_BASE_URL"
export EMBEDDING_MODEL="litellm_proxy/$EMBEDDING_MODEL_ID"
# Set LITELLM_PROXY_API_KEY securely for the embedding service.
Validez indépendamment les deux capacités de modèle
Vérifiez que le client de chat sélectionné peut effectuer le format de réponse et le comportement d'outil requis par le scénario. Vérifiez que les embeddings produisent un vecteur non vide, une dimension cohérente et une identité de modèle stable. Changer de modèle d'embedding peut nécessiter de reconstruire les vecteurs stockés ; une réponse de chat réussie ne valide pas la récupération. Le schéma étayé par les sources montre uniquement la route de chat proposée. Les préfixes de fournisseur LiteLLM sélectionnent le comportement du client et ne sont pas nécessairement l'ID du modèle vu par l'endpoint ; conservez donc à la fois la valeur configurée et l'identité réelle de la requête.
Préparez l'environnement quantitatif avant la boucle de l'agent
Vérifiez le jeu de données, l'environnement Python et le conteneur d'exécution autorisé avec un petit contrôle déterministe. Pour une recherche internationale, alignez la région du jeu de données, le calendrier de marché et l'univers d'instruments sur le marché visé. La documentation du workflow Qlib prend en charge une région US, mais son jeu de données et ses hypothèses d'exemple ne doivent pas être copiés tels quels vers un autre marché. Confirmez la couverture historique, la politique d'ajustement et l'identité du benchmark. Ce n'est qu'ensuite qu'il faut laisser un agent générer du code candidat contre cet environnement ; sinon les révisions répétées du modèle peuvent simplement compenser une configuration de données cassée.
Inspectez ensemble l'hypothèse, le code et le feedback
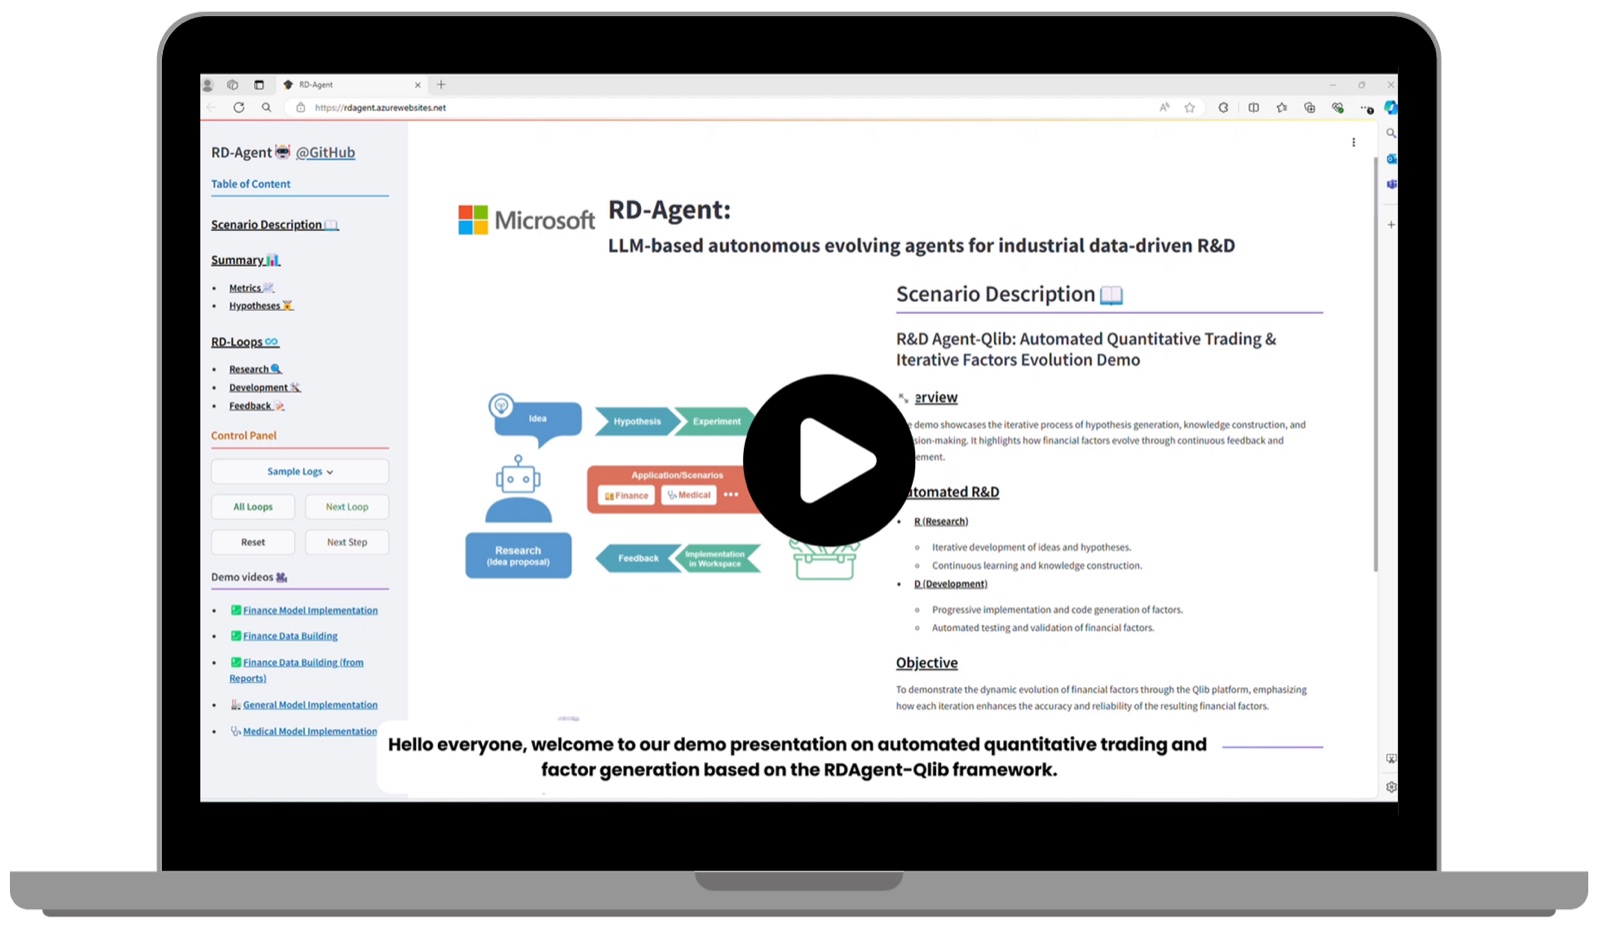
L'illustration officielle de RD-Agent montre une interface de recherche itérative. Utilisez cette structure pour vous rappeler de conserver chaque hypothèse avec son implémentation et son feedback, au lieu de ne sauvegarder que le rapport final. Un relecteur doit pouvoir distinguer une correction d'erreur logicielle, un changement de question de recherche et une sélection de candidate différente après observation d'un score. Gardez les expériences rejetées accessibles et séparez la sortie de l'outil de l'interprétation qu'en fait l'agent.
Limitez l'exécution du code et préservez l'indépendance de l'évaluation
Exécutez le code généré avec des limites explicites de système de fichiers, de réseau et de ressources. Ne montez que les jeux de données requis et évitez d'exposer des identifiants sans rapport. Figez les fenêtres d'entraînement, de validation et d'évaluation réservée avant le développement itératif. Si le feedback du test est renvoyé à plusieurs reprises à l'agent, enregistrez que la période de test est devenue partie du processus de développement. Le manifeste d'expérience doit inclure la révision source, le hash du code, la version des données, la configuration, l'identité de l'environnement et la décision de sélection. Les exécutions réussies comme les échecs méthodologiques seront ainsi visibles pour le prochain relecteur.
Suivez les coûts et récupérez l'étape échouée
Reliez le registre des requêtes de chat et d'embedding au registre de calcul local à l'aide des identifiants d'expérience. Les estimations de coûts LiteLLM ne sont pas nécessairement les frais réels de la passerelle ; rapprochez-les de la preuve de facturation applicable. Séparez une défaillance de transport du modèle, un écart d'index vectoriel, une exception de code et des données Qlib manquantes en états différents. Réessayez les appels temporaires dans un budget et conservez les erreurs de code pour inspection. Évitez de redémarrer toute la boucle lorsqu'un seul artefact source ou une requête modèle doit être corrigé et invalidez les caches lorsque le modèle, le code ou le jeu de données pertinent change.
Preuves et limites
Les champs d'environnement et le comportement du backend ont été examinés dans la révision officielle 32b3d395 le 5 septembre 2026. L'invocation et les responsabilités Qlib suivent sa documentation officielle. Aucune requête client de projet, aucun résultat d'embedding ni aucune boucle RD-Agent/Qlib complète n'a été exécuté via APIsRouter pour ce guide. L'étape d'acceptation suivante est un scénario délimité avec entrées conservées, preuves de requêtes et sorties numériques.
Questions fréquentes
Qlib utilise-t-il OPENAI_API_BASE ?
Cette variable configure le chemin du modèle de l'agent décrit ici. Qlib effectue lui-même le travail de données, de modèle et d'évaluation dans son propre runtime.
Puis-je utiliser un fournisseur d'embedding séparé ?
Le modèle examiné documente un LITELLM_PROXY_API_BASE et une clé séparés avec un modèle préfixé par litellm_proxy. Vérifiez indépendamment le service choisi et la compatibilité vectorielle.
Pourquoi le modèle de chat a-t-il un préfixe openai/ ?
Il sélectionne le fournisseur compatible dans LiteLLM. Vérifiez l'ID du modèle réellement envoyé lors de la validation de l'endpoint au lieu de supposer que chaque préfixe est transmis tel quel.
Un salut de chat valide-t-il la boucle de recherche ?
Non. Il teste une opération client. Les embeddings, la récupération, l'exécution du code, les données Qlib et l'évaluation finale exigent chacun un résultat observable propre.
Que conserver lorsque l'agent modifie le code ?
Gardez l'ancien code, le nouveau code, l'hypothèse, le feedback et l'identité de l'expérience afin que les relecteurs puissent reconstruire la recherche et détecter une fuite d'évaluation.