Workflows de recherche quantitative par l'IA
Updated 2026-09-06
Utilisez des agents pour proposer et implémenter des hypothèses, puis laissez des données versionnées et des expériences reproductibles les évaluer. Gardez la conversation du modèle et le calcul numérique distincts.
Transformez une idée en expérience falsifiable
Écrivez le mécanisme que vous voulez tester, les variables observables, l'univers visé et les conditions qui réfuteraient l'idée. Un agent peut aider à traduire cette spécification en code, mais ne doit pas redéfinir le critère de réussite après avoir vu les résultats. Séparez les questions d'implémentation des questions de recherche : un facteur peut être calculé correctement et ne contenir aucun signal utile. Enregistrez une petite spécification avant la première requête de génération de code afin de pouvoir comparer l'expérience finale à l'intention d'origine.
Attribuez le bon rôle à RD-Agent, Qlib et FinRL
RD-Agent automatise des parties du développement de la recherche, notamment l'implémentation itérative et le feedback. Qlib fournit un workflow quantitatif pour les données, les modèles et l'évaluation. FinRL fournit des environnements de recherche pour l'apprentissage par renforcement. Ces projets peuvent intervenir à des étapes différentes, mais ne sont pas des clients de chat interchangeables. Les requêtes LLM appartiennent à la couche de raisonnement et de codage de l'agent. La construction des facteurs, l'entraînement, la simulation et les métriques consomment du calcul dans l'environnement d'expérience. Enregistrez les deux chemins afin de ne pas confondre un budget de modèle avec le budget complet de ressources.
| Composant | Travail principal | Ce que vous devez fournir |
|---|---|---|
| Agent de recherche | Hypothèse, implémentation, révision | Contrat de tâche et outils autorisés |
| Qlib | Évaluation des données, de l'entraînement, du signal et du portefeuille | Jeu de données compatible et configuration d'expérience |
| FinRL | Entraînement d'une politique dans un environnement de marché | Environnement, définition de la récompense et conception de l'évaluation |
| Relecteur humain | Méthodologie et interprétation | Critères d'acceptation indépendants |
Fixez le contrat de données avant de générer des facteurs
Documentez l'identité des instruments, les fuseaux horaires, la politique d'ajustement, le calendrier et le traitement des valeurs manquantes. Pour une recherche sur les actions américaines, utilisez un jeu de données américain approprié et une configuration régionale correspondante ; modifier le libellé d'un exemple provenant d'un autre marché ne transpose pas ses hypothèses. Conservez l'appartenance historique à l'univers et les horodatages de publication pour les facteurs fondamentaux ou textuels. Normalisez et ajustez les transformations uniquement sur les données de développement autorisées. Un facteur calculé à partir d'un retraitement ultérieur peut introduire une fuite d'information future même si sa période comptable semble appartenir au passé.
Utilisez la structure officielle du workflow comme frontière d'exécution
L'interface qrun documentée de Qlib exécute un workflow configuré de données, de modèle et d'évaluation et enregistre des artefacts. Fournissez une configuration relue au lieu de demander à un agent d'improviser tout l'environnement à l'exécution. La commande ci-dessous est le modèle d'invocation officiel ; le nom de fichier représente votre propre configuration complète. Validez le chemin du jeu de données, la région, l'univers d'instruments, le benchmark et les segments entraînement/validation/test avant l'exécution. Un petit contrôle de chargement des données doit échouer clairement si l'historique ou les champs requis sont indisponibles.
# Requires an installed Qlib environment and a reviewed configuration.
qrun configuration.yaml
Inspectez l'artefact complet de l'expérience
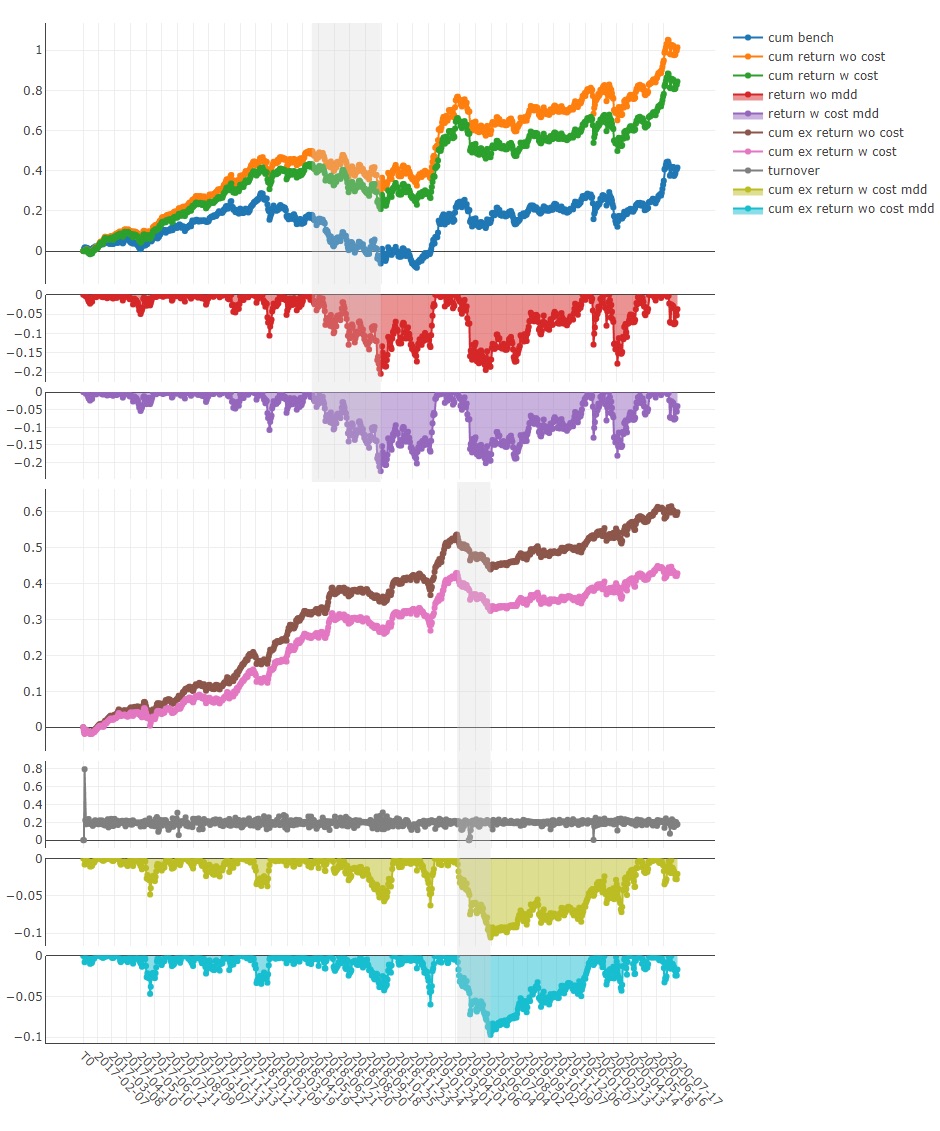
Conservez ensemble le code candidat, la configuration, l'identité de l'environnement, la seed lorsqu'elle est pertinente, le manifeste de données et les sorties enregistrées. Inspectez le risque, le turnover et le contexte du benchmark ainsi que tout résultat mis en avant. La figure officielle de Qlib illustre les types d'analyses qu'un workflow quantitatif peut exposer. Il s'agit d'un exemple amont, et non d'un résultat de ce guide. Un graphique n'est utile que lorsque les transactions ou signaux sous-jacents, les hypothèses d'entrée et la période d'évaluation peuvent être inspectés, y compris les intervalles défavorables.
Contrôlez le processus de recherche et l'environnement d'exécution
Donnez au code généré un environnement jetable aux ressources limitées, avec uniquement les jeux de données et outils nécessaires. Relisez l'accès réseau, les montages de fichiers et l'exposition des secrets avant l'exécution. Limitez le nombre de révisions candidates et conservez les expériences rejetées. Si un agent utilise à plusieurs reprises un score réservé pour améliorer le code, ce score est devenu un feedback de développement. Réservez une fenêtre d'évaluation véritablement intacte ou une autre conception d'évaluation prédéclarée. Comparez les candidates à une base appropriée et enregistrez chaque décision de sélection, pas seulement l'implémentation finale.
Budgez séparément le travail du modèle et le calcul
Suivez la génération d'hypothèses, les révisions de code, les embeddings et les nouvelles tentatives du modèle dans un registre de requêtes. Suivez l'entraînement, la simulation, le stockage et l'accès aux données dans un registre de ressources séparé, relié par l'identifiant d'expérience. Un cache local peut réduire le travail répété, mais doit être indexé par l'identité du code et des données ; sinon il peut renvoyer le résultat d'une autre candidate. Arrêtez-vous lorsque le budget d'itérations ou de calcul est atteint. Résumez le résultat le mieux étayé et l'incertitude restante au lieu de laisser l'agent chercher indéfiniment un résultat favorable.
Preuves et périmètre
Cette présentation s'appuie sur les sources officielles de RD-Agent, Qlib et FinRL liées ci-dessous. Le modèle de configuration et la figure amont sont étayés par les sources ; aucune boucle RD-Agent, aucun entraînement Qlib, aucune politique FinRL ni aucun rendement financier n'a été exécuté ou mesuré pour cette page. Utilisez le guide RD-Agent lié pour la configuration des modèles spécifique à la version et conservez un enregistrement d'exécution séparé lorsque vous lancez votre propre expérience.
Questions fréquentes
Qlib a-t-il besoin d'une clé API LLM ?
Son workflow quantitatif de base n'en a pas besoin. Un agent de recherche associé peut nécessiter des identifiants de chat ou d'embedding, tandis que Qlib réalise le calcul numérique configuré.
Quand FinRL convient-il mieux qu'un workflow de facteurs ?
Lorsque la question de recherche porte sur l'apprentissage séquentiel d'une politique dans un environnement défini. L'environnement et la conception de la récompense deviennent alors des parties centrales de l'expérience.
L'agent peut-il choisir la période de test ?
Un relecteur doit approuver les limites d'évaluation avant le développement. Laisser l'agent choisir des périodes favorables après avoir vu les résultats affaiblit l'expérience.
Qu'est-ce qui rend un facteur généré reproductible ?
Le code conservé, la version des données, le calendrier et les règles d'ajustement, les versions des dépendances, l'état du prétraitement et la configuration complète de l'évaluation.
Que faire lorsque le code généré échoue ?
Conservez le code et les preuves structurées de l'échec, corrigez la plus petite étape concernée dans une nouvelle version de l'expérience et gardez la tentative originale dans l'historique de recherche.