הגדרת RD-Agent ו-Qlib
Updated 2026-09-06
הגדירו את שכבת מודל סוכן המחקר, אמתו embeddings בנפרד והכינו את הסביבה הכמותית המקומית לפני התחלת ניסוי איטרטיבי.
הקצו ל-RD-Agent ול-Qlib אחריויות נפרדות
השתמשו ב-RD-Agent כדי לפתח ולתקן מימושי מחקר, וב-Qlib כדי לבצע תהליך כמותי מוגדר. קריאות המודל של הסוכן יכולות להציע היפותזות, לכתוב קוד ולפרש משוב. Qlib מטפל בנתונים, באימון ובהערכה שלו בסביבת הניסוי. לכן מפתח API של מודל פותר רק תלות אחת. לפני ההגדרה בחרו תרחיש RD-Agent מסוים, קבעו revision לפרויקט והגדירו את גבולות מערך הנתונים וההערכה. כך הכנת הסביבה נשארת נפרדת מהחלטות המחקר שהסוכן יקבל.
הגדירו chat ו-embedding דרך ה-backend המתועד
ב-revision שנבדק 32b3d395, קובץ .env.example של RD-Agent מתעד את backend של LiteLLM, מודל chat ו-base תואם OpenAI, לצד נתיב embedding נפרד עם קידומת proxy. תבנית ה-shell שלהלן ממפה משבצות מודל שבבעלות היישום לשדות המתועדים האלה. בחרו מודל chat עדכני לאחר בדיקת היכולות שלו. EMBEDDING_BASE_URL ו-EMBEDDING_MODEL_ID חייבים להתייחס לשירות embedding זמין באופן עצמאי; אל תניחו שה-gateway של chat מספק אחד. ספקו את שני פרטי הגישה דרך הסביבה והשתמשו בפקודת ההפעלה המתועדת של התרחיש עבור הגרסה שקיבעתם.
export BACKEND=rdagent.oai.backend.LiteLLMAPIBackend
export OPENAI_API_BASE=https://api.apisrouter.com/v1
export CHAT_MODEL="openai/$RESEARCH_MODEL_ID"
# Set OPENAI_API_KEY securely for the chat endpoint.

export LITELLM_PROXY_API_BASE="$EMBEDDING_BASE_URL"
export EMBEDDING_MODEL="litellm_proxy/$EMBEDDING_MODEL_ID"
# Set LITELLM_PROXY_API_KEY securely for the embedding service.
אמתו את שתי יכולות המודל בנפרד
בדקו שלקוח ה-chat שנבחר יכול לבצע את פורמט התגובה ואת התנהגות הכלים הנדרשים לתרחיש. בדקו embeddings עבור וקטור שאינו ריק, ממד עקבי וזהות מודל יציבה. שינוי מודל embedding יכול לדרוש בנייה מחדש של וקטורים שמורים; תגובת chat מוצלחת אינה מאמתת אחזור. התרשים מבוסס המקור מציג רק את נתיב ה-chat המוצע. קידומות ספק של LiteLLM בוחרות התנהגות לקוח ואינן בהכרח מזהה המודל שנראה אצל ה-endpoint, לכן שמרו גם את הערך שהוגדר וגם את זהות הבקשה שנפתרה.
הכינו את הסביבה הכמותית לפני לולאת סוכן
אמתו את מערך הנתונים, סביבת Python ומכל הביצוע המותר באמצעות בדיקה דטרמיניסטית קטנה. במחקר בינלאומי התאימו אזור נתונים, לוח שנה שוק ויקום מכשירים לשוק המיועד. תיעוד תהליך Qlib תומך באזור US, אך אין להעתיק את מערך הנתונים וההנחות בדוגמה ללא שינוי לשוק אחר. אשרו כיסוי היסטורי, מדיניות התאמה וזהות benchmark. רק לאחר מכן אפשרו לסוכן ליצור קוד מועמד בסביבה הזו; אחרת תיקוני מודל חוזרים עלולים פשוט לפצות על הגדרת נתונים שבורה.
בדקו היפותזה, קוד ומשוב יחד
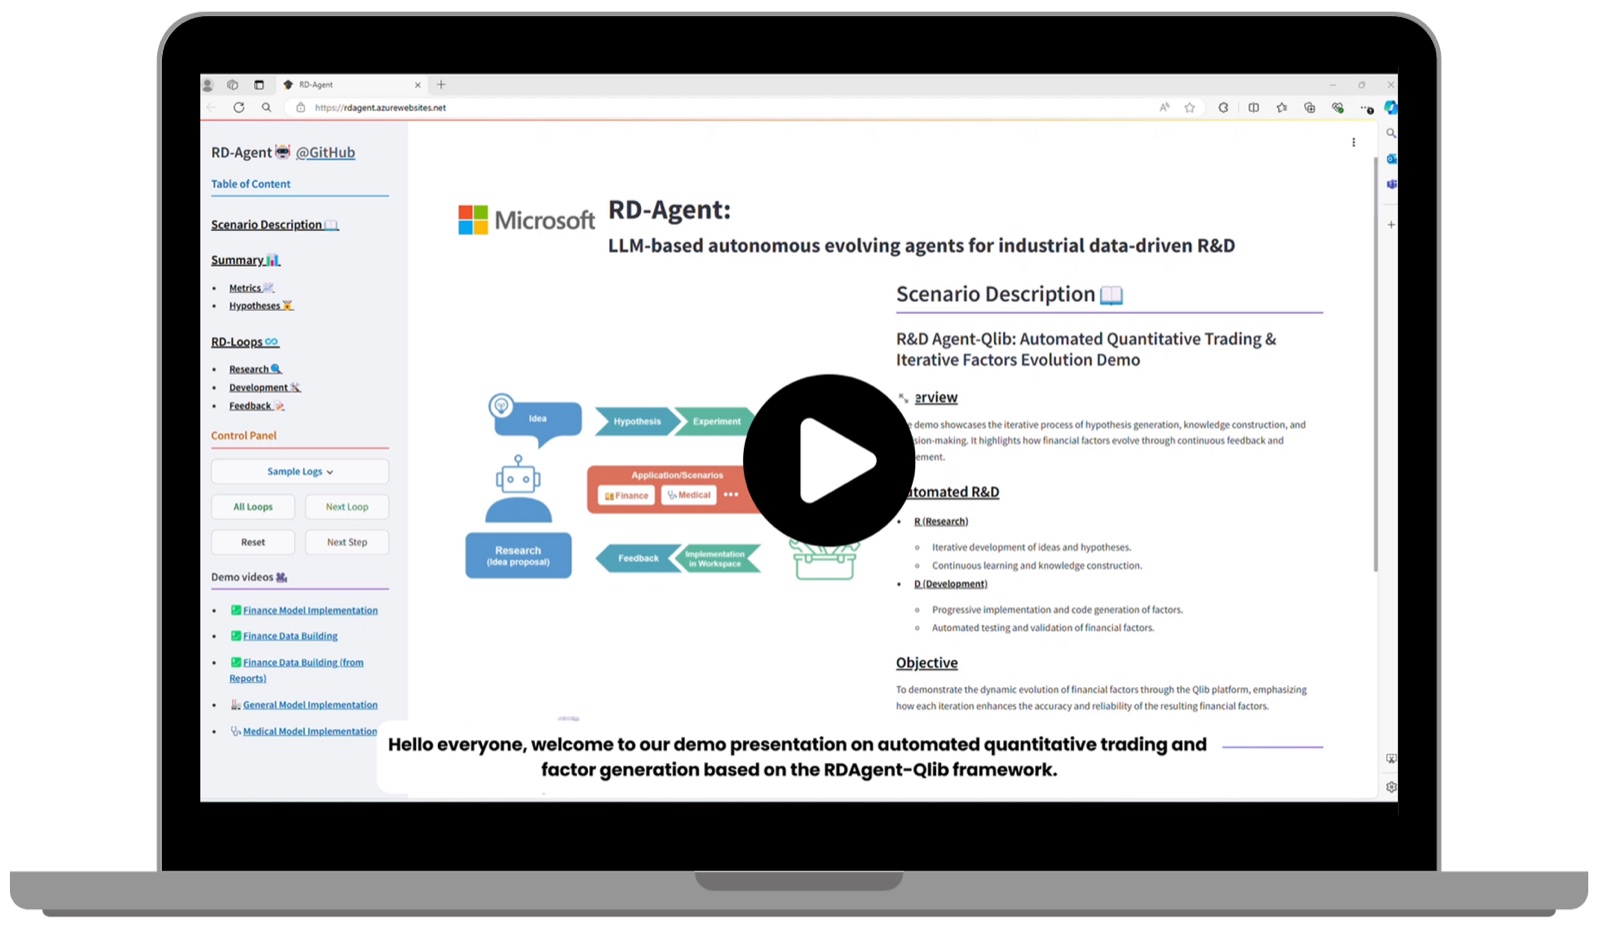
ההמחשה הרשמית של RD-Agent מציגה ממשק מחקר איטרטיבי. השתמשו במבנה הזה כתזכורת לשמור כל היפותזה עם המימוש והמשוב שלה, במקום לשמור רק את הדוח הסופי. בודק צריך להיות מסוגל לראות אם הסוכן תיקן שגיאת תוכנה, שינה את שאלת המחקר או בחר מועמד אחר לאחר צפייה בציון. שמרו ניסויים שנדחו נגישים והפרידו פלט כלי מהפרשנות של הסוכן לפלט הזה.
תחמו ביצוע קוד ושמרו על עצמאות ההערכה
הריצו קוד שנוצר עם מגבלות מפורשות של מערכת קבצים, רשת ומשאבים. עגנו רק מערכי נתונים נדרשים והימנעו מחשיפת פרטי גישה לא קשורים. הקפיאו חלונות train, validation והערכה hold-out לפני פיתוח איטרטיבי. אם משוב בדיקה מוחזר שוב ושוב לסוכן, תעדו שתקופת הבדיקה הפכה לחלק מתהליך הפיתוח. מניפסט ניסוי צריך לכלול revision מקור, hash קוד, גרסת נתונים, תצורה, זהות סביבה והחלטת בחירה. כך ביצוע מוצלח וכשל מתודולוגי נשארים גלויים לבודק הבא.
עקבו אחר עלויות ושחזרו את השלב שנכשל
חברו את יומן בקשות chat ו-embedding ליומן החישוב המקומי באמצעות מזהי ניסוי. אומדני עלות של LiteLLM אינם בהכרח החיובים בפועל של ה-gateway; התאימו אותם לרשומת החיוב הרלוונטית. הפרידו כשל תעבורת מודל, אי-התאמת vector-index, חריגת קוד ונתוני Qlib חסרים למצבים שונים. חזרו על קריאות זמניות בתוך תקציב ושמרו שגיאות קוד לבדיקה. הימנעו מהתחלה מחדש של כל הלולאה כאשר רק artifact מקור אחד או בקשת מודל דורשים תיקון, ובטלו caches כאשר המודל, הקוד או מערך הנתונים הרלוונטיים משתנים.
ראיות ומגבלות
שדות הסביבה והתנהגות ה-backend נבדקו במקור הרשמי revision 32b3d395 ב-5 בספטמבר 2026. הקריאה ל-Qlib והאחריויות עוקבות אחר התיעוד הרשמי שלו. עבור מדריך זה לא בוצעה דרך APIsRouter בקשת project-client, תוצאת embedding או לולאת RD-Agent/Qlib מלאה. שלב הקבלה הבא הוא תרחיש מוגבל עם קלטים שמורים, ראיות בקשות ופלטים מספריים.
שאלות נפוצות
האם Qlib משתמש ב-OPENAI_API_BASE?
המשתנה הזה מגדיר את נתיב מודל הסוכן שמתואר כאן. Qlib עצמו מבצע עבודת נתונים, מודל והערכה בסביבת הריצה שלו.
האם אפשר להשתמש בספק embedding נפרד?
התבנית שנבדקה מתעדת LITELLM_PROXY_API_BASE ומפתח נפרדים עם מודל בקידומת litellm_proxy. אמתו את השירות שנבחר ואת תאימות הווקטור בנפרד.
מדוע למודל chat יש קידומת openai/?
היא בוחרת את הספק התואם בתוך LiteLLM. בדקו את מזהה המודל שנפתר בבקשה בעת אימות ה-endpoint, במקום להניח שכל קידומת מועברת ללא שינוי.
האם hello של chat יאמת את תהליך המחקר?
לא. הוא בודק פעולת לקוח אחת. Embeddings, אחזור, ביצוע קוד, נתוני Qlib וההערכה הסופית דורשים כל אחד תוצאה ניתנת לצפייה משלו.
מה לשמור כאשר הסוכן משנה קוד?
שמרו קוד קודם, קוד חדש, היפותזה, משוב וזהות ניסוי כדי שבודקים יוכלו לשחזר את החיפוש ולזהות דליפת הערכה.