Configurazione di RD-Agent e Qlib
Updated 2026-09-06
Configura il livello modello dell'agente di ricerca, valida separatamente gli embedding e prepara l'ambiente quantitativo locale prima di iniziare un esperimento iterativo.
Assegna responsabilità distinte a RD-Agent e Qlib
Usa RD-Agent per sviluppare e revisionare implementazioni di ricerca e Qlib per eseguire un flusso quantitativo configurato. Le chiamate al modello dell'agente possono proporre ipotesi, scrivere codice e interpretare feedback. Qlib gestisce dati, training e valutazione nel proprio ambiente sperimentale. Una chiave API del modello risolve quindi una sola dipendenza. Prima della configurazione scegli lo scenario RD-Agent specifico, fissa la revisione del progetto e definisci confini di dataset e valutazione. Così la preparazione dell'ambiente resta separata dalle decisioni di ricerca che prenderà l'agente.
Configura chat ed embedding attraverso il backend documentato
Alla revisione 32b3d395, il file .env.example di RD-Agent documenta backend LiteLLM, modello chat e base compatibile con OpenAI, oltre a un percorso embedding separato con prefisso proxy. Il template shell seguente mappa gli slot modello di proprietà dell'applicazione nei campi documentati. Scegli un modello chat corrente dopo averne controllato le capacità. EMBEDDING_BASE_URL e EMBEDDING_MODEL_ID devono riferirsi a un servizio embedding indipendentemente disponibile; non presumere che il gateway chat ne fornisca uno. Fornisci entrambe le credenziali tramite ambiente e usa il comando di avvio documentato dallo scenario per la versione fissata.
export BACKEND=rdagent.oai.backend.LiteLLMAPIBackend
export OPENAI_API_BASE=https://api.apisrouter.com/v1
export CHAT_MODEL="openai/$RESEARCH_MODEL_ID"
# Set OPENAI_API_KEY securely for the chat endpoint.

export LITELLM_PROXY_API_BASE="$EMBEDDING_BASE_URL"
export EMBEDDING_MODEL="litellm_proxy/$EMBEDDING_MODEL_ID"
# Set LITELLM_PROXY_API_KEY securely for the embedding service.
Valida indipendentemente le due capacità del modello
Controlla che il client chat selezionato possa eseguire il formato di risposta e il comportamento degli strumenti richiesti dallo scenario. Controlla che gli embedding producano un vettore non vuoto, una dimensione coerente e un'identità modello stabile. Cambiare modello embedding può richiedere di ricostruire i vettori memorizzati; una risposta chat riuscita non convalida il retrieval. Il diagramma basato sulla fonte mostra solo il percorso chat proposto. I prefissi provider LiteLLM selezionano il comportamento del client e non sono necessariamente l'ID modello visto dall'endpoint, quindi conserva sia il valore configurato sia l'identità della richiesta risolta.
Prepara l'ambiente quantitativo prima del loop dell'agente
Verifica dataset, ambiente Python e container di esecuzione consentito con un piccolo controllo deterministico. Per ricerca internazionale allinea regione del dataset, calendario di mercato e universo degli strumenti al mercato previsto. La documentazione del flusso Qlib supporta una regione USA, ma il dataset di esempio e le sue ipotesi non dovrebbero essere copiati senza modifiche in un altro mercato. Conferma copertura storica, policy di aggiustamento e identità del benchmark. Solo allora abilita un agente a generare codice candidato su quell'ambiente; altrimenti revisioni ripetute del modello possono semplicemente compensare una configurazione dati rotta.
Ispeziona insieme ipotesi, codice e feedback
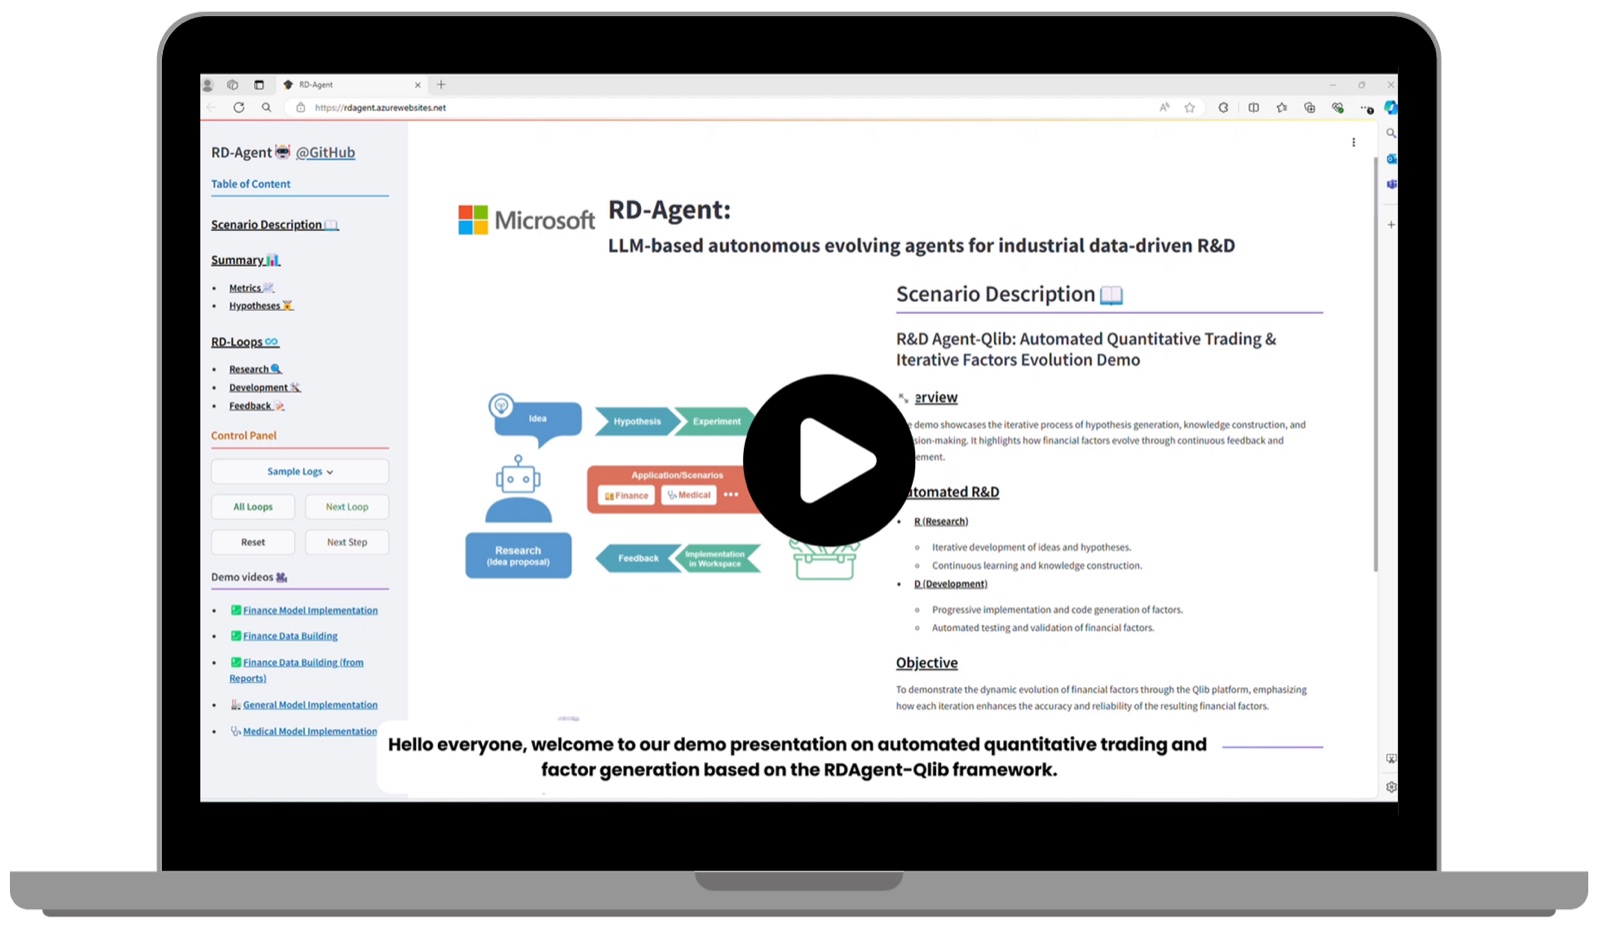
L'illustrazione ufficiale di RD-Agent mostra un'interfaccia di ricerca iterativa. Usa quella struttura come promemoria per conservare ogni ipotesi con implementazione e feedback, invece di salvare solo il report finale. Un revisore dovrebbe capire se l'agente ha corretto un errore software, cambiato la domanda di ricerca o selezionato un altro candidato dopo aver visto uno score. Mantieni accessibili gli esperimenti rifiutati e separa output degli strumenti dall'interpretazione dell'agente.
Limita l'esecuzione del codice e preserva l'indipendenza della valutazione
Esegui codice generato con limiti espliciti su filesystem, rete e risorse. Monta solo i dataset necessari ed evita di esporre credenziali non pertinenti. Congela finestre train, validation e valutazione holdout prima dello sviluppo iterativo. Se il feedback del test viene restituito ripetutamente all'agente, registra che il periodo di test è entrato nel processo di sviluppo. Un manifest dell'esperimento dovrebbe includere revisione della fonte, hash del codice, versione dei dati, configurazione, identità dell'ambiente e decisione di selezione. Così sia l'esecuzione riuscita sia il fallimento metodologico restano visibili al revisore successivo.
Traccia i costi e recupera la fase fallita
Collega il ledger delle richieste chat ed embedding al ledger del calcolo locale usando gli experiment ID. Le stime di costo LiteLLM non sono necessariamente gli addebiti effettivi del gateway; riconcilia con il record di fatturazione applicabile. Separa un errore di trasporto del modello, un mismatch dell'indice vettoriale, un'eccezione del codice e dati Qlib mancanti in stati diversi. Ripeti le chiamate transitorie entro un budget e conserva gli errori di codice per l'ispezione. Evita di riavviare l'intero loop quando richiede correzione un solo artefatto fonte o una richiesta modello e invalida le cache quando cambia modello, codice o dataset rilevante.
Evidenze e limiti
I campi dell'ambiente e il comportamento del backend sono stati revisionati nella fonte ufficiale 32b3d395 il 5 settembre 2026. L'invocazione Qlib e le responsabilità seguono la documentazione ufficiale. Per questa guida non sono state eseguite tramite APIsRouter richieste del client progetto, risultati embedding o un loop RD-Agent/Qlib completo. Il prossimo passaggio di accettazione è uno scenario circoscritto con input conservati, evidenze delle richieste e output numerici.
Domande frequenti
Qlib usa OPENAI_API_BASE?
Quella variabile configura il percorso del modello agente descritto qui. Qlib esegue dati, modello e valutazione nel proprio runtime.
Posso usare un provider embedding separato?
Il template revisionato documenta un LITELLM_PROXY_API_BASE separato e la relativa chiave con un modello dal prefisso litellm_proxy. Verifica separatamente il servizio scelto e la compatibilità dei vettori.
Perché il modello chat ha il prefisso openai/?
Seleziona il provider compatibile in LiteLLM. Controlla l'ID modello della richiesta risolta quando validi l'endpoint invece di presumere che ogni prefisso venga inoltrato invariato.
Un hello chat convalida il loop di ricerca?
No. Testa una singola operazione client. Embedding, retrieval, esecuzione codice, dati Qlib e valutazione finale richiedono ciascuno un proprio risultato osservabile.
Cosa devo conservare quando l'agente cambia codice?
Conserva codice precedente e nuovo, ipotesi, feedback e identità dell'esperimento, così i revisori possono ricostruire la ricerca e rilevare leakage della valutazione.