RD-Agent 및 Qlib 구성
Updated 2026-09-06
리서치 에이전트 모델 계층을 구성하고 임베딩을 별도로 검증한 뒤 반복 실험을 시작하기 전에 로컬 정량 환경을 준비하세요.
RD-Agent와 Qlib에 서로 다른 책임을 부여하세요
RD-Agent는 리서치 구현을 개발하고 수정하는 데, Qlib는 구성된 정량 워크플로를 실행하는 데 사용하세요. 에이전트의 모델 호출은 가설을 제안하고 코드를 작성하며 피드백을 해석할 수 있습니다. Qlib는 실험 환경에서 데이터, 학습, 평가를 처리합니다. 따라서 모델 API 키는 의존성 하나만 해결합니다. 설정하기 전에 구체적인 RD-Agent 시나리오를 선택하고 프로젝트 리비전을 고정하며 데이터셋과 평가 경계를 정의하세요. 그러면 환경 준비와 에이전트가 내릴 리서치 결정을 분리할 수 있습니다.
문서화된 백엔드를 통해 채팅과 임베딩을 구성하세요
검토된 리비전 32b3d395에서 RD-Agent의 .env.example은 LiteLLM 백엔드, 채팅 모델, OpenAI 호환 base, 별도의 프록시 접두 임베딩 경로를 문서화합니다. 아래 셸 템플릿은 애플리케이션이 소유한 모델 슬롯을 해당 문서화 필드에 매핑합니다. 기능을 확인한 뒤 현재 채팅 모델을 선택하세요. EMBEDDING_BASE_URL과 EMBEDDING_MODEL_ID는 독립적으로 이용 가능한 임베딩 서비스를 가리켜야 합니다. 채팅 게이트웨이가 임베딩도 제공한다고 가정하지 마세요. 두 자격 증명은 환경을 통해 제공하고 고정한 버전의 시나리오 문서에 있는 시작 명령을 사용하세요.
export BACKEND=rdagent.oai.backend.LiteLLMAPIBackend
export OPENAI_API_BASE=https://api.apisrouter.com/v1
export CHAT_MODEL="openai/$RESEARCH_MODEL_ID"
# Set OPENAI_API_KEY securely for the chat endpoint.

export LITELLM_PROXY_API_BASE="$EMBEDDING_BASE_URL"
export EMBEDDING_MODEL="litellm_proxy/$EMBEDDING_MODEL_ID"
# Set LITELLM_PROXY_API_KEY securely for the embedding service.
두 모델 기능을 독립적으로 검증하세요
선택한 채팅 클라이언트가 시나리오에 필요한 응답 형식과 도구 동작을 수행할 수 있는지 확인하세요. 임베딩은 비어 있지 않은 벡터, 일관된 차원, 안정적인 모델 식별자를 확인합니다. 임베딩 모델을 바꾸면 저장된 벡터를 다시 구축해야 할 수 있으며 성공적인 채팅 응답만으로 검색이 검증되지는 않습니다. 출처에 기반한 다이어그램은 제안된 채팅 경로만 보여줍니다. LiteLLM 제공업체 접두사는 클라이언트 동작을 선택하며 엔드포인트에서 보이는 모델 ID와 반드시 같지는 않으므로 구성 값과 해결된 요청 식별자를 모두 보존하세요.
에이전트 루프 전에 정량 환경을 준비하세요
작은 결정론적 확인으로 데이터셋, Python 환경, 허용된 실행 컨테이너를 검증하세요. 국제 리서치에서는 데이터셋 지역, 시장 캘린더, 금융상품 모집단을 의도한 시장과 맞춥니다. Qlib 워크플로 문서는 미국 지역을 지원하지만 예시 데이터셋과 가정을 다른 시장에 변경 없이 복사해서는 안 됩니다. 과거 커버리지, 조정 정책, 벤치마크 식별자를 확인하세요. 그 환경에서 에이전트가 후보 코드를 생성하도록 허용하기 전에 이 작업을 완료합니다. 그렇지 않으면 반복되는 모델 수정이 단순히 깨진 데이터 설정을 보상할 수 있습니다.
가설, 코드, 피드백을 함께 검사하세요
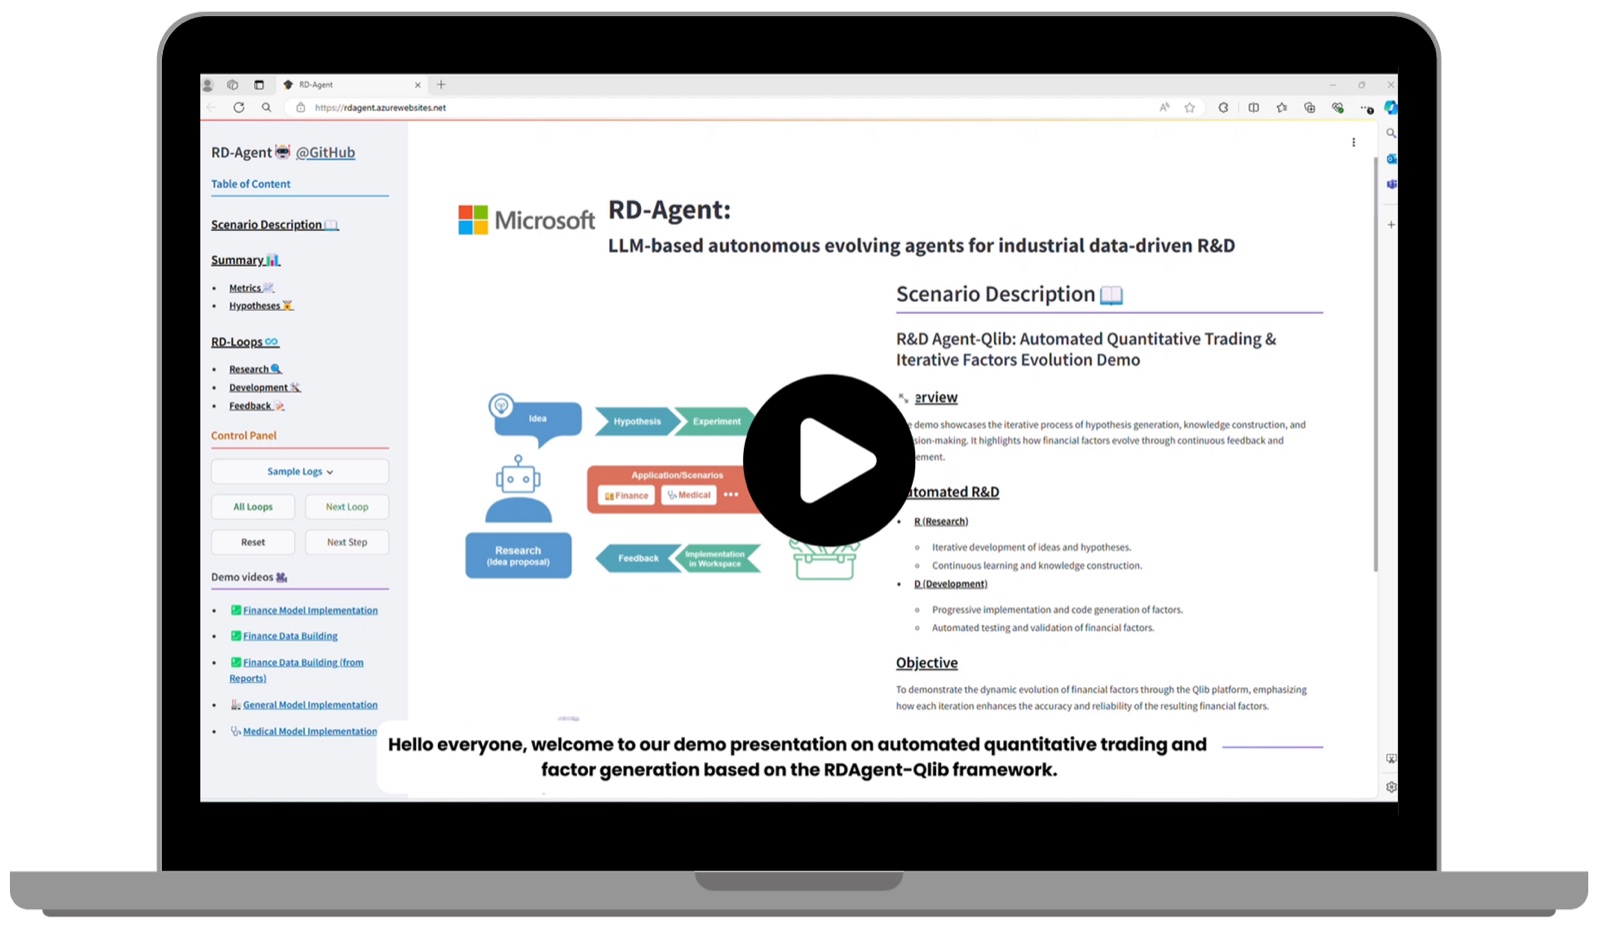
RD-Agent 공식 일러스트레이션은 반복적인 리서치 인터페이스를 보여줍니다. 최종 보고서만 저장하지 말고 각 가설을 구현 및 피드백과 함께 보존하라는 알림으로 이 구조를 사용하세요. 검토자는 에이전트가 소프트웨어 오류를 고쳤는지, 리서치 질문을 바꿨는지, 점수를 본 뒤 다른 후보를 선택했는지 알 수 있어야 합니다. 거부된 실험을 계속 접근 가능하게 두고 도구 출력과 에이전트의 해석을 분리하세요.
코드 실행에 상한을 두고 평가 독립성을 보존하세요
생성된 코드는 명시적인 파일 시스템, 네트워크, 리소스 제한 아래 실행하세요. 필요한 데이터셋만 마운트하고 관련 없는 자격 증명을 노출하지 마세요. 반복 개발 전에 학습, 검증, 홀드아웃 평가 구간을 동결합니다. 테스트 피드백이 에이전트로 반복해서 반환되면 테스트 기간이 개발 과정의 일부가 되었다고 기록하세요. 실험 매니페스트에는 소스 리비전, 코드 해시, 데이터 버전, 구성, 환경 식별자, 선택 결정이 포함되어야 합니다. 이를 통해 성공적인 실행과 방법론적 실패를 다음 검토자에게 모두 드러낼 수 있습니다.
비용을 추적하고 실패한 단계를 복구하세요
실험 ID를 사용해 채팅 및 임베딩 요청 원장을 로컬 계산 원장에 연결하세요. LiteLLM 비용 추정은 게이트웨이의 실제 요금과 반드시 같지 않으므로 적용되는 결제 기록과 대조합니다. 모델 전송 실패, 벡터 인덱스 불일치, 코드 예외, Qlib 데이터 누락을 서로 다른 상태로 분리하세요. 예산 안에서 일시적인 호출만 재시도하고 코드 오류는 검사할 수 있게 보존합니다. 하나의 소스 산출물이나 모델 요청만 수정하면 될 때 전체 루프를 다시 시작하지 말고 관련 모델, 코드, 데이터셋이 바뀌면 캐시를 무효화하세요.
근거와 한계
환경 필드와 백엔드 동작은 2026년 9월 5일 공식 소스 리비전 32b3d395에서 검토되었습니다. Qlib 호출과 책임은 공식 문서를 따릅니다. 이 가이드를 위해 APIsRouter를 통한 프로젝트 클라이언트 요청, 임베딩 결과, 완전한 RD-Agent/Qlib 루프를 실행하지 않았습니다. 다음 승인 단계는 보존된 입력, 요청 근거, 수치 출력이 있는 범위가 정해진 시나리오입니다.
자주 묻는 질문
Qlib가 OPENAI_API_BASE를 사용하나요?
이 페이지에서 설명한 에이전트 모델 경로를 구성하는 변수입니다. Qlib 자체는 고유한 런타임에서 데이터, 모델, 평가 작업을 수행합니다.
별도의 임베딩 제공업체를 사용할 수 있나요?
검토된 템플릿은 litellm_proxy-prefixed 모델과 함께 별도의 LITELLM_PROXY_API_BASE와 키를 문서화합니다. 선택한 서비스와 벡터 호환성을 독립적으로 검증하세요.
채팅 모델에 openai/ 접두사가 붙는 이유는 무엇인가요?
LiteLLM에서 호환 제공업체를 선택합니다. 모든 접두사가 변경 없이 전달된다고 가정하지 말고 엔드포인트를 검증할 때 해결된 요청 모델 ID를 확인하세요.
채팅 hello가 리서치 루프를 검증하나요?
아니요. 클라이언트 작업 하나를 테스트할 뿐입니다. 임베딩, 검색, 코드 실행, Qlib 데이터, 최종 평가는 각각 자체 관찰 결과가 필요합니다.
에이전트가 코드를 바꿀 때 무엇을 보존해야 하나요?
검토자가 검색 과정을 재구성하고 평가 누출을 탐지할 수 있도록 이전 코드, 새 코드, 가설, 피드백, 실험 식별자를 보존하세요.