Configuración de RD-Agent y Qlib
Updated 2026-09-06
Configura la capa de modelos del agente de investigación, valida sus embeddings por separado y prepara el entorno cuantitativo local antes de iniciar un experimento iterativo.
Asigna responsabilidades distintas a RD-Agent y Qlib
Usa RD-Agent para desarrollar y revisar implementaciones de investigación y Qlib para ejecutar un flujo cuantitativo configurado. Las llamadas del agente al modelo pueden proponer hipótesis, escribir código e interpretar feedback. Qlib gestiona sus datos, entrenamiento y evaluación en el entorno del experimento. Por tanto, una clave de API de modelo resuelve solo una dependencia. Antes de configurar, elige el escenario específico de RD-Agent, fija la revisión del proyecto y define los límites del conjunto de datos y la evaluación. Así la preparación del entorno queda separada de las decisiones de investigación que tomará el agente.
Configura chat y embeddings mediante el backend documentado
En la revisión 32b3d395, el archivo .env.example de RD-Agent documenta el backend LiteLLM, el modelo de chat y una base compatible con OpenAI, además de una ruta de embeddings independiente con prefijo de proxy. La plantilla de shell de abajo asigna espacios de modelo propiedad de la aplicación a esos campos documentados. Elige un modelo de chat actual después de comprobar sus capacidades. EMBEDDING_BASE_URL y EMBEDDING_MODEL_ID deben referirse a un servicio de embeddings disponible de forma independiente; no supongas que el gateway de chat proporciona uno. Proporciona ambas credenciales mediante el entorno y usa el comando de inicio documentado por el escenario para tu versión fijada.
export BACKEND=rdagent.oai.backend.LiteLLMAPIBackend
export OPENAI_API_BASE=https://api.apisrouter.com/v1
export CHAT_MODEL="openai/$RESEARCH_MODEL_ID"
# Set OPENAI_API_KEY securely for the chat endpoint.

export LITELLM_PROXY_API_BASE="$EMBEDDING_BASE_URL"
export EMBEDDING_MODEL="litellm_proxy/$EMBEDDING_MODEL_ID"
# Set LITELLM_PROXY_API_KEY securely for the embedding service.
Valida las dos capacidades del modelo de forma independiente
Comprueba que el cliente de chat seleccionado pueda realizar el formato de respuesta y el comportamiento de herramientas requeridos por el escenario. Comprueba que los embeddings produzcan un vector no vacío, una dimensión coherente y una identidad estable del modelo. Cambiar el modelo de embeddings puede exigir reconstruir los vectores almacenados; una respuesta de chat correcta no valida la recuperación. El diagrama respaldado por fuentes muestra solo la ruta de chat propuesta. Los prefijos de proveedor de LiteLLM seleccionan el comportamiento del cliente y no son necesariamente el ID de modelo que ve el endpoint, así que conserva tanto el valor configurado como la identidad de solicitud resuelta.
Prepara el entorno cuantitativo antes del ciclo del agente
Verifica el conjunto de datos, el entorno Python y el contenedor de ejecución permitido con una comprobación determinista pequeña. Para investigación internacional, alinea la región del conjunto de datos, el calendario de mercado y el universo de instrumentos con el mercado previsto. La documentación del flujo de Qlib admite una región estadounidense, pero no debes copiar sin cambios su conjunto de datos y supuestos a otro mercado. Confirma la cobertura histórica, la política de ajustes y la identidad del benchmark. Solo después permite que un agente genere código candidato contra ese entorno; de lo contrario, las revisiones repetidas del modelo pueden limitarse a compensar una configuración de datos rota.
Inspecciona juntos la hipótesis, el código y el feedback
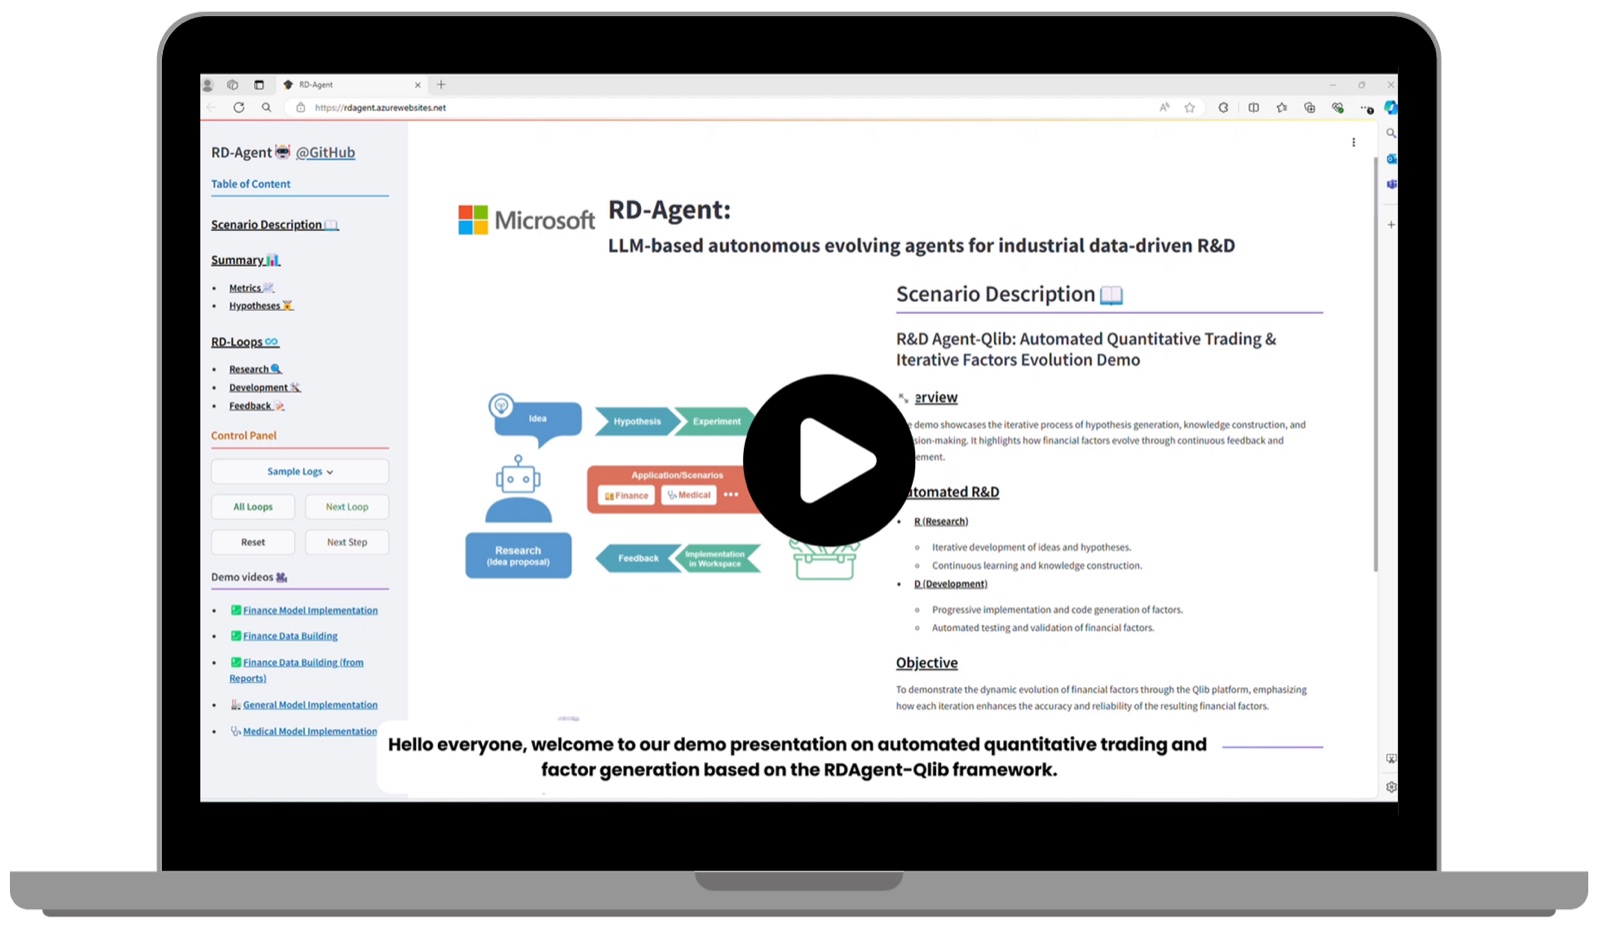
La ilustración oficial de RD-Agent muestra una interfaz de investigación iterativa. Usa esa estructura como recordatorio para conservar cada hipótesis con su implementación y feedback, en lugar de guardar solo el informe final. Un revisor debe poder saber si el agente corrigió un error de software, cambió la pregunta de investigación o seleccionó otro candidato después de ver una puntuación. Mantén accesibles los experimentos rechazados y separa la salida de herramientas de la interpretación que hace el agente de esa salida.
Acota la ejecución de código y conserva la independencia de la evaluación
Ejecuta el código generado con límites explícitos de sistema de archivos, red y recursos. Monta solo los conjuntos de datos necesarios y evita exponer credenciales no relacionadas. Congela las ventanas de entrenamiento, validación y evaluación retenida antes del desarrollo iterativo. Si el feedback de prueba se devuelve repetidamente al agente, registra que el periodo de prueba pasó a formar parte del proceso de desarrollo. Un manifiesto del experimento debe incluir la revisión de fuente, el hash del código, la versión de datos, la configuración, la identidad del entorno y la decisión de selección. Esto hace visibles tanto la ejecución correcta como el fallo metodológico para el siguiente revisor.
Sigue los costes y recupera la etapa fallida
Une el registro de solicitudes de chat y embeddings con el registro de cálculo local usando IDs de experimento. Las estimaciones de costes de LiteLLM no son necesariamente los cargos reales del gateway; concilia con el registro de facturación aplicable. Separa en estados distintos un fallo de transporte del modelo, una discrepancia del índice vectorial, una excepción de código y datos ausentes de Qlib. Reintenta las llamadas transitorias dentro de un presupuesto y conserva los errores de código para inspección. Evita reiniciar todo el ciclo cuando solo necesite corrección un artefacto de fuente o una solicitud del modelo e invalida las cachés cuando cambien el modelo, el código o el conjunto de datos pertinentes.
Evidencia y límites
Los campos del entorno y el comportamiento del backend se revisaron en la revisión oficial de fuente 32b3d395 el 5 de septiembre de 2026. La invocación y las responsabilidades de Qlib siguen su documentación oficial. Para esta guía no se ejecutaron mediante APIsRouter ninguna solicitud del cliente del proyecto, resultado de embeddings ni ciclo completo de RD-Agent/Qlib. El siguiente paso de aceptación es un escenario acotado con entradas conservadas, evidencia de solicitudes y salidas numéricas.
Preguntas frecuentes
¿Qlib usa OPENAI_API_BASE?
Esa variable configura la ruta del modelo del agente descrita aquí. Qlib realiza el trabajo de datos, modelo y evaluación en su propio runtime.
¿Puedo usar un proveedor de embeddings separado?
La plantilla revisada documenta una LITELLM_PROXY_API_BASE y una clave separadas con un modelo con prefijo litellm_proxy. Verifica de forma independiente el servicio elegido y la compatibilidad vectorial.
¿Por qué el modelo de chat tiene un prefijo openai/?
Selecciona el proveedor compatible en LiteLLM. Comprueba el ID de modelo de la solicitud resuelta al validar el endpoint en lugar de suponer que todo prefijo se reenvía sin cambios.
¿Un saludo del chat valida el ciclo de investigación?
No. Prueba una operación del cliente. Los embeddings, la recuperación, la ejecución de código, los datos de Qlib y la evaluación final necesitan cada uno su propio resultado observable.
¿Qué debe conservarse cuando el agente cambia el código?
Conserva el código anterior y el nuevo, la hipótesis, el feedback y la identidad del experimento para que los revisores puedan reconstruir la búsqueda y detectar filtraciones de evaluación.