Flujos de investigación cuantitativa con IA
Updated 2026-09-06
Usa agentes para proponer e implementar hipótesis y deja que los datos versionados y los experimentos reproducibles las evalúen. Mantén separadas la conversación del modelo y el cálculo numérico.
Convierte una idea en un experimento refutable
Escribe el mecanismo que quieres probar, las variables observables, el universo previsto y las condiciones que rechazarían la idea. Un agente puede ayudar a traducir esa especificación a código, pero no debe redefinir el criterio de éxito después de ver los resultados. Separa las preguntas de implementación de las preguntas de investigación: un factor puede calcularse correctamente y aun así no contener ninguna señal útil. Guarda una especificación pequeña antes de la primera solicitud de generación de código para poder comparar el experimento final con la intención original.
Elige la función correcta para RD-Agent, Qlib y FinRL
RD-Agent automatiza partes del desarrollo de investigación, incluida la implementación iterativa y el feedback. Qlib proporciona un flujo cuantitativo para datos, modelos y evaluación. FinRL ofrece entornos de investigación de aprendizaje por refuerzo. Estos proyectos pueden informar etapas distintas, pero no son clientes de chat intercambiables. Las solicitudes al LLM pertenecen a la capa de razonamiento y programación del agente. La construcción de variables, el entrenamiento, la simulación y las métricas consumen cálculo en el entorno del experimento. Registra ambas rutas para que el presupuesto del modelo no se confunda con el presupuesto completo de recursos.
| Componente | Trabajo principal | Qué debes proporcionar |
|---|---|---|
| Agente de investigación | Hipótesis, implementación y revisión | Contrato de tarea y herramientas permitidas |
| Qlib | Datos, entrenamiento, señal y evaluación de cartera | Conjunto de datos compatible y configuración del experimento |
| FinRL | Entrenamiento de políticas en un entorno de mercado | Entorno, definición de recompensa y diseño de evaluación |
| Revisor humano | Metodología e interpretación | Criterios de aceptación independientes |
Corrige el contrato de datos antes de generar factores
Documenta la identidad del instrumento, las zonas horarias, la política de ajustes, el calendario y el tratamiento de valores ausentes. Para investigación de acciones estadounidenses, usa un conjunto de datos estadounidense adecuado y una configuración regional correcta; cambiar una etiqueta en un ejemplo de otro mercado no traslada sus supuestos. Conserva la pertenencia histórica al universo y las marcas de tiempo de publicación para las variables fundamentales o textuales. Normaliza y ajusta las transformaciones solo con los datos de desarrollo permitidos. Una variable calculada a partir de una reformulación posterior puede filtrar información futura aunque su periodo contable parezca pertenecer al pasado.
Usa la estructura del flujo oficial como límite de ejecución
La interfaz qrun documentada de Qlib ejecuta un flujo configurado de datos, modelo y evaluación y registra artefactos. Proporciona una configuración revisada en lugar de pedir a un agente que improvise todo el entorno durante la ejecución. El comando de abajo es el patrón de invocación oficial; el nombre de archivo representa tu propia configuración completa. Valida la ruta del conjunto de datos, la región, el universo de instrumentos, el benchmark y los segmentos de entrenamiento/validación/prueba antes de ejecutar. Una comprobación pequeña de carga de datos debe fallar claramente si el historial o los campos necesarios no están disponibles.
# Requires an installed Qlib environment and a reviewed configuration.
qrun configuration.yaml
Inspecciona el artefacto completo del experimento
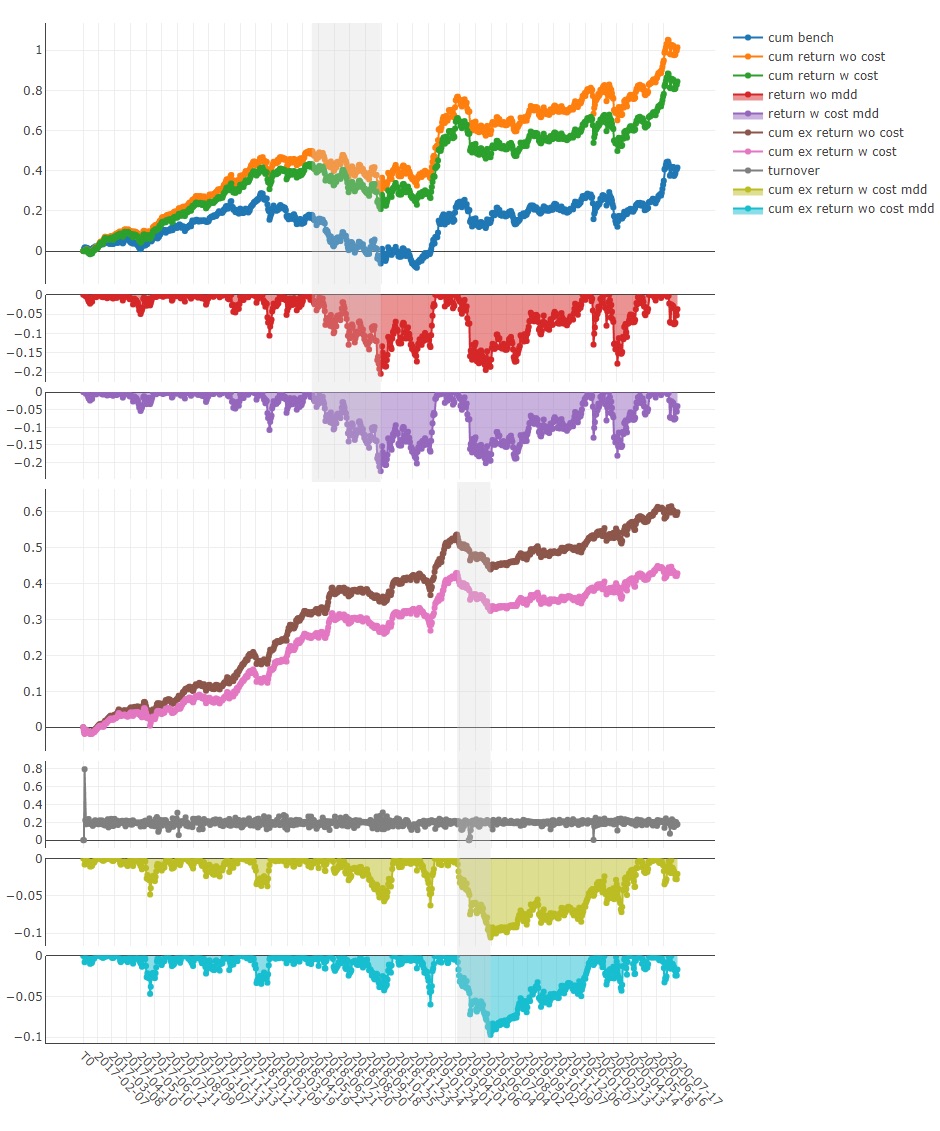
Mantén juntos el código candidato, la configuración, la identidad del entorno, la semilla cuando corresponda, el manifiesto de datos y las salidas registradas. Inspecciona el riesgo, la rotación y el contexto del benchmark además de cualquier resultado destacado. La figura oficial de Qlib ilustra los tipos de análisis que puede exponer un flujo cuantitativo. Es un ejemplo service, no un resultado de esta guía. Un gráfico solo es útil cuando pueden inspeccionarse las operaciones o señales subyacentes, los supuestos de entrada y el periodo de evaluación, incluidos los intervalos desfavorables.
Controla el proceso de búsqueda y el entorno de ejecución
Da al código generado un entorno desechable y limitado en recursos, con solo los conjuntos de datos y herramientas que necesita. Revisa el acceso a red, los montajes de archivos y la exposición de secretos antes de ejecutar. Limita el número de revisiones candidatas y conserva los experimentos rechazados. Si un agente usa repetidamente una puntuación retenida para mejorar el código, esa puntuación se ha convertido en feedback de desarrollo. Reserva una ventana de evaluación realmente intacta u otro diseño de evaluación declarado de antemano. Compara los candidatos con una línea base adecuada y registra cada decisión de selección, no solo la implementación final.
Presupuesta por separado el trabajo del modelo y el cálculo
Sigue la generación de hipótesis, las revisiones de código, los embeddings y los reintentos del modelo en un registro de solicitudes. Sigue el entrenamiento, la simulación, el almacenamiento y el acceso a datos en un registro de recursos separado, unido por el ID del experimento. Una caché local puede reducir el trabajo repetido, pero debe estar indexada por la identidad del código y los datos; de lo contrario puede devolver un resultado de otro candidato. Detente cuando se alcance el presupuesto de iteraciones o cálculo. Resume el hallazgo mejor respaldado y la incertidumbre restante en lugar de dejar que el agente busque indefinidamente un resultado favorable.
Evidencia y alcance
Este recorrido se basa en las fuentes oficiales de RD-Agent, Qlib y FinRL enlazadas abajo. El patrón de configuración y la figura service están respaldados por fuentes; para esta página no se ejecutó ni midió ningún ciclo de RD-Agent, entrenamiento de Qlib, política de FinRL o retorno financiero. Usa la guía enlazada de RD-Agent para la configuración específica de la versión y conserva un registro de ejecución separado cuando realices tu propio experimento.
Preguntas frecuentes
¿Qlib necesita una clave de API de LLM?
Su flujo cuantitativo central no. Un agente de investigación conectado puede necesitar credenciales de chat o embeddings, mientras Qlib ejecuta el trabajo numérico configurado.
¿Cuándo encaja mejor FinRL que un flujo de factores?
Cuando la pregunta de investigación se refiere al aprendizaje secuencial de políticas en un entorno definido. El entorno y el diseño de la recompensa se convierten en partes centrales del experimento.
¿Puede el agente elegir el periodo de prueba?
Un revisor debe aprobar los límites de evaluación antes del desarrollo. Permitir que el agente seleccione periodos favorables después de ver los resultados debilita el experimento.
¿Qué hace reproducible un factor generado?
Código conservado, versión de datos, reglas de calendario y ajustes, versiones de dependencias, estado de preprocesamiento y configuración completa de evaluación.
¿Qué hago cuando falla el código generado?
Conserva el código y la evidencia estructurada del fallo, corrige la etapa afectada más pequeña en una nueva versión del experimento y conserva el intento original en el historial de búsqueda.