Mga workflow sa AI quantitative research
Updated 2026-09-06
Gamitin ang agent sa pagmumungkahi at pagpapatupad ng hypothesis, saka hayaang suriin ito ng versioned data at reproducible experiment. Panatilihing hiwalay ang model conversation at numerical computation.
Gawing falsifiable experiment ang isang ideya
Isulat ang mekanismong gusto mong subukan, ang observable variable, nilalayong universe, at mga kondisyong tatanggi sa ideya. Makakatulong ang agent na isalin ang specification na iyon sa code, ngunit hindi nito dapat baguhin ang success criterion matapos makita ang mga resulta. Ihiwalay ang implementation question sa research question: maaaring tama ang pagkalkula ng factor ngunit wala pa ring kapaki-pakinabang na signal. Mag-save ng maliit na specification bago ang unang code-generation request upang maihambing ang naging experiment sa orihinal na layunin.
Piliin ang tamang papel ng RD-Agent, Qlib, at FinRL
Ina-automate ng RD-Agent ang bahagi ng research development, kabilang ang iterative implementation at feedback. Nagbibigay ang Qlib ng quantitative workflow para sa data, model, at evaluation. Nagbibigay ang FinRL ng reinforcement-learning research environment. Maaaring tumulong ang mga project na ito sa magkakaibang stage, ngunit hindi sila mapagpapalit na chat client. Napapabilang ang LLM request sa reasoning at coding layer ng agent. Kumokonsumo ng computation sa experiment environment ang feature construction, training, simulation, at metric. Itala ang parehong path upang hindi mapagkamalang buong resource budget ang model budget.
| Bahagi | Pangunahing trabaho | Dapat mong ibigay |
|---|---|---|
| Agent ng research | Hypothesis, pagpapatupad, rebisyon | Task contract at pinahihintulutang tool |
| Qlib | Data, training, signal, at portfolio evaluation | Compatible dataset at experiment configuration |
| FinRL | Policy training sa market environment | Environment, reward definition, at evaluation design |
| Reviewer na tao | Methodology at interpretation | Malayang acceptance criteria |
Ayusin ang data contract bago gumawa ng factor
Idokumento ang instrument identity, timezone, adjustment policy, calendar, at paghawak sa missing value. Para sa US equity research, gumamit ng angkop na US dataset at region configuration; hindi naililipat ang assumption ng ibang-market example sa pamamagitan ng pagpapalit lamang ng label. Panatilihin ang historical universe membership at publication timestamp para sa fundamental o textual feature. I-normalize at i-fit ang transformation sa pinahihintulutang development data lamang. Maaaring mag-leak ng future information ang feature na kinalkula mula sa later restatement kahit mukhang kabilang sa nakaraan ang accounting period nito.
Gamitin ang opisyal na workflow structure bilang execution boundary
Isinasagawa ng documented qrun interface ng Qlib ang naka-configure na data, model, at evaluation workflow at nagtatala ng artifact. Magbigay ng nasuring configuration sa halip na hilingin sa agent na mag-improvise ng buong environment habang runtime. Ang command sa ibaba ang opisyal na invocation pattern; ang filename ay kumakatawan sa sarili mong kumpletong configuration. I-validate ang dataset path, region, instrument universe, benchmark, at train/validation/test segment bago execution. Dapat malinaw na bumagsak ang maliit na data-loading check kapag hindi available ang kailangang history o field.
# Requires an installed Qlib environment and a reviewed configuration.
qrun configuration.yaml
Suriin ang kumpletong experiment artifact
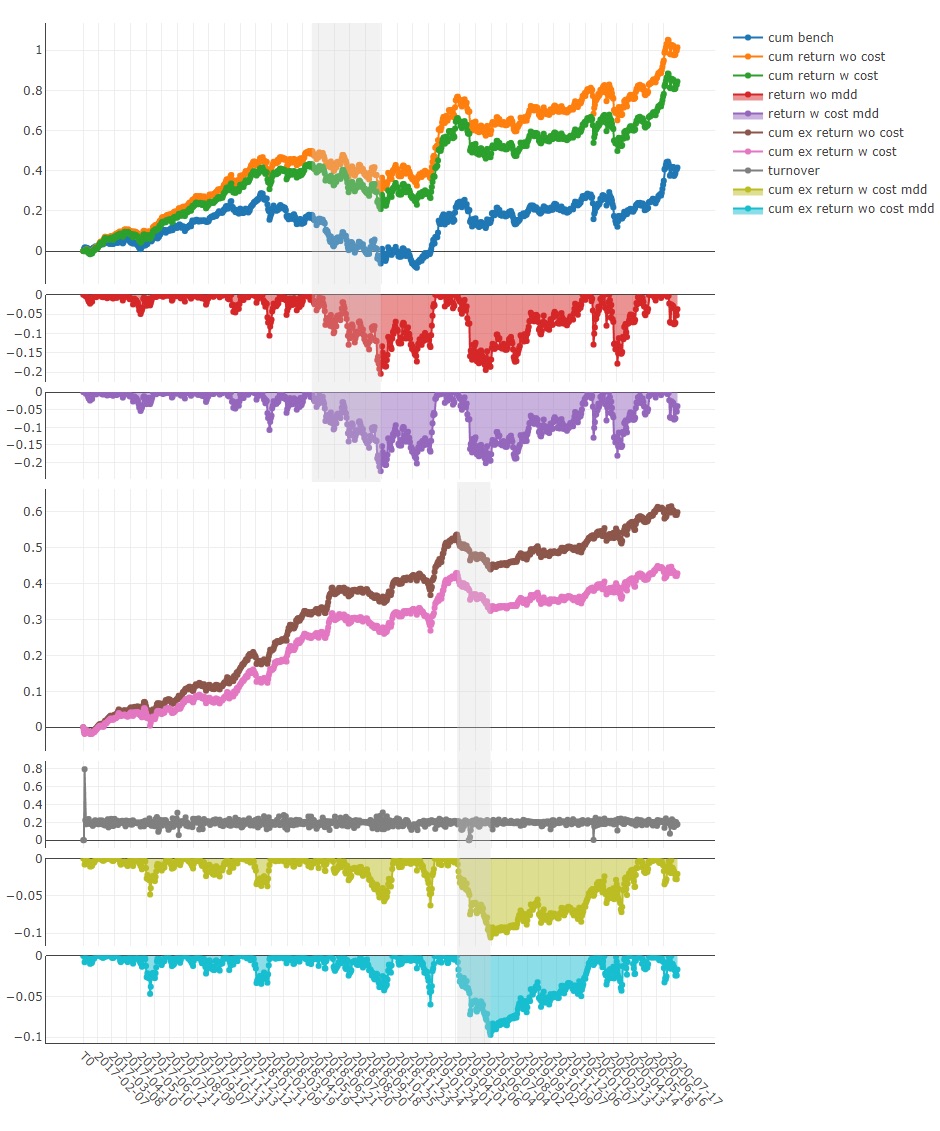
Panatilihing magkakasama ang candidate code, configuration, environment identity, seed kung naaangkop, data manifest, at recorded output. Suriin ang risk, turnover, at benchmark context pati ang headline result. Ipinapakita ng opisyal na Qlib figure ang mga uri ng analysis na maaaring ilantad ng quantitative workflow. Service example ito, hindi resulta mula sa guide na ito. Kapaki-pakinabang lamang ang chart kapag nasusuri ang pinagbabatayang trade o signal, input assumption, at evaluation period, pati ang mga hindi kanais-nais na interval.
Kontrolin ang search process at execution environment
Bigyan ang generated code ng disposable, resource-bounded environment na tanging kailangang dataset at tool lamang ang mayroon. Suriin ang network access, file mount, at secret exposure bago execution. Limitahan ang bilang ng candidate revision at panatilihin ang mga tinanggihang experiment. Kung paulit-ulit na ginagamit ng agent ang held-out score para pagandahin ang code, naging development feedback na ang score na iyon. Maglaan ng tunay na hindi pa nagagalaw na evaluation window o ibang predeclared evaluation design. Ihambing ang candidate sa angkop na baseline at itala ang bawat desisyon sa pagpili, hindi lamang ang final implementation.
I-budget nang magkahiwalay ang model work at computation
I-track sa request ledger ang hypothesis generation, code revision, embedding, at model retry. I-track sa hiwalay na resource ledger ang training, simulation, storage, at data access, na pinagdurugtong ng experiment ID. Maaaring bawasan ng lokal na cache ang paulit-ulit na work ngunit dapat naka-key ito sa code at data identity; kung hindi, maaaring magbalik ito ng resulta mula sa ibang candidate. Huminto kapag naabot ang iteration o compute budget. Ibuod ang finding na may pinakamalakas na suporta at natitirang kawalan ng katiyakan sa halip na hayaang maghanap nang walang katapusan ang agent ng kanais-nais na resulta.
Ebidensya at sakop
Nakabatay ang walkthrough na ito sa mga opisyal na RD-Agent, Qlib, at FinRL source na naka-link sa ibaba. Source-backed ang configuration pattern at service figure; walang RD-Agent loop, Qlib training run, FinRL policy, o financial return na isinagawa o sinukat para sa page na ito. Gamitin ang naka-link na RD-Agent guide para sa model configuration na tiyak sa bersyon, at panatilihin ang hiwalay na execution record kapag nagpapatakbo ng sarili mong experiment.
Mga madalas itanong
Kailangan ba ng Qlib ng LLM API key?
Hindi ang core quantitative workflow nito. Maaaring mangailangan ang nakakabit na research agent ng chat o embedding credential, habang isinasagawa ng Qlib ang naka-configure na numerical work.
Kailan mas angkop ang FinRL kaysa factor workflow?
Kapag tungkol ang research question sa sequential policy learning sa tinukoy na environment. Nagiging sentral na bahagi ng experiment ang environment at reward design.
Maaari bang piliin ng agent ang test period?
Dapat aprubahan ng reviewer ang evaluation boundary bago development. Pinapahina ng pagpili ng agent sa paborableng period matapos makita ang resulta ang experiment.
Ano ang nagpapareproducible sa generated factor?
Napanatiling code, data version, calendar at adjustment rule, dependency version, preprocessing state, at kumpletong evaluation configuration.
Ano ang dapat kong gawin kapag nabigo ang generated code?
Panatilihin ang code at structured failure evidence, ayusin ang pinakamaliit na apektadong stage sa bagong experiment version, at panatilihin ang orihinal na attempt sa search history.