پیکربندی RD-Agent و Qlib
Updated 2026-09-06
لایه مدل عامل پژوهش را پیکربندی و embedding آن را جدا اعتبارسنجی کنید و پیش از شروع آزمایش تکراری محیط کمی محلی را آماده کنید.
مسئولیتهای RD-Agent و Qlib را جدا کنید
از RD-Agent برای توسعه و بازنگری پیادهسازیهای پژوهشی و از Qlib برای اجرای گردشکار کمی پیکربندیشده استفاده کنید. فراخوانی مدل عامل میتواند فرضیه پیشنهاد دهد، کد بنویسد و بازخورد را تفسیر کند. Qlib داده، آموزش و ارزیابی خودش را در محیط آزمایش انجام میدهد. پس کلید API مدل فقط یک وابستگی را حل میکند. پیش از setup سناریوی دقیق RD-Agent را انتخاب، revision پروژه را pin و dataset و مرزهای ارزیابی را تعریف کنید. این کار آمادهسازی محیط را از تصمیمهای پژوهشی عامل جدا نگه میدارد.
chat و embedding را از backend مستند پیکربندی کنید
در revision بازبینیشده 32b3d395، فایل .env.example در RD-Agent backend مربوط به LiteLLM، مدل chat و base سازگار با OpenAI و همچنین مسیر embedding با پیشوند proxy را مستند میکند. قالب shell زیر slotهای مدل متعلق به برنامه را به همان فیلدها نگاشت میکند. پس از بررسی قابلیتهای مدل chat جاری را انتخاب کنید. EMBEDDING_BASE_URL و EMBEDDING_MODEL_ID باید به سرویس embedding مستقلاً در دسترس اشاره کنند؛ فرض نکنید gateway chat آن را فراهم میکند. هر دو credential را از محیط بدهید و فرمان startup مستند سناریو را برای نسخه pinشده اجرا کنید.
export BACKEND=rdagent.oai.backend.LiteLLMAPIBackend
export OPENAI_API_BASE=https://api.apisrouter.com/v1
export CHAT_MODEL="openai/$RESEARCH_MODEL_ID"
# Set OPENAI_API_KEY securely for the chat endpoint.

export LITELLM_PROXY_API_BASE="$EMBEDDING_BASE_URL"
export EMBEDDING_MODEL="litellm_proxy/$EMBEDDING_MODEL_ID"
# Set LITELLM_PROXY_API_KEY securely for the embedding service.
دو قابلیت مدل را مستقل اعتبارسنجی کنید
بررسی کنید client chat انتخابشده قالب پاسخ و رفتار ابزار لازم سناریو را اجرا میکند. embedding را از نظر بردار غیرخالی، بعد ثابت و هویت پایدار مدل بررسی کنید. تغییر مدل embedding ممکن است به ساخت دوباره بردارهای ذخیرهشده نیاز داشته باشد؛ پاسخ موفق chat بازیابی را اعتبارسنجی نمیکند. نمودار متکی بر منبع فقط مسیر chat پیشنهادی را نشان میدهد. پیشوندهای ارائهدهنده LiteLLM رفتار کلاینت را انتخاب میکنند و لزوماً model ID دیدهشده endpoint نیستند؛ هم مقدار پیکربندیشده و هم هویت درخواست resolveشده را نگه دارید.
پیش از حلقه عامل محیط کمی را آماده کنید
dataset، محیط Python و container اجرای مجاز را با کنترل کوچک و قطعی تأیید کنید. برای پژوهش بینالمللی، region dataset، تقویم بازار و جهان ابزار را با بازار موردنظر هماهنگ کنید. مستندات گردشکار Qlib از region آمریکا پشتیبانی میکند، اما dataset نمونه و فرضهای آن را نباید بدون تغییر به بازار دیگری کپی کرد. پوشش تاریخی، سیاست تعدیل و هویت benchmark را تأیید کنید. فقط پس از آن agent را برای تولید کد نامزد در آن محیط فعال کنید؛ وگرنه بازنگریهای تکراری مدل فقط setup داده خراب را جبران میکنند.
فرضیه، کد و بازخورد را کنار هم بررسی کنید
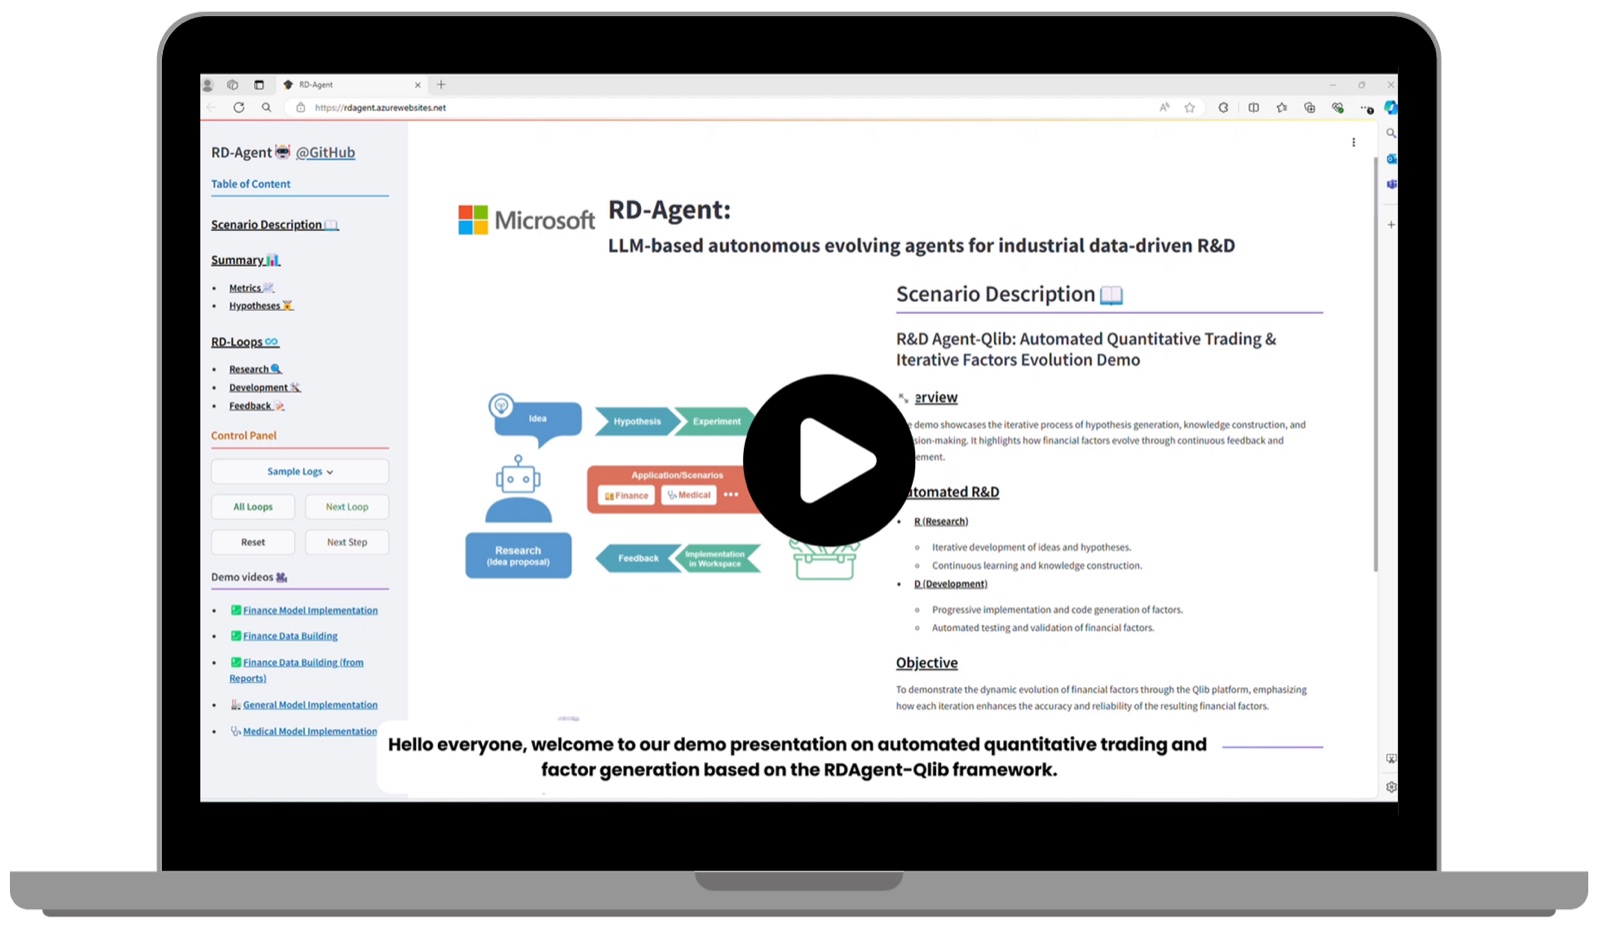
تصویر رسمی RD-Agent یک رابط پژوهش تکراری را نشان میدهد. از آن ساختار بهعنوان یادآوری استفاده کنید که هر فرضیه را همراه پیادهسازی و بازخوردش حفظ کنید، نه فقط گزارش نهایی. بازبین باید بفهمد agent خطای نرمافزار را اصلاح کرده، پرسش پژوهش را تغییر داده یا پس از دیدن امتیاز نامزد دیگری انتخاب کرده است. آزمایشهای ردشده را در دسترس نگه دارید و خروجی ابزار را از تفسیر agent جدا کنید.
اجرای کد را محدود و استقلال ارزیابی را حفظ کنید
کد تولیدشده را با محدودیتهای صریح فایلسیستم، شبکه و منابع اجرا کنید. فقط datasetهای لازم را mount و از افشای credentialهای نامرتبط جلوگیری کنید. پنجرههای train، validation و ارزیابی خارج از نمونه را پیش از توسعه تکراری منجمد کنید. اگر بازخورد آزمون مرتب به agent برگردد، ثبت کنید دوره آزمون بخشی از فرایند توسعه شده است. manifest آزمایش باید revision منبع، hash کد، نسخه داده، پیکربندی، هویت محیط و تصمیم انتخاب را داشته باشد. این کار هم اجرای موفق و هم شکست روششناختی را برای بازبین بعدی قابلمشاهده میکند.
هزینهها را پیگیری و مرحله شکستخورده را بازیابی کنید
دفتر درخواست chat و embedding را با دفتر محاسبه محلی از طریق experiment ID به هم وصل کنید. برآورد هزینه LiteLLM لزوماً هزینه واقعی gateway نیست؛ با رکورد صورتحساب مربوط تطبیق دهید. شکست انتقال مدل، ناهماهنگی vector-index، استثنای کد و داده مفقود Qlib را در وضعیتهای جدا بگذارید. فراخوانی موقت را در بودجه دوباره انجام و خطاهای کد را برای بازرسی نگه دارید. وقتی فقط یک artifact منبع یا درخواست مدل نیازمند اصلاح است کل حلقه را از نو شروع نکنید و با تغییر مدل، کد یا dataset cache را بیاعتبار کنید.
شواهد و محدودیتها
فیلدهای محیط و رفتار backend در revision رسمی 32b3d395 در September 5, 2026 بررسی شدند. فراخوانی Qlib و مسئولیتهای آن از مستندات رسمیاش پیروی میکنند. برای این راهنما هیچ درخواست client پروژه، نتیجه embedding یا حلقه کامل RD-Agent/Qlib از مسیر APIsRouter اجرا نشده است. مرحله پذیرش بعدی یک سناریوی محدود با ورودی، شواهد درخواست و خروجی عددی حفظشده است.
پرسشهای پرتکرار
آیا Qlib از OPENAI_API_BASE استفاده میکند؟
این متغیر مسیر مدل عامل توضیحدادهشده در اینجا را پیکربندی میکند. خود Qlib داده، مدل و ارزیابی را در runtime خودش انجام میدهد.
آیا میتوانم ارائهدهنده embedding جدا داشته باشم؟
قالب بازبینیشده LITELLM_PROXY_API_BASE و key جداگانه را با مدل دارای پیشوند litellm_proxy مستند میکند. سرویس انتخابی و سازگاری بردار را مستقل تأیید کنید.
چرا مدل chat پیشوند openai/ دارد؟
پیشوند ارائهدهنده سازگار را در LiteLLM انتخاب میکند. هنگام اعتبارسنجی endpoint، model ID درخواست resolveشده را بررسی کنید و فرض نکنید هر پیشوند بدون تغییر forward میشود.
آیا hello chat حلقه پژوهش را اعتبارسنجی میکند؟
خیر. فقط یک عملیات کلاینت را آزمایش میکند. embedding، بازیابی، اجرای کد، داده Qlib و ارزیابی نهایی هرکدام نتیجه قابلمشاهده خود را لازم دارند.
وقتی agent کد را تغییر میدهد چه چیزی را حفظ کنم؟
کد قبلی و جدید، فرضیه، بازخورد و هویت آزمایش را نگه دارید تا بازبین بتواند جستوجو و نشت ارزیابی را بازسازی کند.