RD-Agent- und Qlib-Konfiguration
Updated 2026-09-06
Konfigurieren Sie die Modellschicht des Research-Agenten, validieren Sie Embeddings separat und bereiten Sie die lokale quantitative Umgebung vor, bevor Sie ein iteratives Experiment starten.
Weisen Sie RD-Agent und Qlib unterschiedliche Verantwortlichkeiten zu
Verwenden Sie RD-Agent zum Entwickeln und Überarbeiten von Research-Implementierungen und Qlib zum Ausführen eines konfigurierten quantitativen Workflows. Modellaufrufe des Agenten können Hypothesen vorschlagen, Code schreiben und Feedback interpretieren. Qlib verarbeitet Daten, Training und Evaluierung in der Experimentumgebung. Ein Modell-API-Schlüssel löst daher nur eine Abhängigkeit. Wählen Sie vor der Einrichtung das konkrete RD-Agent-Szenario, fixieren Sie die Projektrevision und definieren Sie Dataset- und Evaluierungsgrenzen. So bleibt die Umgebungsvorbereitung getrennt von den Research-Entscheidungen, die der Agent treffen wird.
Konfigurieren Sie Chat und Embedding über das dokumentierte Backend
In der geprüften Revision 32b3d395 dokumentiert RD-Agents .env.example das LiteLLM-Backend, Chatmodell und eine OpenAI-kompatible Basis sowie einen separaten, mit Proxy-Präfix versehenen Embedding-Pfad. Die folgende Shell-Vorlage ordnet anwendungseigene Modellplätze diesen dokumentierten Feldern zu. Wählen Sie ein aktuelles Chatmodell, nachdem Sie seine Fähigkeiten geprüft haben. EMBEDDING_BASE_URL und EMBEDDING_MODEL_ID müssen auf einen unabhängig verfügbaren Embedding-Dienst verweisen; nehmen Sie nicht an, dass das Chat-Gateway einen solchen bereitstellt. Stellen Sie beide Zugangsdaten über die Umgebung bereit und verwenden Sie den dokumentierten Startbefehl des Szenarios für Ihre fixierte Version.
export BACKEND=rdagent.oai.backend.LiteLLMAPIBackend
export OPENAI_API_BASE=https://api.apisrouter.com/v1
export CHAT_MODEL="openai/$RESEARCH_MODEL_ID"
# Set OPENAI_API_KEY securely for the chat endpoint.

export LITELLM_PROXY_API_BASE="$EMBEDDING_BASE_URL"
export EMBEDDING_MODEL="litellm_proxy/$EMBEDDING_MODEL_ID"
# Set LITELLM_PROXY_API_KEY securely for the embedding service.
Validieren Sie die beiden Modellfähigkeiten unabhängig
Prüfen Sie, ob der ausgewählte Chatclient das vom Szenario benötigte Antwortformat und Toolverhalten ausführen kann. Prüfen Sie Embeddings auf einen nicht leeren Vektor, konsistente Dimension und stabile Modellidentität. Ein Wechsel des Embedding-Modells kann den Neuaufbau gespeicherter Vektoren erfordern; eine erfolgreiche Chatantwort validiert Retrieval nicht. Das quellenbasierte Diagramm zeigt nur die vorgeschlagene Chatroute. LiteLLM-Providerpräfixe wählen Clientverhalten und sind nicht zwangsläufig die vom Endpunkt gesehene Modell-ID. Bewahren Sie daher konfigurierten Wert und aufgelöste Anfrageidentität auf.
Bereiten Sie die quantitative Umgebung vor einer Agentenschleife vor
Verifizieren Sie Dataset, Python-Umgebung und zulässigen Ausführungscontainer mit einer kleinen deterministischen Prüfung. Richten Sie bei internationalem Research Dataset-Region, Marktkalender und Instrumentuniversum auf den vorgesehenen Markt aus. Die Qlib-Workflow-Dokumentation unterstützt eine US-Region, aber Beispieldataset und Annahmen sollten nicht unverändert in einen anderen Markt kopiert werden. Bestätigen Sie historische Abdeckung, Anpassungsregeln und Benchmarkidentität. Aktivieren Sie erst danach einen Agenten, der Kandidatencode für diese Umgebung erzeugt; sonst kompensieren wiederholte Modellrevisionen möglicherweise nur eine defekte Dateneinrichtung.
Prüfen Sie Hypothese, Code und Feedback gemeinsam
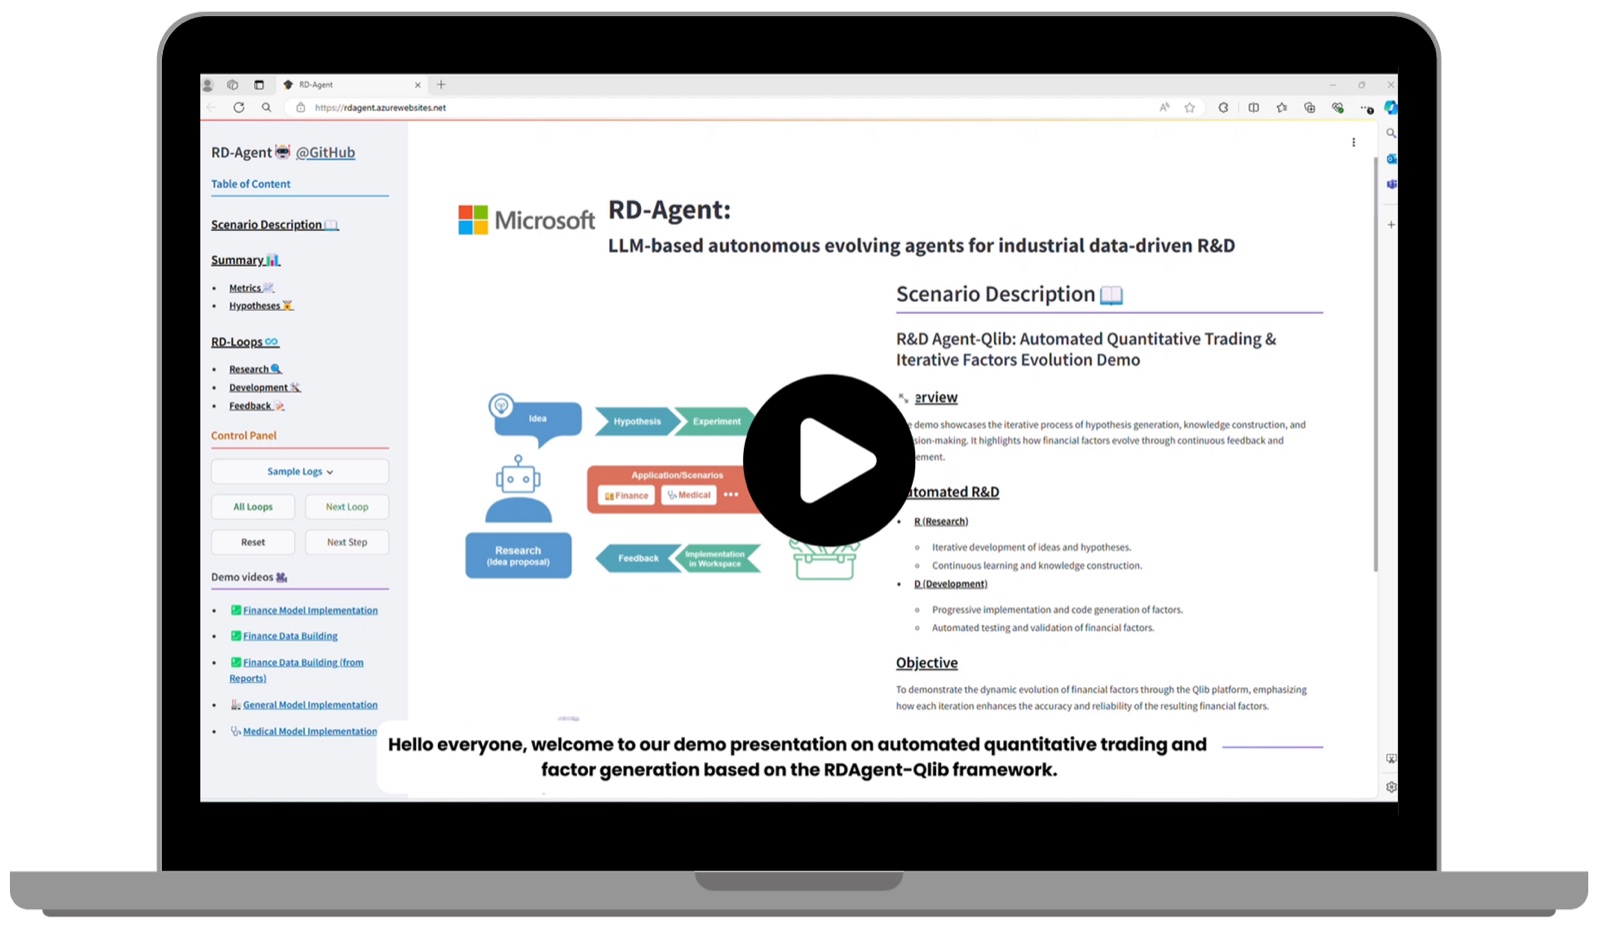
Die offizielle RD-Agent-Illustration zeigt eine iterative Research-Oberfläche. Verwenden Sie diese Struktur als Erinnerung, jede Hypothese mit Implementierung und Feedback zu bewahren und nicht nur den finalen Bericht. Ein Prüfer sollte erkennen können, ob der Agent einen Softwarefehler behoben, die Research-Frage geändert oder nach Sichtung eines Scores einen anderen Kandidaten ausgewählt hat. Halten Sie abgelehnte Experimente zugänglich und trennen Sie Toolausgabe von der Interpretation dieser Ausgabe durch den Agenten.
Begrenzen Sie Codeausführung und bewahren Sie Evaluierungsunabhängigkeit
Führen Sie generierten Code mit ausdrücklichen Grenzen für Dateisystem, Netzwerk und Ressourcen aus. Binden Sie nur benötigte Datasets ein und legen Sie keine unabhängigen Zugangsdaten offen. Frieren Sie Trainings-, Validierungs- und zurückgehaltene Evaluierungsfenster vor der iterativen Entwicklung ein. Wenn Testfeedback wiederholt an den Agenten zurückgegeben wird, erfassen Sie, dass der Testzeitraum Teil des Entwicklungsprozesses geworden ist. Ein Experimentmanifest sollte Quellrevision, Code-Hash, Datenversion, Konfiguration, Umgebungsidentität und Auswahlentscheidung enthalten. So werden sowohl erfolgreiche Ausführung als auch methodisches Scheitern für den nächsten Prüfer sichtbar.
Verfolgen Sie Kosten und stellen Sie die fehlgeschlagene Stufe wieder her
Verbinden Sie Anfrageprotokoll für Chat und Embeddings über Experiment-IDs mit dem Protokoll lokaler Berechnung. LiteLLM-Kostenschätzungen sind nicht zwingend die tatsächlichen Gateway-Gebühren; gleichen Sie mit dem geltenden Abrechnungsdatensatz ab. Trennen Sie Fehler beim Modelltransport, Vektorindexabweichung, Codeausnahme und fehlende Qlib-Daten in unterschiedliche Zustände. Wiederholen Sie vorübergehende Aufrufe innerhalb eines Budgets und bewahren Sie Codefehler zur Prüfung auf. Starten Sie nicht die gesamte Schleife neu, wenn nur ein Quellenartefakt oder eine Modellanfrage korrigiert werden muss, und machen Sie Caches ungültig, wenn sich relevantes Modell, Code oder Dataset ändern.
Belege und Grenzen
Umgebungsfelder und Backendverhalten wurden am 5. September 2026 in der offiziellen Quellrevision 32b3d395 geprüft. Aufruf und Verantwortlichkeiten von Qlib folgen der offiziellen Dokumentation. Für diesen Leitfaden wurden weder eine Projekt-Clientanfrage noch ein Embedding-Ergebnis oder ein vollständiger RD-Agent/Qlib-Lauf über APIsRouter ausgeführt. Der nächste Abnahmeschritt ist ein begrenztes Szenario mit bewahrten Eingaben, Anfragebelegen und numerischen Ausgaben.
Häufige Fragen
Verwendet Qlib OPENAI_API_BASE?
Diese Variable konfiguriert den hier beschriebenen Agenten-Modellpfad. Qlib selbst führt Daten-, Modell- und Evaluierungsarbeit in seiner eigenen Laufzeit aus.
Kann ich einen separaten Embedding-Anbieter verwenden?
Die geprüfte Vorlage dokumentiert ein separates LITELLM_PROXY_API_BASE und einen Schlüssel mit einem litellm_proxy-präfigierten Modell. Verifizieren Sie ausgewählten Dienst und Vektorkompatibilität unabhängig.
Warum hat das Chatmodell ein openai/-Präfix?
Es wählt den kompatiblen Provider in LiteLLM. Prüfen Sie bei der Endpunktvalidierung die aufgelöste Anfrage-Modell-ID, statt anzunehmen, jedes Präfix werde unverändert weitergegeben.
Validiert ein Chat-Hello den Research-Workflow?
Nein. Es testet eine Clientoperation. Embeddings, Retrieval, Codeausführung, Qlib-Daten und die abschließende Evaluierung benötigen jeweils ein eigenes beobachtbares Ergebnis.
Was sollte bewahrt werden, wenn der Agent Code ändert?
Bewahren Sie vorherigen und neuen Code, Hypothese, Feedback und Experimentidentität auf, damit Prüfer die Suche rekonstruieren und Evaluierungs-Leakage erkennen können.