KI-Workflows für quantitative Forschung
Updated 2026-09-06
Lassen Sie Agenten Hypothesen vorschlagen und implementieren, und verwenden Sie anschließend versionierte Daten und reproduzierbare Experimente zur Bewertung. Halten Sie Modellunterhaltung und numerische Berechnung getrennt.
Machen Sie aus einer Idee ein falsifizierbares Experiment
Schreiben Sie den Mechanismus auf, den Sie testen möchten, die beobachtbaren Variablen, das vorgesehene Universum und die Bedingungen, unter denen die Idee verworfen würde. Ein Agent kann helfen, diese Spezifikation in Code zu übersetzen, sollte aber das Erfolgskriterium nach Sichtung der Ergebnisse nicht neu definieren. Trennen Sie Implementierungsfragen von Research-Fragen: Ein Faktor kann korrekt berechnet sein und trotzdem kein nützliches Signal enthalten. Speichern Sie vor der ersten Codegenerierungsanfrage eine kleine Spezifikation, damit das spätere Experiment mit der ursprünglichen Absicht verglichen werden kann.
Wählen Sie die richtige Rolle für RD-Agent, Qlib und FinRL
RD-Agent automatisiert Teile der Research-Entwicklung, einschließlich iterativer Implementierung und Feedback. Qlib liefert einen quantitativen Workflow für Daten, Modelle und Evaluierung. FinRL stellt Research-Umgebungen für Reinforcement Learning bereit. Diese Projekte können unterschiedliche Stufen unterstützen, sind aber keine austauschbaren Chat-Clients. LLM-Anfragen gehören in die Denk- und Programmierschicht des Agenten. Feature-Konstruktion, Training, Simulation und Kennzahlen verbrauchen Rechenleistung in der Experimentumgebung. Erfassen Sie beide Pfade, damit ein Modellbudget nicht mit dem vollständigen Ressourcenbudget verwechselt wird.
| Komponente | Primäre Arbeit | Was Sie bereitstellen müssen |
|---|---|---|
| Research-Agent | Hypothese, Implementierung, Revision | Aufgabenvertrag und zulässige Tools |
| Qlib | Daten-, Trainings-, Signal- und Portfolioevaluierung | Kompatibler Datensatz und Experimentkonfiguration |
| FinRL | Policy-Training in einer Marktumgebung | Umgebung, Reward-Definition und Evaluierungsdesign |
| Menschlicher Prüfer | Methodik und Interpretation | Unabhängige Abnahmekriterien |
Fixieren Sie den Datenvertrag, bevor Sie Faktoren generieren
Dokumentieren Sie Instrumentidentität, Zeitzonen, Anpassungsregeln, Kalender und Umgang mit fehlenden Werten. Verwenden Sie für US-Aktien-Research einen geeigneten US-Datensatz und eine Regionskonfiguration; das Ändern eines Labels in einem Beispiel eines anderen Marktes überträgt dessen Annahmen nicht. Bewahren Sie historische Zugehörigkeit zum Universum und Veröffentlichungszeitpunkte für fundamentale oder textuelle Merkmale. Normalisieren und fitten Sie Transformationen nur auf den zulässigen Entwicklungsdaten. Ein aus einer späteren Neudarstellung berechneter Faktor kann Zukunftsinformationen leaken, auch wenn sein Bilanzierungszeitraum zur Vergangenheit zu gehören scheint.
Verwenden Sie die offizielle Workflow-Struktur als Ausführungsgrenze
Qlibs dokumentierte qrun-Schnittstelle führt einen konfigurierten Daten-, Modell- und Evaluierungsworkflow aus und speichert Artefakte. Geben Sie eine geprüfte Konfiguration vor, statt einen Agenten zu bitten, die gesamte Umgebung zur Laufzeit zu improvisieren. Der folgende Befehl ist das offizielle Aufrufmuster; der Dateiname steht für Ihre eigene vollständige Konfiguration. Validieren Sie Dataset-Pfad, Region, Instrumentuniversum, Benchmark und Trainings-/Validierungs-/Testsegmente vor der Ausführung. Eine kleine Prüfung zum Laden der Daten sollte klar fehlschlagen, wenn erforderliche Historie oder Felder nicht verfügbar sind.
# Requires an installed Qlib environment and a reviewed configuration.
qrun configuration.yaml
Prüfen Sie das vollständige Experimentartefakt
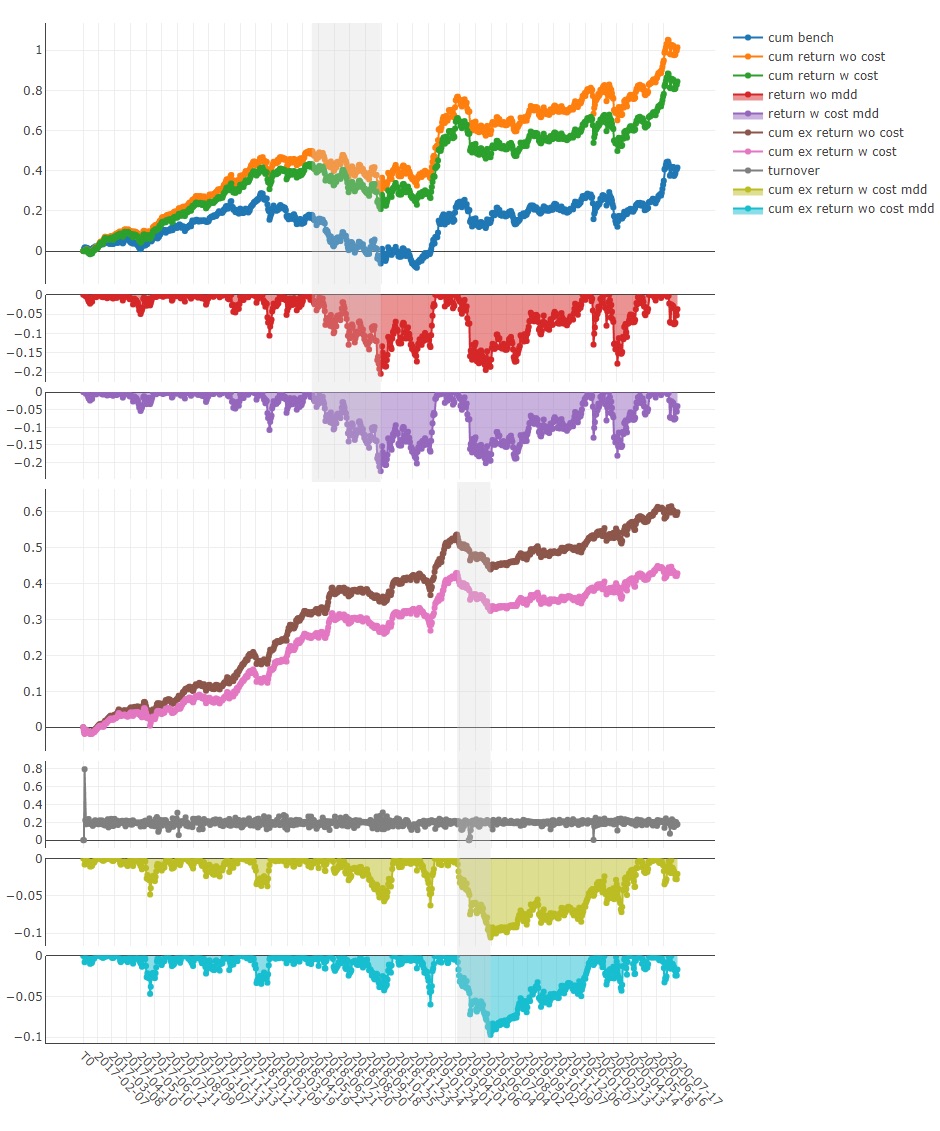
Halten Sie Kandidatencode, Konfiguration, Umgebungsidentität, gegebenenfalls Seed, Datenmanifest und aufgezeichnete Ausgaben zusammen. Prüfen Sie Risiko, Turnover und Benchmark-Kontext ebenso wie ein eventuelles Hauptergebnis. Die offizielle Qlib-Abbildung illustriert die Arten von Analysen, die ein quantitativer Workflow sichtbar machen kann. Sie ist ein Service-Beispiel und kein Ergebnis dieses Leitfadens. Ein Diagramm ist nur nützlich, wenn zugrunde liegende Trades oder Signale, Eingabeannahmen und Evaluierungszeitraum einschließlich ungünstiger Intervalle geprüft werden können.
Steuern Sie Suchprozess und Ausführungsumgebung
Geben Sie generiertem Code eine verworfene, ressourcenbegrenzte Umgebung mit nur den benötigten Datasets und Tools. Prüfen Sie Netzwerkzugriff, Dateieinhängungen und Geheimnisoffenlegung vor der Ausführung. Begrenzen Sie die Zahl der Kandidatenrevisionen und bewahren Sie abgelehnte Experimente auf. Wenn ein Agent wiederholt einen zurückgehaltenen Score zur Codeverbesserung verwendet, ist dieser Score zu Entwicklungsfeedback geworden. Reservieren Sie ein wirklich unberührtes Evaluierungsfenster oder ein anderes vorab festgelegtes Evaluierungsdesign. Vergleichen Sie Kandidaten mit einer geeigneten Baseline und erfassen Sie jede Auswahlentscheidung und nicht nur die endgültige Implementierung.
Budgetieren Sie Modellarbeit und Berechnung getrennt
Verfolgen Sie Hypothesengenerierung, Code-Revisionen, Embeddings und Modellwiederholungen in einem Anfrageprotokoll. Verfolgen Sie Training, Simulation, Speicherung und Datenzugriff in einem separaten Ressourcenprotokoll, das über die Experiment-ID verbunden wird. Ein lokaler Cache kann wiederholte Arbeit reduzieren, muss aber nach Code- und Datenidentität verschlüsselt sein; andernfalls kann er ein Ergebnis eines anderen Kandidaten liefern. Stoppen Sie, wenn Iterations- oder Rechenbudget erreicht ist. Fassen Sie den am besten gestützten Befund und verbleibende Unsicherheit zusammen, statt den Agenten unbegrenzt nach einem günstigen Ergebnis suchen zu lassen.
Belege und Umfang
Dieser Leitfaden stützt sich auf die unten verlinkten offiziellen Quellen von RD-Agent, Qlib und FinRL. Konfigurationsmuster und Service-Abbildung sind quellenbasiert; für diese Seite wurde weder ein RD-Agent-Lauf noch ein Qlib-Training, eine FinRL-Policy oder eine finanzielle Rendite ausgeführt oder gemessen. Verwenden Sie den verlinkten RD-Agent-Leitfaden für versionsspezifische Modellkonfiguration und bewahren Sie bei eigenen Experimenten ein separates Ausführungsprotokoll auf.
Häufige Fragen
Benötigt Qlib einen LLM-API-Schlüssel?
Der quantitative Kernworkflow benötigt ihn nicht. Ein angebundener Research-Agent kann Chat- oder Embedding-Zugangsdaten benötigen, während Qlib die konfigurierte numerische Arbeit ausführt.
Wann passt FinRL besser als ein Faktor-Workflow?
Wenn die Research-Frage sequentielles Policy-Lernen in einer definierten Umgebung betrifft. Umgebung und Reward-Design werden zu zentralen Bestandteilen des Experiments.
Kann der Agent den Testzeitraum auswählen?
Ein Prüfer sollte Evaluierungsgrenzen vor der Entwicklung freigeben. Wenn der Agent nach Sichtung der Ergebnisse günstige Zeiträume auswählt, wird das Experiment schwächer.
Was macht einen generierten Faktor reproduzierbar?
Bewahrter Code, Datenversion, Kalender- und Anpassungsregeln, Abhängigkeitsversionen, Vorverarbeitungszustand und vollständige Evaluierungskonfiguration.
Was sollte ich tun, wenn generierter Code fehlschlägt?
Bewahren Sie Code und strukturierte Fehlerbelege, korrigieren Sie die kleinste betroffene Stufe in einer neuen Experimentversion und halten Sie den ursprünglichen Versuch in der Suchhistorie fest.