समीक्षा-योग्य AI ईकॉमर्स ऑटोमेशन
Updated 2026-09-05
हर content job को source revision, स्पष्ट state, approval और सुरक्षित import के साथ चलाएँ।
Prompt नहीं, persisted job बनाएँ
दोहराए जा सकने वाले content workflow को यह बताना चाहिए कि कौन-सा product बदला, कौन-सा source revision इस्तेमाल हुआ, कौन-सा काम बाकी है और उसे publish करने की अनुमति किसे है। CSV attachment के साथ scheduled prompt अकेले इन प्रश्नों का उत्तर नहीं दे सकता। Prompt को ऐसे job के एक चरण के रूप में देखें जिसकी state conversation के बाहर store होती है।
Export किए जा सकने वाले content और offline review queue से शुरुआत करें। हर job को durable record और स्पष्ट next action दें। जब तक destination adapter और approval checks किसी controlled store में test न हो जाएँ, live product updates disabled रखें। इससे publication permissions जोड़ने से पहले generation और review तैयार किए जा सकते हैं।
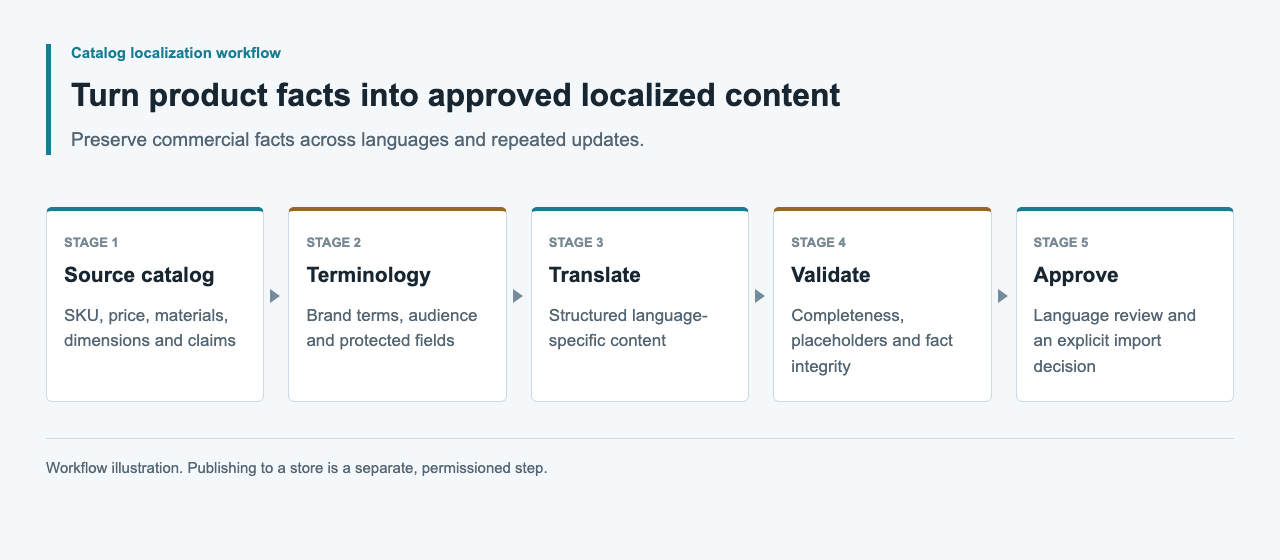
Revision और product identity से intended work पहचानें
Intended work पहचानने के लिए source revision, product identifier, locale, glossary revision और prompt revision का उपयोग करें। उसी job को retry करने पर unrelated candidate नहीं बनना चाहिए और वही import दोबारा लागू नहीं होना चाहिए। Source या rules बदलें तो पुराने candidate से स्पष्ट संबंध वाला नया work बनाएँ।
Jobs को row number से key न करें, क्योंकि export sort होने पर row positions बदल जाती हैं। Prices और units source snapshot में सुरक्षित रखें, लेकिन generated output को केवल approved text fields तक सीमित रखें। नीचे दिया गया record आपके job store के लिए adapt करने योग्य illustrative application contract है।
{
  "productId": "SYNTHETIC-CATALOG-A",
  "locale": "de",
  "sourceRevision": "source-revision-required",
  "glossaryRevision": "glossary-revision-required",
  "promptRevision": "prompt-revision-required",
  "state": "queued",
  "approval": null,
  "importReceipt": null
}
Approval को exact candidate और source से बाँधें
Candidate output को validation से पहले store करें और reviewer assign करने से पहले validation issues भी store करें। Approval को exact candidate और source revisions से bind करें। Approval के बाद content बदल गया हो तो publisher को record refuse करना चाहिए, चाहे उसका पुराना version पहले स्वीकार किया गया हो।
Ambiguous outcomes के लिए hold state रखें। उदाहरण के लिए import के बीच connection loss से यह सिद्ध नहीं होता कि store ने write reject कर दी। Retry करने से पहले वर्तमान stored fields का reconciliation करें। नीचे दिए states को orchestration layer में लागू करें और हर persisted result के operation के पास transition checks रखें।
| स्थिति | अर्थ | अगला चरण |
|---|---|---|
| draft स्थिति | Candidate तैयार है | Validation चलाएँ |
| review आवश्यक | Issues या uncertainty मौजूद है | Reviewer का decision |
| स्वीकृत candidate | Exact revision स्वीकार है | Import proposal बनाएँ |
| hold की गई स्थिति | Conflict या uncertain write | Reconcile करके review करें |
| import किया गया record | Store read-back दर्ज है | Mismatch को classify करें |
Drafting को publishing permission से अलग रखें
Drafting worker को केवल approved source subset और model credentials दें। Store credentials को narrow destination adapter में रखें, जैसे केवल description patch तैयार करने वाला operation। AI request सफल हो जाने पर भी उसे product publish करने की अनुमति नहीं मिलनी चाहिए।
Shopify का documented translation path resource-specific content और digests इस्तेमाल करता है; WooCommerce product CSV importer document करता है। हर interface के लिए अपना mapper और verification step रखें। Model credentials drafting client में configure करें, जबकि source reads और authorized store writes destination adapter में रहें। इन boundaries को अलग-अलग test करने के बाद ही flow को जोड़ें।
Retries और failures को अलग categories दें
Temporary transport failures को finite policy और recorded attempts के साथ retry करें। Cause बदले बिना structurally invalid response दोहराने से usage और reviewer का समय दोनों व्यर्थ हो सकते हैं। Authentication, unavailable model, incomplete generation, invalid fields और rejected content अलग failure categories हैं और इनके interventions भी अलग होने चाहिए।
Successful records को उपलब्ध रहने दें और failed records को hold करें। प्रभावित product के सभी attempts रखें, जिन candidates ने validation fail किया उन्हें भी। Worker restart persisted state से resume करे, पूरे catalog को फिर से generate न करे। Cancellation भी test करें: generation रोकने पर import process चुपचाप चलता नहीं रहना चाहिए।
Usage ledger को job और accepted work से जोड़ें
Usage records को job और attempt से associate करें और जहाँ billing evidence हो वहाँ failed requests भी दर्ज करें। Drafting, review और revision calls को अलग track करें। Missing usage को unknown रखें; missing receipt free request नहीं होती। Editor time को API ledger के साथ blend न करें।
अपने release criteria के अनुसार accepted work define करें, जैसे approved product-locale revision। Denominator nonzero हो और sample का scope स्पष्ट हो तभी recorded costs को accepted work से divide करें। Current provider या gateway billing information इस्तेमाल करें और report में date तथा billing source भी रखें।
Authorized import से पहले और बाद में reconcile करें
Import proposal में केवल approved changes रखें और उन्हीं fields की previous values save करें। Authorized write से ठीक पहले source revision फिर compare करें। किसी दूसरे editor ने product बदल दिया हो तो pause करें और नया review माँगें, उनके work को overwrite न करें।
Import के बाद intended fields read back करें और product तथा locale के अनुसार mismatches classify करें। Reversal इस batch के केवल उन्हीं changes को restore करे जब store imported revision से अब भी match करता हो; अन्यथा conflict review चाहिए। Import permission को text generate करने की permission से अलग रखें।
State contract का end-to-end test करें
Synthetic products से एक accepted candidate, एक protected-field violation और एक changed-source conflict test करें। Drafting और approval के बीच worker restart करें। जाँचें कि approved work बचा रहता है और held work import proposal में नहीं पहुँचता। ये checks prompt wording को बार-बार test करने की तुलना में state contract को अधिक सीधे exercise करते हैं।
इसके बाद explicit permission के साथ staging store में adapter test करें। Source snapshot, generated revision, approval, import receipt और read-back comparison बचाएँ। Local job simulation केवल orchestration behavior स्थापित करती है; इससे model quality या सफल store integration सिद्ध नहीं होती।
अक्सर पूछे जाने वाले प्रश्न
क्या workflow schedule पर चल सकता है?
हाँ, जब jobs revision-aware और persisted हों। Scheduling को eligible work enqueue करना चाहिए; validation bypass या automatic publishing permission नहीं देनी चाहिए।
Review के दौरान source बदल जाए तो क्या करना चाहिए?
Candidate को stale mark करें और बदले हुए fields compare करें। नया import तैयार करने से पहले नए source revision पर approval लेना आवश्यक है।
क्या failed rows से पूरा catalog रोक देना चाहिए?
ज़रूरी नहीं। प्रभावित records hold करते हुए successful drafts बचाए जा सकते हैं, लेकिन गलत glossary जैसा shared failure पूरे batch को प्रभावित कर सकता हो तो batch block करें।
Uncertain store writes को कैसे retry करें?
पहले targeted fields read back करें और जो approved patch बाकी है केवल उसे reconcile करके retry करें। Timeout को no write मान लेना गलत है।
कौन-से components पहले implement करने चाहिए?
Source snapshots, persistent jobs और review queue से शुरुआत करें। इसके बाद model client जोड़ें और authorized imports enable करने से पहले destination adapter implement तथा test करें।