AI定量リサーチのワークフロー
Updated 2026-09-06
エージェントで仮説を提案・実装し、バージョン管理されたデータと再現可能な実験で評価します。モデルとの会話と数値計算を分けて管理します。
アイデアを反証可能な実験に変える
テストしたいメカニズム、観測可能な変数、意図したユニバース、アイデアを却下する条件を書き出します。エージェントはその仕様をコードへ変換する助けになりますが、結果を見た後に成功条件を再定義させないでください。実装上の問いとリサーチ上の問いを分けます。ファクターを正しく計算できても、有用なシグナルを含まないことがあります。最初のコード生成リクエストの前に小さな仕様を保存し、最終的な実験を元の意図と比較できるようにします。
RD-Agent、Qlib、FinRLの適切な役割を選ぶ
RD-Agentは、反復的な実装とフィードバックを含むリサーチ開発の一部を自動化します。Qlibはデータ、モデル、評価の定量ワークフローを提供します。FinRLは強化学習のリサーチ環境を提供します。これらのプロジェクトは異なる段階に役立ちますが、相互交換可能なチャットクライアントではありません。LLMリクエストはエージェントの推論とコーディング層に属します。特徴量の構築、訓練、シミュレーション、指標は実験環境の計算を消費します。モデル予算を完全なリソース予算と取り違えないよう、両方の経路を記録します。
| コンポーネント | 主な作業 | 提供すべきもの |
|---|---|---|
| リサーチエージェント | 仮説、実装、改訂 | タスク契約と許可されたツール |
| Qlib | データ、訓練、シグナル、ポートフォリオ評価 | 対応データセットと実験設定 |
| FinRL | 市場環境でのポリシー訓練 | 環境、報酬定義、評価設計 |
| 人間のレビュアー | 方法論と解釈 | 独立した受け入れ基準 |
ファクターを生成する前にデータ契約を直す
銘柄識別情報、タイムゾーン、調整ポリシー、カレンダー、欠落値の扱いを文書化します。米国株式リサーチでは、適切な米国データセットと地域設定を使います。異なる市場の例でラベルを変えても、その前提は移行しません。ファンダメンタルまたはテキストの特徴量について、過去のユニバース構成と公開タイムスタンプを保持します。許可された開発データだけで変換を正規化し適合させます。後の修正再表示から計算した特徴量は、会計期間が過去に属しているように見えても未来情報を漏洩させる可能性があります。
公式ワークフローの構造を実行境界として使う
Qlibの文書化されたqrunインターフェースは、設定されたデータ、モデル、評価ワークフローを実行し、成果物を記録します。実行時にエージェントへ環境全体を即興で作らせず、レビュー済みの設定を渡します。以下のコマンドは公式の呼び出しパターンであり、ファイル名は自分の完全な設定を表します。実行前にデータセットパス、地域、銘柄ユニバース、ベンチマーク、訓練・検証・テスト(train/validation/test)のセグメントを検証します。必要な履歴やフィールドが利用できない場合、小さなデータロードチェックが明確に失敗するようにします。
# Requires an installed Qlib environment and a reviewed configuration.
qrun configuration.yaml
完全な実験成果物を検査する
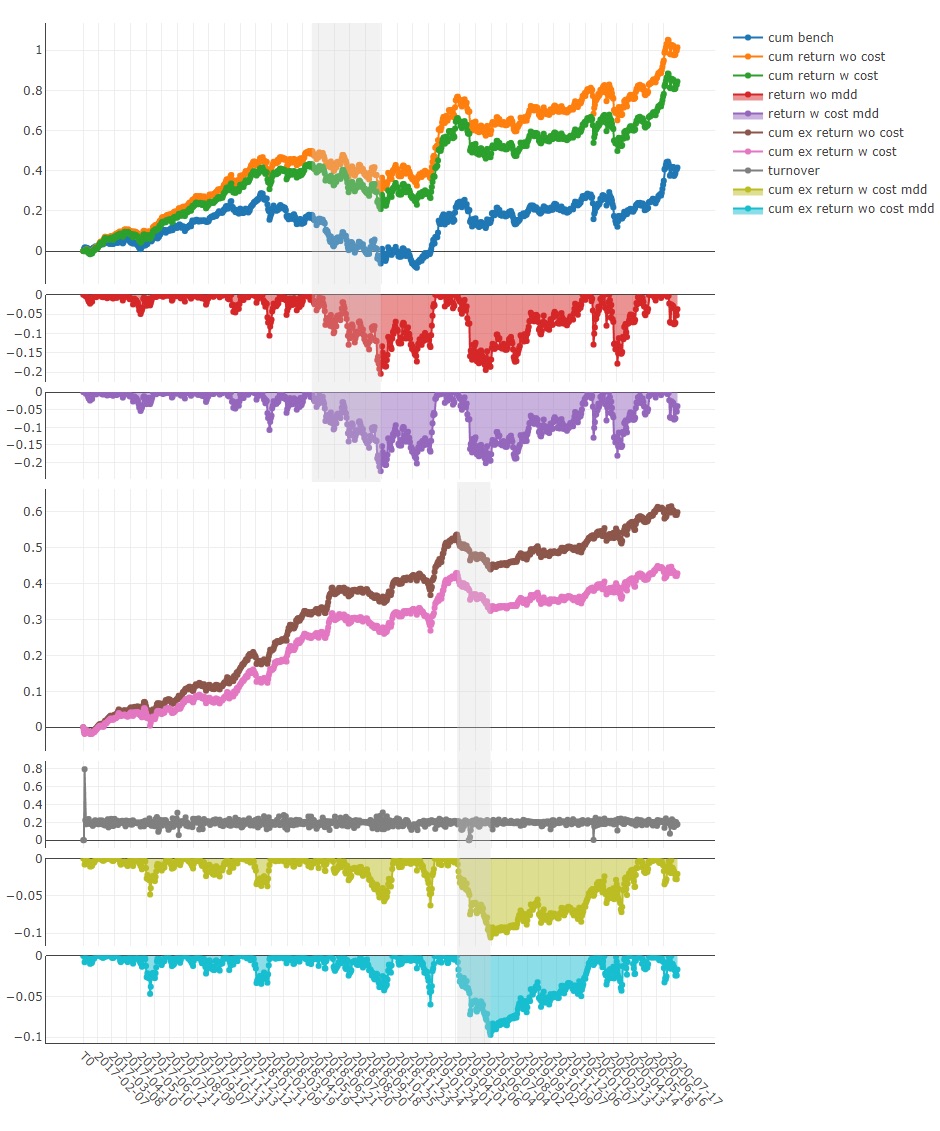
候補コード、設定、環境識別情報、必要に応じたシード、データマニフェスト、記録された出力を一緒に保持します。見出しの結果だけでなく、リスク、回転率、ベンチマークのコンテキストも検査します。公式Qlib図は、定量ワークフローが明らかにできる分析の種類を示します。これは上流の例であり、このガイドの結果ではありません。不利な期間を含め、基礎となる取引またはシグナル、入力前提、評価期間を検査できる場合にだけ、チャートは役に立ちます。
探索プロセスと実行環境を制御する
生成コードには、必要なデータセットとツールだけを持つ使い捨てでリソース上限付きの環境を与えます。実行前にネットワークアクセス、ファイルマウント、秘密情報の露出をレビューします。候補リビジョンの数を制限し、却下した実験を保持します。エージェントがホールドアウトスコアを使ってコードを繰り返し改善するなら、そのスコアは開発フィードバックになっています。完全に未使用の評価期間または別の事前宣言した評価設計を確保します。適切なベースラインと候補を比較し、最終実装だけでなくすべての選択判断を記録します。
モデル作業と計算を別々に予算化する
仮説生成、コード改訂、埋め込み、モデルリトライをリクエスト台帳で追跡します。訓練、シミュレーション、ストレージ、データアクセスは、実験IDで結合した別のリソース台帳で追跡します。ローカルキャッシュは反復作業を減らせますが、コードとデータの識別情報をキーにする必要があります。そうでなければ、別の候補の結果を返す可能性があります。反復または計算予算に達したら停止します。好ましい結果を無制限に探索させず、最も裏付けのある発見と残る不確かさをまとめます。
証拠と範囲
この手順は、以下にリンクしたRD-Agent、Qlib、FinRLの公式ソースに基づきます。設定パターンと上流の図はソースで裏付けられていますが、このページのためにRD-Agentループ、Qlib訓練実行、FinRLポリシー、金融リターンを実行または測定していません。バージョン固有のモデル設定にはリンク先のRD-Agentガイドを使い、自分の実験を実行する際は別の実行記録を保持してください。
よくある質問
QlibにはLLM APIキーが必要ですか?
中核の定量ワークフローには必要ありません。接続したリサーチエージェントにはチャットまたは埋め込みの認証情報が必要な場合がありますが、Qlibは設定済みの数値処理を実行します。
ファクターワークフローよりFinRLが適するのはいつですか?
定義された環境での逐次的なポリシー学習がリサーチの問いである場合です。環境と報酬の設計が実験の中心になります。
テスト期間をエージェントが選んでもよいですか?
開発前にレビュアーが評価境界を承認するべきです。結果を見た後でエージェントに都合のよい期間を選ばせると、実験の強さが弱まります。
生成されたファクターを再現可能にするものは何ですか?
保持されたコード、データバージョン、カレンダーと調整ルール、依存関係のバージョン、前処理状態、完全な評価設定です。
生成コードが失敗したらどうすべきですか?
コードと構造化された失敗証拠を保持し、新しい実験バージョンで影響した最小段階を修正し、元の試行を探索履歴に残します。