Costi API Astra: dall'utilizzo al lavoro accettato
Updated 2026-09-05
Contabilizza separatamente input ordinario, letture dalla cache, scritture nella cache e output. Usa il listino ufficiale corrente e un registro completo delle richieste per stimare un'attività.
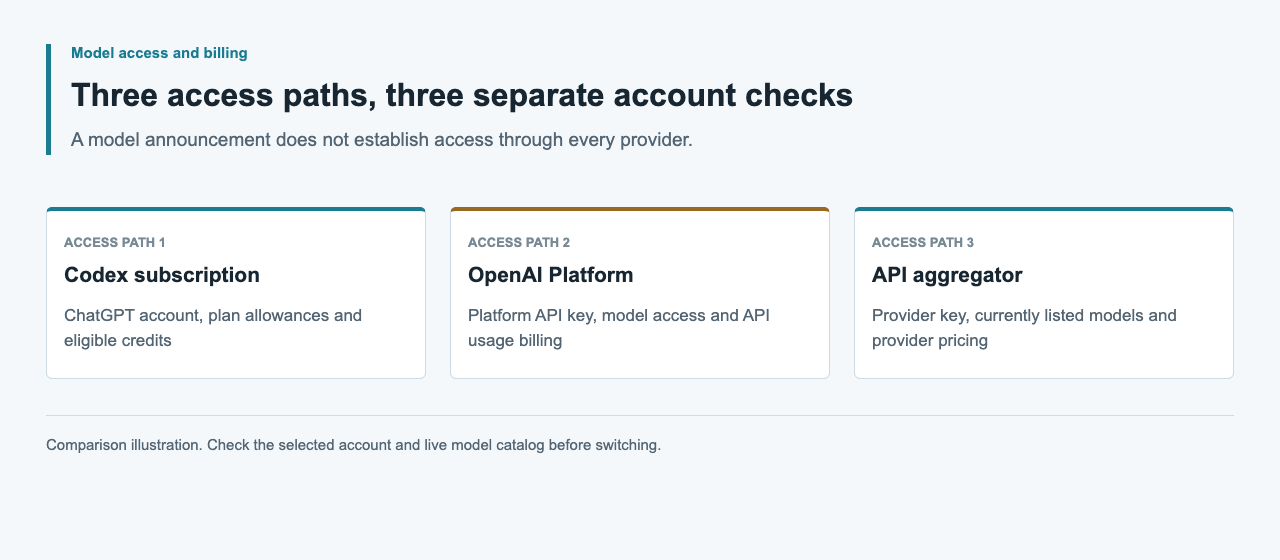
Scegli il sistema di fatturazione prima della tariffa
Le richieste dirette all'API Astra usano la fatturazione OpenAI Platform. Il lavoro Codex autenticato con ChatGPT usa disponibilità e crediti di abbonamento o workspace. OpenAI li pubblica separatamente: una tariffa in crediti Codex non è un prezzo in dollari per token API e un turno incluso nell'abbonamento non è una ricevuta API.
Per le richieste dirette, apri la pagina ufficiale dei prezzi API e seleziona le tariffe gpt-6-astra applicabili al livello di servizio, alla fascia di contesto e alla modalità di elaborazione. Conserva URL del listino e data di osservazione con la stima. Costruisci il calcolo dall'utilizzo a livello di richiesta, poi confronta il totale con i record di utilizzo Platform e con la fattura. Così è più facile individuare differenze di selezione della tariffa o richieste mancanti.
Acquisisci i campi esatti di utilizzo Responses
La guida ufficiale al prompt caching documenta input_tokens, input_tokens_details.cached_tokens e input_tokens_details.cache_write_tokens. Letture dalla cache e scritture nella cache sono categorie separate dell'input: sottraile entrambe prima di calcolare l'input ordinario. Presumere che ogni token non memorizzato abbia la tariffa d'input ordinaria può sottostimare una richiesta che scrive nella cache.
La guida al reasoning documenta output_tokens e output_tokens_details.reasoning_tokens. I token di reasoning sono inclusi nell'utilizzo dell'output; non aggiungerli di nuovo come categoria fatturabile. Mantieni total_tokens come totale d'utilizzo e non come quantità da moltiplicare per una tariffa mista. Registra l'intero oggetto usage, così la riconciliazione successiva non dipende da un log incompleto e solo testuale.
| Campo Responses | Significato | Trattamento contabile |
|---|---|---|
| usage.input_tokens | Token totali d'input | Dividi input ordinario, letture e scritture cache |
| usage.input_tokens_details.cached_tokens | Token d'input memorizzati | Applica la tariffa dell'input in cache |
| usage.input_tokens_details.cache_write_tokens | Token d'input scritti nella cache | Applica la tariffa di scrittura cache |
| usage.output_tokens | Token di output inclusi quelli di reasoning | Applica una volta la tariffa output |
| usage.output_tokens_details.reasoning_tokens | Reasoning dentro l'output | Conservalo come sottoinsieme diagnostico |
| usage.total_tokens | Utilizzo totale di input e output | Conservalo per la riconciliazione |
Calcola il subtotale dei token senza doppio conteggio
Sia I il numero di token d'input, C l'input memorizzato, W l'input scritto nella cache e O i token di output. L'input ordinario è I - C - W. Con tariffe R_input, R_cached, R_write e R_output espresse nella stessa valuta per milione di token, il subtotale dei token è ((I - C - W) * R_input + C * R_cached + W * R_write + O * R_output) / 1,000,000.
La funzione offline seguente accetta utilizzo osservato e un listino selezionato separatamente. I nomi delle tariffe sono variabili applicative, non campi API. Restituisce null per input mancanti o incoerenti invece di trattare silenziosamente l'utilizzo sconosciuto come gratuito. Il risultato copre solo i token, non strumenti, imposte o altre voci di fattura.
function estimateTokenCost(usage, rates) {
  const I = usage?.input_tokens
  const C = usage?.input_tokens_details?.cached_tokens
  const W = usage?.input_tokens_details?.cache_write_tokens
  const O = usage?.output_tokens
  const tokens = [I, C, W, O]
  const prices = [rates?.input, rates?.cached, rates?.write, rates?.output]
  if (!tokens.every(n => Number.isSafeInteger(n) && n >= 0)) return null
  if (!prices.every(n => Number.isFinite(n) && n >= 0)) return null
  if (C > I || W > I - C) return null
  const subtotal = ((I - C - W) * rates.input
    + C * rates.cached + W * rates.write
    + O * rates.output) / 1_000_000
  return Number.isFinite(subtotal) ? subtotal : null
}
Risolvi per richiesta le regole di contesto e livello di servizio
I prezzi ufficiali Astra distinguono input ordinario, input memorizzato, scritture cache e output, con fasce di contesto e livelli di servizio diversi. Risolvi queste regole per ogni richiesta prima di fornire le tariffe alla formula. Non applicare di nuovo un moltiplicatore se hai già selezionato una riga del listino che lo include.
Conserva metadati di livello di servizio ed elaborazione insieme alla risposta e confrontali con quanto richiesto. Non riutilizzare moltiplicatori di velocità o crediti Codex in un calcolo API diretto: appartengono a un altro schema di prezzi. Per modalità di elaborazione insolite, riconcilia con i termini del provider applicabili. Una formula corretta dei token con la base tariffaria sbagliata resta una stima di costo errata.
Separa le stime dei token dai costi completi dell'attività
Un'attività può richiedere diverse richieste al modello, chiamate a strumenti e revisioni. Somma il subtotale dei token per ogni richiesta registrata, poi aggiungi separatamente strumenti o servizi del provider fatturati in base all'utilizzo e ai prezzi reali. Il fatto che un modello possa chiamare uno strumento non significa che quello strumento sia incluso senza costi aggiuntivi.
Mantieni infrastruttura, spese di generazione degli asset e tempo di revisione umana in categorie separate. Allega ricevute dei servizi e periodo coperto e assegna i costi condivisi in modo coerente tra le attività. Per un gioco, un batch di localizzazione o un'attività di ricerca, dichiara quali componenti include il totale. Separa imposte e conversioni valutarie dalle tariffe dei token per riconciliare sia il subtotale d'utilizzo sia l'importo finale pagato.
| Componente di costo | Prova da conservare | Regola di combinazione |
|---|---|---|
| Token del modello | Utilizzo Responses più tariffe API applicabili | Somma i subtotali delle richieste |
| Strumenti o servizi del provider | Utilizzo dello strumento e categoria di prezzo ufficiale | Aggiungi le voci fatturate separatamente |
| Altro runtime o asset | Ricevute e attribuzione del servizio | Riporta in categorie separate |
| Revisione umana | Tempo registrato e metodo di valorizzazione dichiarato | Mantieni distinto dalla spesa API |
Mantieni visibili retry, lavoro incompleto e utilizzo mancante
La guida OpenAI al reasoning avverte che una generazione incompleta può consumare token d'input e di reasoning senza produrre testo visibile. Conta l'utilizzo effettivamente restituito anche quando il risultato fallisce il controllo di accettazione. Non limitare il registro alle risposte finali riuscite e non stimare la spesa dalla sola lunghezza della risposta.
Per ogni tentativo conserva identità della risposta, modello, stato, utilizzo e attività di appartenenza. Riconcilia i duplicati prima di sommare. Se una connessione fallisce e non arriva utilizzo, marca il tentativo come irrisolto finché i record del provider non chiariscono la situazione; non sono dimostrati né costo zero né successo completo. Limita i retry affinché un guasto temporaneo non crei una serie non revisionata di tentativi fatturabili.
Metti a budget risultati accettati e lavoro circoscritto
Definisci l'unità di lavoro accettato prima di misurarla: una modifica di codice testata, un record prodotto-locale approvato o una nota di ricerca collegata alle fonti. Il costo per unità accettata è il costo attribuibile dell'attività diviso per il numero di unità accettate, solo quando il conteggio è diverso da zero. Riporta campione e utilizzo irrisolto insieme al rapporto.
Usa insieme un tetto alle richieste, retry limitati e una condizione di stop dell'attività. Il campo documentato max_output_tokens limita la generazione, incluso il reasoning, ma non costituisce un budget monetario completo per un'attività con più richieste. Imposta anche i controlli dell'account e traccia la spesa accumulata. Valuta contesto più piccolo o impostazioni di reasoning diverse rispetto agli stessi criteri di accettazione, non pubblicizzarli come risparmi garantiti.
Disponibilità del provider e prove: 5 settembre 2026
I campi d'utilizzo e la formula di questa guida provengono dalla documentazione ufficiale OpenAI. Per l'articolo non sono stati misurati costi o runtime di un'attività Astra. Il 5 settembre 2026 l'endpoint prezzi pubblico APIsRouter ha restituito HTTP 200, success: true e 34 modelli senza Astra o GPT-6; qui non esiste quindi un preventivo Astra di APIsRouter.
Usa i prezzi correnti OpenAI per richieste Astra dirette e il catalogo live APIsRouter per le sue offerte. Un confronto tra provider richiede attività corrispondenti, identità effettiva del modello, output accettati, utilizzo completo e tariffe applicabili. Conserva questi record con il calcolo, così i lettori distinguono una stima da una fattura riconciliata.
Domande frequenti
Qual è il prezzo API Astra corrente?
Usa la pagina ufficiale dei prezzi API OpenAI per gpt-6-astra. Seleziona livello di servizio e fascia di contesto applicabili alla richiesta, incluse tariffe separate per letture e scritture cache.
I token di reasoning vengono addebitati oltre a output_tokens?
I token di reasoning sono inclusi nell'utilizzo dell'output. Applica una volta la tariffa output a output_tokens; conserva output_tokens_details.reasoning_tokens per la diagnosi invece di sommarli nuovamente.
Come incidono le scritture cache sulla formula?
Sottrai cached_tokens e cache_write_tokens dall'input totale per ottenere l'input ordinario. Prezza separatamente input ordinario, letture cache e scritture cache con le tariffe ufficiali applicabili.
Un timeout o una risposta incompleta è gratuito?
Non necessariamente. Una generazione incompleta può consumare token e un timeout può lasciare irrisolta la prova di fatturazione. Conserva l'utilizzo restituito e riconcilia i record mancanti invece di assegnare costo zero.
Quanto costa un'attività Astra tramite APIsRouter?
Il controllo del 5 settembre 2026 non ha prodotto un preventivo perché Astra era assente dal catalogo. Controlla le offerte correnti e usa i prezzi OpenAI per le stime Astra dirette.