Coûts de l'API Astra : de l'utilisation au travail accepté
Updated 2026-09-05
Comptabilisez séparément les entrées ordinaires, les lectures de cache, les écritures de cache et la sortie. Utilisez le barème officiel actuel et un registre complet des requêtes pour estimer une tâche.
Choisissez le système de facturation avant le tarif
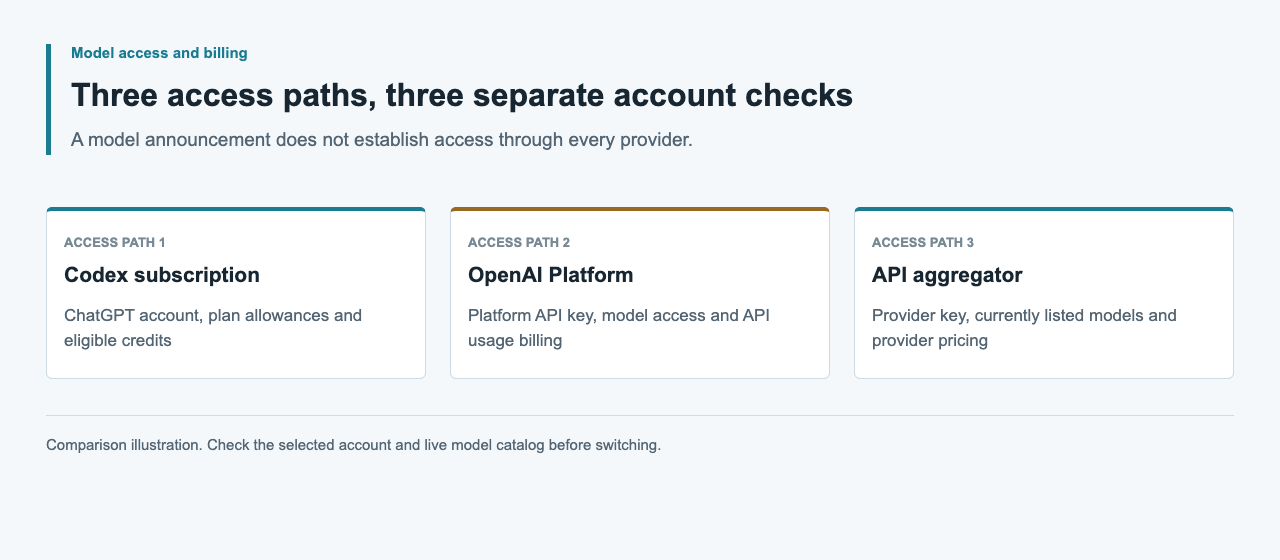
Les requêtes directes de l'API Astra utilisent la facturation OpenAI Platform. Le travail Codex authentifié par ChatGPT utilise les allocations et crédits d'un abonnement ou d'un espace de travail. OpenAI les publie séparément : le tarif d'un crédit Codex n'est donc pas un prix en dollars par token API et un tour inclus dans un abonnement n'est pas un reçu API.
Pour les requêtes directes, ouvrez la page officielle de tarification API et sélectionnez les tarifs gpt-6-astra applicables au niveau de service, à la bande de contexte et au mode de traitement. Conservez l'URL du barème et la date d'observation avec votre estimation. Construisez le calcul à partir de l'utilisation au niveau de la requête, puis comparez le total à vos enregistrements d'utilisation et à votre facture Platform. Les différences de sélection de tarif ou les requêtes manquantes seront ainsi plus faciles à localiser.
Capturez les champs d'utilisation exacts de Responses
Le guide officiel de mise en cache des prompts documente input_tokens, input_tokens_details.cached_tokens et input_tokens_details.cache_write_tokens. Les lectures de cache et les écritures de cache sont des catégories distinctes à l'intérieur des entrées ; soustrayez donc les deux avant de calculer les entrées ordinaires. Supposer que chaque token non mis en cache utilise le tarif d'entrée ordinaire peut sous-estimer une requête qui écrit dans un cache.
Le guide du raisonnement documente output_tokens et output_tokens_details.reasoning_tokens. Les tokens de raisonnement sont inclus dans l'utilisation de sortie ; ne les ajoutez pas une seconde fois comme catégorie de tokens facturée séparément. Conservez total_tokens comme total d'utilisation, et non comme un nombre à multiplier par un tarif unique mélangé. Enregistrez l'objet d'utilisation complet afin que le rapprochement ultérieur ne dépende pas d'un journal textuel incomplet.
| Champ Responses | Signification | Traitement comptable |
|---|---|---|
| usage.input_tokens | Total des tokens d'entrée | Séparer les entrées ordinaires, les lectures et les écritures de cache |
| usage.input_tokens_details.cached_tokens | Tokens d'entrée mis en cache | Appliquer le tarif des entrées en cache |
| usage.input_tokens_details.cache_write_tokens | Tokens d'entrée écrits dans le cache | Appliquer le tarif des écritures de cache |
| usage.output_tokens | Tokens de sortie, raisonnement compris | Appliquer le tarif de sortie une seule fois |
| usage.output_tokens_details.reasoning_tokens | Raisonnement compris dans la sortie | Conserver comme sous-ensemble diagnostique |
| usage.total_tokens | Total de l'utilisation des entrées et sorties | Conserver pour le rapprochement |
Calculez le sous-total des tokens sans double comptage
Soient I les tokens d'entrée, C les entrées mises en cache, W les entrées écrites dans le cache et O les tokens de sortie. Les entrées ordinaires sont I - C - W. Avec les tarifs R_input, R_cached, R_write et R_output exprimés dans la même devise par million de tokens, le sous-total des tokens est ((I - C - W) * R_input + C * R_cached + W * R_write + O * R_output) / 1,000,000.
La fonction hors ligne ci-dessous accepte l'utilisation observée et un barème sélectionné séparément. Ses noms de tarifs sont des variables d'application, et non des champs API. Elle renvoie null lorsque les entrées sont manquantes ou incohérentes, au lieu de traiter silencieusement l'utilisation inconnue comme gratuite. Le résultat couvre uniquement les tokens, pas les outils, les taxes ni les autres lignes de facture.
function estimateTokenCost(usage, rates) {
  const I = usage?.input_tokens
  const C = usage?.input_tokens_details?.cached_tokens
  const W = usage?.input_tokens_details?.cache_write_tokens
  const O = usage?.output_tokens
  const tokens = [I, C, W, O]
  const prices = [rates?.input, rates?.cached, rates?.write, rates?.output]
  if (!tokens.every(n => Number.isSafeInteger(n) && n >= 0)) return null
  if (!prices.every(n => Number.isFinite(n) && n >= 0)) return null
  if (C > I || W > I - C) return null
  const subtotal = ((I - C - W) * rates.input
    + C * rates.cached + W * rates.write
    + O * rates.output) / 1_000_000
  return Number.isFinite(subtotal) ? subtotal : null
}
Résolvez les règles de contexte et de niveau de service pour chaque requête
La tarification officielle d'Astra distingue les entrées ordinaires, les entrées mises en cache, les écritures de cache et la sortie, avec des bandes de contexte et des niveaux de service différents. Résolvez ces règles pour chaque requête avant de fournir les tarifs à la formule. N'appliquez pas une nouvelle fois un multiplicateur si vous avez déjà sélectionné une ligne du barème qui l'inclut.
Conservez les métadonnées du niveau de service et du traitement avec la réponse et comparez-les à ce qui a été demandé. Ne réutilisez pas les multiplicateurs de vitesse ou de crédits Codex pour un calcul d'API direct : ils appartiennent à un autre barème produit. Pour des modes de traitement inhabituels, rapprochez-vous des conditions applicables du fournisseur. Une formule correcte appliquée à une mauvaise base tarifaire reste une estimation de coût incorrecte.
Séparez les estimations de tokens du coût complet d'une tâche
Une tâche peut nécessiter plusieurs requêtes de modèle, appels d'outils et révisions. Additionnez le sous-total de tokens de chaque requête enregistrée, puis ajoutez séparément les outils ou services du fournisseur facturés selon leur utilisation et leur tarification réelles. La capacité d'un modèle à appeler un outil ne signifie pas que cet outil est inclus sans frais supplémentaires.
Gardez l'infrastructure, les dépenses de génération d'assets et le temps de revue humaine dans des catégories séparées. Joignez les reçus de service et la période qu'ils couvrent et répartissez les coûts partagés de manière cohérente entre les tâches. Pour un jeu, un lot de localisation ou une tâche de recherche, indiquez les composants inclus dans le total. Séparez les taxes et conversions de devises des tarifs de tokens afin de pouvoir rapprocher à la fois le sous-total d'utilisation et le montant final payé.
| Composant du coût | Preuve à conserver | Règle de combinaison |
|---|---|---|
| Tokens du modèle | Utilisation Responses et tarifs API applicables | Additionner les sous-totaux des requêtes |
| Outils ou services du fournisseur | Utilisation de l'outil et catégorie officielle de tarification | Ajouter les éléments facturés séparément |
| Autres éléments runtime ou assets | Reçus de service et attribution | Rendre compte dans des catégories séparées |
| Revue humaine | Temps enregistré et méthode de valorisation indiquée | Garder distinct de la dépense API |
Rendez visibles les nouvelles tentatives, le travail incomplet et l'utilisation manquante
Le guide du raisonnement d'OpenAI avertit qu'une génération incomplète peut consommer des tokens d'entrée et de raisonnement sans produire de texte visible. Comptez l'utilisation effectivement renvoyée même lorsque le résultat échoue au contrôle d'acceptation. Ne limitez pas le registre aux réponses finales réussies et n'estimez pas la dépense à partir de la seule longueur de la réponse.
Pour chaque tentative, conservez l'identité de la réponse, le modèle, le statut, l'utilisation et la tâche concernée. Rapprochez les doublons avant l'addition. Si une connexion échoue et qu'aucune utilisation n'arrive, marquez la tentative comme non résolue jusqu'à clarification des enregistrements du fournisseur ; ni un coût nul ni une réussite complète ne sont établis. Limitez les nouvelles tentatives afin qu'une panne temporaire ne crée pas une série de tentatives facturables non relues.
Budgez autour des résultats acceptés et d'un travail délimité
Définissez l'unité de travail acceptée avant de la mesurer : changement de code testé, enregistrement produit-locale approuvé ou note de recherche liée aux sources. Le coût par unité acceptée est le coût de tâche attribuable divisé par le nombre d'unités acceptées, uniquement lorsque ce nombre est non nul. Présentez l'échantillon et l'utilisation non résolue à côté du ratio.
Utilisez ensemble un plafond de requêtes, des nouvelles tentatives limitées et une condition d'arrêt de la tâche. Le champ documenté max_output_tokens limite la génération, raisonnement compris, mais ne constitue pas un budget monétaire complet pour une tâche à plusieurs requêtes. Définissez aussi les contrôles du compte et suivez la dépense cumulée. Évaluez un contexte plus petit ou des paramètres de raisonnement différents avec les mêmes critères d'acceptation, et ne les présentez pas comme des économies garanties.
Disponibilité du fournisseur et preuves : 5 septembre 2026
Les champs d'utilisation et la formule de ce guide proviennent de la documentation officielle OpenAI. Aucun coût ni runtime de tâche Astra n'a été mesuré pour l'article. Le 5 septembre 2026, l'endpoint public de tarification APIsRouter a renvoyé HTTP 200, success: true et 34 modèles sans Astra ni GPT-6 ; aucun tarif APIsRouter Astra ne figure donc ici.
Utilisez la tarification OpenAI actuelle pour les requêtes directes Astra et le catalogue APIsRouter en direct pour ses propres offres. Une comparaison de fournisseurs exige des tâches comparables, l'identité réelle du modèle, des sorties acceptées, une utilisation complète et les tarifs applicables. Conservez ces éléments avec le calcul afin que les lecteurs puissent distinguer une estimation d'une facture de tâche rapprochée.
Questions fréquentes
Quel est le prix actuel de l'API Astra ?
Utilisez la page officielle de tarification API OpenAI pour gpt-6-astra. Sélectionnez le niveau de service et la bande de contexte correspondant à votre requête, avec des tarifs distincts pour la lecture et l'écriture du cache.
Les tokens de raisonnement sont-ils facturés en plus de output_tokens ?
Les tokens de raisonnement sont inclus dans l'utilisation de sortie. Appliquez une seule fois le tarif de sortie à output_tokens ; conservez output_tokens_details.reasoning_tokens pour le diagnostic au lieu de l'ajouter une seconde fois.
Comment les écritures de cache affectent-elles la formule ?
Soustrayez cached_tokens et cache_write_tokens du total des entrées pour obtenir les entrées ordinaires. Tarifez séparément les entrées ordinaires, les lectures de cache et les écritures de cache selon les tarifs officiels applicables.
Un délai d'attente ou une réponse incomplète est-il gratuit ?
Pas nécessairement. Une génération incomplète peut consommer des tokens et un délai d'attente peut laisser la preuve de facturation non résolue. Conservez l'utilisation renvoyée et rapprochez les enregistrements manquants au lieu d'attribuer un coût nul.
Combien coûte une tâche Astra via APIsRouter ?
Le contrôle du 5 septembre 2026 ne fournit aucun tarif, car Astra était absent du catalogue. Vérifiez les offres actuelles et utilisez la tarification OpenAI pour les estimations directes Astra.