Costes de la API de Astra: del uso al trabajo aceptado
Updated 2026-09-05
Contabiliza por separado la entrada normal, las lecturas de caché, las escrituras de caché y la salida. Usa la tarjeta oficial de tarifas actual y un registro completo de solicitudes para estimar una tarea.
Elige el sistema de facturación antes que la tarifa
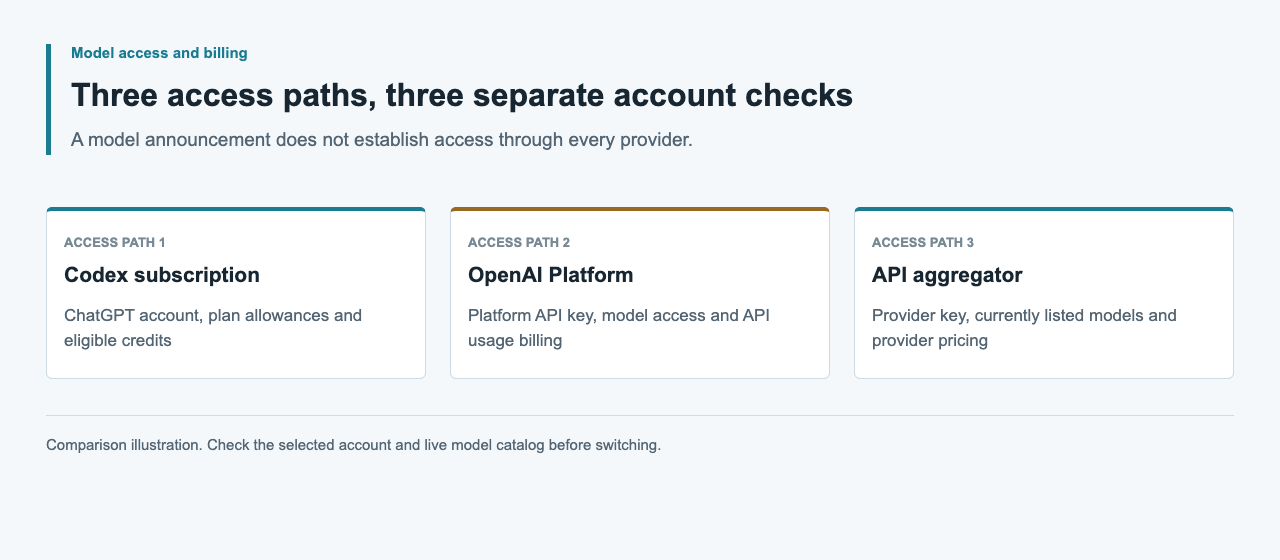
Las solicitudes directas a la API de Astra usan la facturación de OpenAI Platform. El trabajo de Codex autenticado con ChatGPT usa asignaciones y créditos de suscripción o del espacio de trabajo. OpenAI los publica por separado, así que una tarifa de crédito de Codex no es un precio en dólares por token de API y un turno incluido de suscripción no es un recibo de API.
Para solicitudes directas, abre la página oficial de precios de la API y selecciona las tarifas aplicables de gpt-6-astra según el nivel de servicio, la banda de contexto y el tipo de procesamiento. Conserva la URL de la tarjeta de tarifas y la fecha de observación junto a tu estimación. Construye el cálculo a partir del uso de cada solicitud y compara después el total con los registros de uso y la factura de Platform. Así será más fácil localizar diferencias en la selección de tarifas o solicitudes ausentes.
Captura los campos exactos de uso de Responses
La guía oficial de prompt caching documenta input_tokens, input_tokens_details.cached_tokens e input_tokens_details.cache_write_tokens. Las lecturas de caché y las escrituras de caché son categorías separadas dentro de la entrada, así que resta ambas antes de calcular la entrada normal. Suponer que cada token sin caché tiene la tarifa de entrada normal puede subestimar una solicitud que escribe en caché.
La guía de razonamiento documenta output_tokens y output_tokens_details.reasoning_tokens. Los tokens de razonamiento están incluidos en el uso de salida; no los sumes de nuevo como otra categoría de tokens facturables. Conserva total_tokens como total de uso, no como una cantidad que deba multiplicarse por una tarifa combinada. Registra el objeto de uso completo para que la conciliación posterior no dependa de un log de texto incompleto.
| Campo de Responses | Significado | Tratamiento contable |
|---|---|---|
| usage.input_tokens | Tokens de entrada totales | Separa la entrada normal, las lecturas y las escrituras de caché |
| Campo usage.input_tokens_details.cached_tokens | Tokens de entrada en caché | Aplica la tarifa de entrada en caché |
| Campo usage.input_tokens_details.cache_write_tokens | Tokens de entrada escritos en caché | Aplica la tarifa de escritura en caché |
| usage.output_tokens | Tokens de salida, incluido el razonamiento | Aplica la tarifa de salida una sola vez |
| Campo usage.output_tokens_details.reasoning_tokens | Razonamiento dentro de la salida | Conserva este subconjunto de diagnóstico |
| usage.total_tokens | Uso total de entrada y salida | Conserva para la conciliación |
Calcula el subtotal de tokens sin contar dos veces
Sea I el número de tokens de entrada, C la entrada en caché, W la entrada escrita en caché y O los tokens de salida. La entrada normal es I - C - W. Con las tarifas R_input, R_cached, R_write y R_output expresadas en la misma moneda por millón de tokens, el subtotal de tokens es ((I - C - W) * R_input + C * R_cached + W * R_write + O * R_output) / 1,000,000.
La función offline de abajo acepta el uso observado y una tarjeta de tarifas seleccionada por separado. Sus nombres de tarifa son variables de la aplicación, no campos de la API. Devuelve null cuando faltan datos o son inconsistentes, en lugar de tratar silenciosamente el uso desconocido como gratuito. El resultado cubre solo tokens, no herramientas, impuestos ni otros conceptos de la factura.
function estimateTokenCost(usage, rates) {
  const I = usage?.input_tokens
  const C = usage?.input_tokens_details?.cached_tokens
  const W = usage?.input_tokens_details?.cache_write_tokens
  const O = usage?.output_tokens
  const tokens = [I, C, W, O]
  const prices = [rates?.input, rates?.cached, rates?.write, rates?.output]
  if (!tokens.every(n => Number.isSafeInteger(n) && n >= 0)) return null
  if (!prices.every(n => Number.isFinite(n) && n >= 0)) return null
  if (C > I || W > I - C) return null
  const subtotal = ((I - C - W) * rates.input
    + C * rates.cached + W * rates.write
    + O * rates.output) / 1_000_000
  return Number.isFinite(subtotal) ? subtotal : null
}
Resuelve las reglas de contexto y nivel de servicio por solicitud
Los precios oficiales de Astra distinguen la entrada normal, la entrada en caché, las escrituras de caché y la salida, con distintas bandas de contexto y niveles de servicio. Resuelve esas reglas para cada solicitud antes de proporcionar las tarifas a la fórmula. No vuelvas a aplicar un multiplicador si ya has seleccionado una fila de la tarjeta de tarifas que lo incluye.
Conserva los metadatos del nivel de servicio y del procesamiento junto a la respuesta y compáralos con lo solicitado. No reutilices los multiplicadores de velocidad o créditos de Codex para un cálculo directo de la API: pertenecen a otro calendario de precios del producto. Para tipos de procesamiento inusuales, concilia con las condiciones aplicables del proveedor. Una fórmula correcta de tokens con una base de tarifas equivocada sigue dando una estimación incorrecta del coste.
Separa las estimaciones de tokens de los costes completos de la tarea
Una tarea puede requerir varias solicitudes al modelo, llamadas a herramientas y revisiones. Suma el subtotal de tokens de cada solicitud registrada y añade después las herramientas o servicios del proveedor facturados por separado según su uso y precio reales. Que un modelo pueda llamar a una herramienta no significa que esa herramienta esté incluida sin coste adicional.
Mantén en categorías separadas la infraestructura, los gastos de generación de recursos y el tiempo de revisión humana. Adjunta los recibos de los servicios y el periodo que cubren, y asigna los costes compartidos de forma coherente entre las tareas. Para un juego, un lote de localización o una tarea de investigación, indica qué componentes incluye el total. Separa los impuestos y las conversiones de moneda de las tarifas de tokens para poder conciliar tanto el subtotal de uso como el importe final pagado.
| Componente del coste | Evidencia que conservar | Regla de combinación |
|---|---|---|
| Tokens del modelo | Uso de Responses más las tarifas aplicables de la API | Suma los subtotales de las solicitudes |
| Herramientas o servicios del proveedor | Uso de la herramienta y categoría de precios oficial | Añade los conceptos facturados por separado |
| Otros recursos o tiempo de ejecución | Recibos de servicios y atribución | Informa en categorías separadas |
| Revisión humana | Tiempo registrado y método de valoración indicado | Mantén separado del gasto de API |
Haz visibles los reintentos, el trabajo incompleto y el uso ausente
La guía de razonamiento de OpenAI advierte que una generación incompleta puede consumir tokens de entrada y de razonamiento sin producir texto visible. Cuenta el uso que se devuelva realmente incluso cuando el resultado no supere tu comprobación de aceptación. No limites el registro a las respuestas finales correctas ni estimes el gasto solo por la longitud de la respuesta.
En cada intento, conserva la identidad de la respuesta, el modelo, el estado, el uso y la tarea a la que pertenece. Concilia los duplicados antes de sumar. Si falla la conexión y no llega ningún dato de uso, marca el intento como no resuelto hasta que los registros del proveedor lo aclaren; no se demuestra ni un coste cero ni un éxito completo. Limita los reintentos para que un fallo temporal no genere una serie no revisada de intentos facturables.
Presupuesta alrededor de resultados aceptados y trabajo acotado
Define la unidad de trabajo aceptado antes de medirla: un cambio de código probado, un registro de producto y locale aprobado o una nota de investigación enlazada a fuentes. El coste por unidad aceptada es el coste atribuible de la tarea dividido por el número de unidades aceptadas, únicamente cuando ese número sea distinto de cero. Informa junto al cociente de la muestra y del uso no resuelto.
Usa conjuntamente un techo de solicitudes, reintentos acotados y una condición de parada de la tarea. El campo documentado max_output_tokens limita la generación, incluido el razonamiento, pero no es un presupuesto monetario completo para una tarea con varias solicitudes. Configura también controles de cuenta y sigue el gasto acumulado. Un contexto más pequeño o ajustes distintos de razonamiento deben evaluarse con los mismos criterios de aceptación, no anunciarse como ahorros garantizados.
Disponibilidad del proveedor y evidencia: 5 de septiembre de 2026
Los campos de uso y la fórmula de esta guía proceden de la documentación oficial de OpenAI. Para el artículo no se midió ningún coste ni tiempo de ejecución de una tarea con Astra. El 5 de septiembre de 2026, el endpoint público de precios de APIsRouter devolvió HTTP 200, success: true y 34 modelos sin Astra ni GPT-6, por lo que aquí no existe una cotización de Astra en APIsRouter.
Usa los precios actuales de OpenAI para solicitudes directas de Astra y el catálogo en vivo de APIsRouter para sus propias ofertas. Una comparación entre proveedores necesita tareas equivalentes, identidad real del modelo, resultados aceptados, uso completo y tarifas aplicables. Conserva esos registros junto al cálculo para que los lectores puedan distinguir una estimación de una factura de tarea conciliada.
Preguntas frecuentes
¿Cuál es el precio actual de la API de Astra?
Usa la página oficial de precios de la API de OpenAI para gpt-6-astra. Selecciona el nivel de servicio y la banda de contexto aplicables a tu solicitud, incluidas las tarifas separadas de lectura y escritura de caché.
¿Se cobran los tokens de razonamiento además de output_tokens?
Los tokens de razonamiento están incluidos en el uso de salida. Aplica una sola vez la tarifa de salida a output_tokens y conserva output_tokens_details.reasoning_tokens para el diagnóstico, sin volver a sumarlos.
¿Cómo afectan las escrituras de caché a la fórmula?
Resta cached_tokens y cache_write_tokens de la entrada total para obtener la entrada normal. Calcula por separado el precio de la entrada normal, las lecturas de caché y las escrituras de caché con las tarifas oficiales aplicables.
¿Un timeout o una respuesta incompleta son gratuitos?
No necesariamente. Una generación incompleta puede consumir tokens y un timeout puede dejar sin resolver la evidencia de facturación. Conserva el uso devuelto y concilia los registros ausentes en lugar de asignar un coste cero.
¿Cuánto cuesta una tarea de Astra mediante APIsRouter?
No hay una cotización de la comprobación del 5 de septiembre de 2026 porque Astra no aparecía en el catálogo. Consulta las ofertas actuales y usa los precios de OpenAI para estimaciones directas de Astra.