Astra-API-Kosten von der Nutzung bis zur akzeptierten Arbeit
Updated 2026-09-05
Rechnen Sie normale Eingaben, Cache-Lesevorgänge, Cache-Schreibvorgänge und Ausgaben getrennt ab. Verwenden Sie die aktuelle offizielle Preisliste und ein vollständiges Anfrageprotokoll, um eine Aufgabe zu schätzen.
Wählen Sie das Abrechnungssystem vor dem Tarif
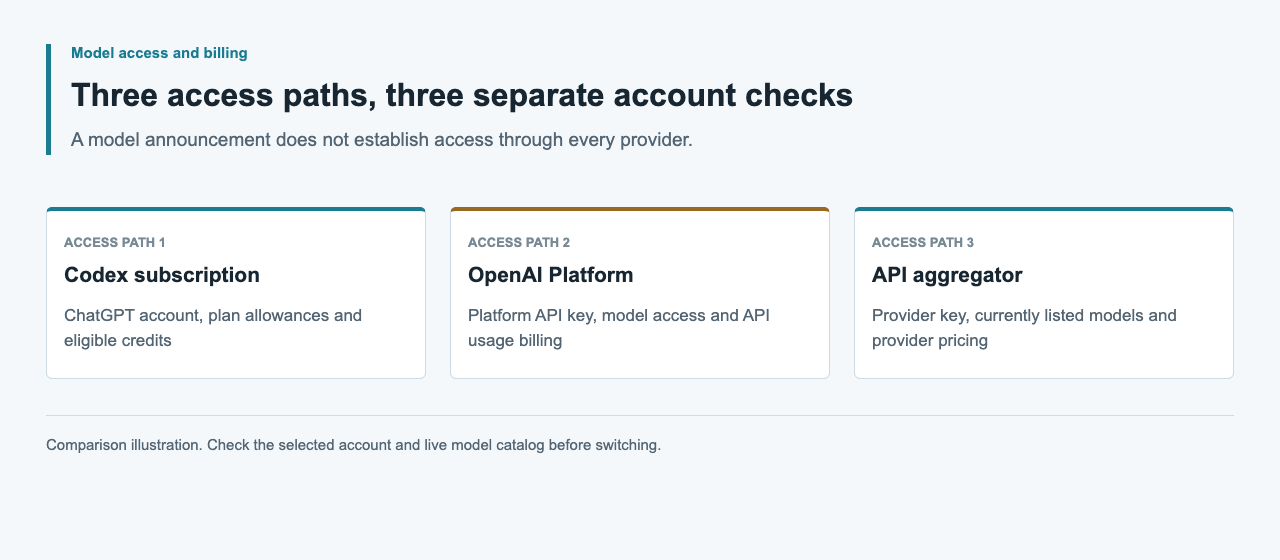
Direkte Astra-API-Anfragen werden über die OpenAI-Platform abgerechnet. Mit ChatGPT authentifizierte Codex-Arbeit nutzt Abonnement- oder Workspace-Kontingente und Credits. OpenAI veröffentlicht diese getrennt. Ein Codex-Credittarif ist daher kein Dollarpreis pro API-Token und ein enthaltener Abonnementdurchlauf ist kein API-Abrechnungsbeleg.
Öffnen Sie für direkte Anfragen die offizielle API-Preisseite und wählen Sie die geltenden gpt-6-astra-Tarife für Dienststufe, Kontextband und Verarbeitungsart. Bewahren Sie URL und Beobachtungsdatum der Preisliste mit Ihrer Schätzung auf. Bauen Sie die Berechnung aus der Nutzung auf Anfrageebene auf und vergleichen Sie die Summe anschließend mit Ihren Platform-Nutzungsdatensätzen und Ihrer Rechnung. So lassen sich Unterschiede bei der Tarifauswahl oder fehlende Anfragen leichter lokalisieren.
Erfassen Sie die exakten Responses-Nutzungsfelder
Der offizielle Leitfaden zum Prompt-Caching dokumentiert input_tokens, input_tokens_details.cached_tokens und input_tokens_details.cache_write_tokens. Gecachte Lesevorgänge und Cache-Schreibvorgänge sind getrennte Kategorien innerhalb der Eingabe. Ziehen Sie daher beide ab, bevor Sie die normale Eingabe berechnen. Wenn Sie annehmen, jedes nicht gecachte Token habe den normalen Eingabetarif, können Sie eine Anfrage, die einen Cache schreibt, zu niedrig ansetzen.
Der Reasoning-Leitfaden dokumentiert output_tokens und output_tokens_details.reasoning_tokens. Reasoning-Tokens sind in der Ausgabenutzung enthalten; addieren Sie sie nicht noch einmal als eigene abgerechnete Tokenkategorie. Behandeln Sie total_tokens als Nutzungsumme und nicht als Zahl, die mit einem gemischten Tarif multipliziert wird. Speichern Sie das vollständige Nutzungsobjekt, damit der spätere Abgleich nicht von einem unvollständigen Nur-Text-Log abhängt.
| Responses-Feld | Bedeutung | Abrechnungsbehandlung |
|---|---|---|
| usage.input_tokens | Gesamte Eingabetokens | Normale Eingabe, Cache-Lesevorgänge und Schreibvorgänge aufteilen |
| usage.input_tokens_details.cached_tokens | Gecachte Eingabetokens | Cache-Eingabetarif anwenden |
| usage.input_tokens_details.cache_write_tokens | In den Cache geschriebene Eingabetokens | Cache-Schreibtarif anwenden |
| usage.output_tokens | Ausgabetokens einschließlich Reasoning | Ausgabetarif einmal anwenden |
| usage.output_tokens_details.reasoning_tokens | Reasoning innerhalb der Ausgabe | Als diagnostische Teilmenge bewahren |
| usage.total_tokens | Gesamte Eingabe- und Ausgabenutzung | Für den Abgleich bewahren |
Berechnen Sie die Tokenzwischensumme ohne Doppelzählung
Sei I die Zahl der Eingabetokens, C die gecachte Eingabe, W die Cache-Schreib-Eingabe und O die Ausgabetokens. Die normale Eingabe ist I - C - W. Bei den Tarifen R_input, R_cached, R_write und R_output, die in derselben Währung pro einer Million Tokens angegeben sind, lautet die Tokenzwischensumme ((I - C - W) * R_input + C * R_cached + W * R_write + O * R_output) / 1,000,000.
Die folgende Offline-Funktion akzeptiert beobachtete Nutzung und eine separat ausgewählte Preisliste. Ihre Tarifnamen sind Anwendungsvariablen und keine API-Felder. Bei fehlenden oder inkonsistenten Eingaben gibt sie null zurück, statt unbekannte Nutzung stillschweigend als kostenlos zu behandeln. Das Ergebnis deckt nur Tokens ab und nicht Tools, Steuern oder andere Rechnungsposten.
function estimateTokenCost(usage, rates) {
  const I = usage?.input_tokens
  const C = usage?.input_tokens_details?.cached_tokens
  const W = usage?.input_tokens_details?.cache_write_tokens
  const O = usage?.output_tokens
  const tokens = [I, C, W, O]
  const prices = [rates?.input, rates?.cached, rates?.write, rates?.output]
  if (!tokens.every(n => Number.isSafeInteger(n) && n >= 0)) return null
  if (!prices.every(n => Number.isFinite(n) && n >= 0)) return null
  if (C > I || W > I - C) return null
  const subtotal = ((I - C - W) * rates.input
    + C * rates.cached + W * rates.write
    + O * rates.output) / 1_000_000
  return Number.isFinite(subtotal) ? subtotal : null
}
Lösen Sie Kontext- und Dienststufenregeln pro Anfrage auf
Die offizielle Preisgestaltung von Astra unterscheidet normale Eingabe, gecachte Eingabe, Cache-Schreibvorgänge und Ausgabe mit unterschiedlichen Kontextbändern und Dienststufen. Lösen Sie diese Regeln für jede Anfrage auf, bevor Sie der Formel Tarife übergeben. Wenden Sie keinen Multiplikator erneut an, wenn Sie bereits eine Zeile der Preisliste ausgewählt haben, die ihn enthält.
Bewahren Sie Dienststufe und Verarbeitungsmetadaten mit der Antwort auf und vergleichen Sie sie mit dem, was angefordert wurde. Verwenden Sie Codex-Geschwindigkeits- oder Credit-Multiplikatoren nicht für eine direkte API-Berechnung erneut: Sie gehören zu einem anderen Produktpreisschema. Gleichen Sie bei ungewöhnlichen Verarbeitungsarten mit den geltenden Anbieterbedingungen ab. Eine korrekte Tokenformel mit der falschen Tarifgrundlage bleibt eine falsche Kostenschätzung.
Trennen Sie Tokenschätzungen von vollständigen Aufgabenkosten
Eine Aufgabe kann mehrere Modellanfragen, Tool-Aufrufe und Revisionen erfordern. Addieren Sie die Tokenzwischensumme jeder protokollierten Anfrage und anschließend separat abgerechnete Anbieter-Tools oder -Dienste nach ihrer tatsächlichen Nutzung und Preisgestaltung. Dass ein Modell ein Tool aufrufen kann, bedeutet nicht, dass dieses Tool ohne zusätzliche Gebühren enthalten ist.
Halten Sie Infrastruktur, Ausgaben für Asset-Generierung und Zeit der menschlichen Prüfung in getrennten Kategorien. Hängen Sie Dienstbelege und den von ihnen abgedeckten Zeitraum an und verteilen Sie gemeinsame Kosten konsistent auf Aufgaben. Geben Sie für ein Spiel, eine Lokalisierungscharge oder eine Research-Aufgabe an, welche Komponenten die Summe enthält. Trennen Sie Steuern und Währungsumrechnungen von den Tokentarifen, damit Sie sowohl die Nutzungszwischensumme als auch den letztlich gezahlten Betrag abgleichen können.
| Kostenkomponente | Zu bewahrender Beleg | Kombinationsregel |
|---|---|---|
| Modelltokens | Responses-Nutzung plus geltende API-Tarife | Anfragezwischensummen addieren |
| Anbieter-Tools oder -Dienste | Tool-Nutzung und offizielle Preiskategorie | Separat abgerechnete Positionen addieren |
| Sonstige Laufzeit oder Assets | Dienstbelege und Zuordnung | In getrennten Kategorien berichten |
| Menschliche Prüfung | Erfasste Zeit und angegebene Bewertungsmethode | Von API-Ausgaben getrennt halten |
Halten Sie Wiederholungen, unvollständige Arbeit und fehlende Nutzung sichtbar
Der Reasoning-Leitfaden von OpenAI weist darauf hin, dass eine unvollständige Generierung Eingabe- und Reasoning-Tokens verbrauchen kann, ohne sichtbaren Text zu erzeugen. Zählen Sie tatsächlich zurückgegebene Nutzung auch dann, wenn das Ergebnis Ihre Abnahmeprüfung nicht besteht. Beschränken Sie das Protokoll nicht auf erfolgreiche Endantworten und schätzen Sie Ausgaben nicht allein anhand der Antwortlänge.
Bewahren Sie für jeden Versuch Antwortidentität, Modell, Status, Nutzung und die zugehörige Aufgabe auf. Gleichen Sie Duplikate vor der Summierung ab. Wenn eine Verbindung fehlschlägt und keine Nutzung eintrifft, markieren Sie den Versuch als ungeklärt, bis Anbieteraufzeichnungen Klarheit schaffen; weder Nullkosten noch vollständiger Erfolg sind damit belegt. Begrenzen Sie Wiederholungen, damit ein vorübergehender Fehler keine ungeprüfte Serie abrechenbarer Versuche erzeugen kann.
Budgetieren Sie um akzeptierte Ergebnisse und begrenzte Arbeit herum
Definieren Sie die Einheit akzeptierter Arbeit, bevor Sie sie messen: eine getestete Codeänderung, ein freigegebener Produkt-Locale-Datensatz oder eine quellenverknüpfte Research-Notiz. Die Kosten pro akzeptierter Einheit sind die zurechenbaren Aufgabenkosten geteilt durch die Zahl akzeptierter Einheiten, und zwar nur, wenn diese Zahl ungleich null ist. Berichten Sie Stichprobe und ungeklärte Nutzung zusammen mit dem Verhältnis.
Verwenden Sie gemeinsam eine Anfrageobergrenze, begrenzte Wiederholungen und eine Stopbedingung für die Aufgabe. Das dokumentierte Feld max_output_tokens begrenzt die Generierung einschließlich Reasoning, ist aber kein vollständiges Währungsbudget für eine Aufgabe mit mehreren Anfragen. Setzen Sie auch Kontrollen auf Kontoebene und verfolgen Sie kumulierte Ausgaben. Bewerten Sie kleineren Kontext oder andere Reasoning-Einstellungen anhand derselben Abnahmekriterien und bewerben Sie sie nicht als garantierte Einsparungen.
Verfügbarkeit des Anbieters und Belege: 5. September 2026
Die Nutzungsfelder und die Formel dieses Leitfadens stammen aus der offiziellen OpenAI-Dokumentation. Für den Artikel wurden weder Astra-Aufgabenkosten noch Laufzeit gemessen. Am 5. September 2026 gab der öffentliche APIsRouter-Preisendpunkt HTTP 200, success: true und 34 Modelle ohne Astra oder GPT-6 zurück. Daher gibt es hier kein APIsRouter-Astra-Angebot.
Verwenden Sie für direkte Astra-Anfragen die aktuellen OpenAI-Preise und für eigene Angebote den Live-APIsRouter-Katalog. Ein Anbietervergleich benötigt übereinstimmende Aufgaben, tatsächliche Modellidentität, akzeptierte Ausgaben, vollständige Nutzung und geltende Tarife. Bewahren Sie diese Datensätze bei der Berechnung auf, damit Leser eine Schätzung von einer abgeglichenen Aufgabenrechnung unterscheiden können.
Häufige Fragen
Wie hoch ist der aktuelle Astra-API-Preis?
Verwenden Sie die offizielle OpenAI-API-Preisseite für gpt-6-astra. Wählen Sie die für Ihre Anfrage geltende Dienststufe und das Kontextband einschließlich separater Tarife für Cache-Lese- und Cache-Schreibvorgänge.
Werden Reasoning-Tokens zusätzlich zu output_tokens berechnet?
Reasoning-Tokens sind in der Ausgabenutzung enthalten. Wenden Sie den Ausgabetarif einmal auf output_tokens an und bewahren Sie output_tokens_details.reasoning_tokens zur Diagnose auf, statt sie erneut zu addieren.
Wie beeinflussen Cache-Schreibvorgänge die Formel?
Ziehen Sie cached_tokens und cache_write_tokens von der gesamten Eingabe ab, um die normale Eingabe zu erhalten. Bepreisen Sie normale Eingabe, Cache-Lesevorgänge und Cache-Schreibvorgänge getrennt mit den geltenden offiziellen Tarifen.
Ist ein Timeout oder eine unvollständige Antwort kostenlos?
Nicht unbedingt. Eine unvollständige Generierung kann Tokens verbrauchen und ein Timeout kann Abrechnungsbelege ungeklärt lassen. Bewahren Sie zurückgegebene Nutzung auf und gleichen Sie fehlende Datensätze ab, statt Nullkosten zuzuweisen.
Wie viel kostet eine Astra-Aufgabe über APIsRouter?
Aus der Prüfung vom 5. September 2026 gibt es kein Angebot, weil Astra im Katalog fehlte. Prüfen Sie aktuelle Angebote und verwenden Sie für direkte Astra-Schätzungen die OpenAI-Preise.